Benyou Wang: لماذا ندرّب نموذجًا كبيرًا مخصصًا لطب الأسنان
على مدى السنوات الثلاث الماضية، شاركتُ في أبحاث النماذج الطبية الكبيرة: من HuatuoGPT وHuatuoGPT-II، إلى HuatuoGPT-Vision القادر على قراءة الصور الطبية، ثم HuatuoGPT-o1 الذي يتعامل مع الاستدلال الطبي المعقد. ومنذ أن اتجهنا إلى صحة الفم والأسنان، صار السؤال الأكثر تكرارًا: إذا كانت النماذج العامة تزداد قوة، فلماذا ندرّب نموذجًا مخصصًا لطب الأسنان؟
جوابي: في طب الأسنان، «العام» لا يكفي. ولن أطرح رأيًا، بل سأكتفي بالبيانات الواردة في أبحاثنا.
أولًا: طب الأسنان نقطة عمياء تقريبًا في البيانات العامة
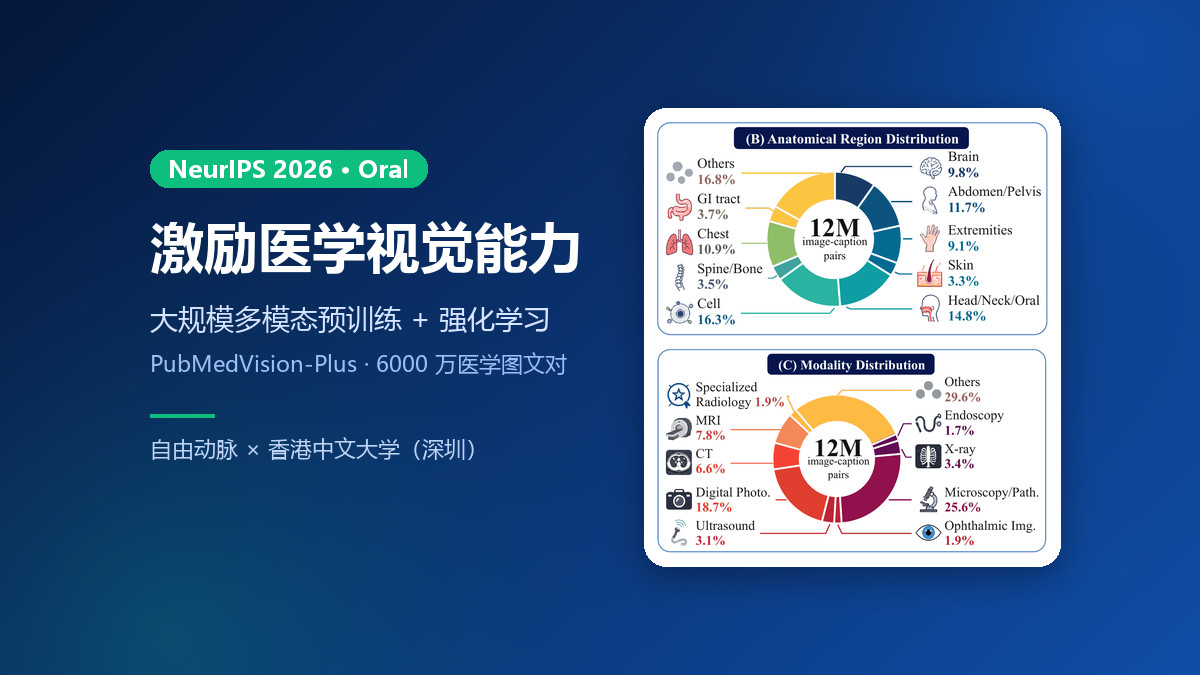
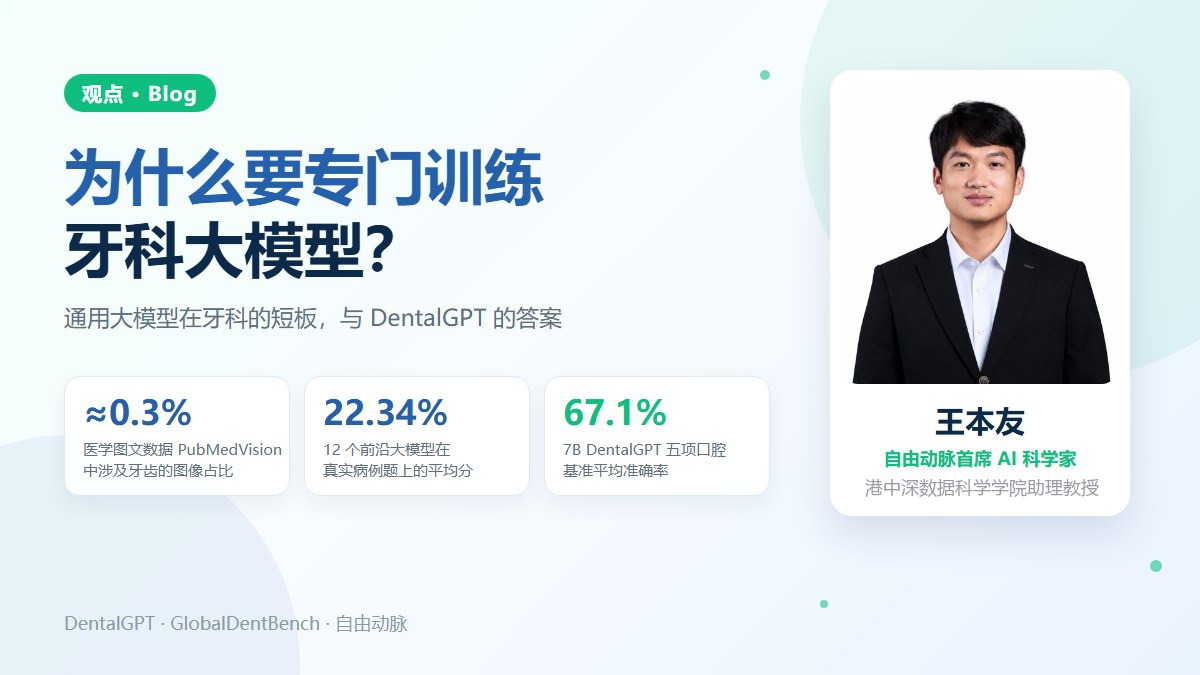
تأتي قدرات النموذج الكبير من بياناته، وطب الأسنان لا يشغل إلا حيزًا ضئيلًا من البيانات العامة. فقد أحصينا في النسخة الأولية من بحث DentalGPT أن الصور المتعلقة بالأسنان في PubMedVision، وهي مجموعة بيانات طبية ضخمة من الصور والنصوص، لا تتجاوز نحو 0.3%.
ثم إن صور الأسنان دقيقة التفاصيل. فالصورة الشعاعية البانورامية تعرض الأسنان كلها، بينما تشغل الحشوات وعلاجات قناة الجذر والأسنان المنطمرة والآفات حول الذروية جزءًا صغيرًا منها في الغالب. ولكل من الصور داخل الفم والصور الشعاعية الذروية والصور السيفالومترية الجانبية والتصوير المقطعي المخروطي (CBCT) طريقتها الخاصة في القراءة. والنموذج الذي نادرًا ما رأى هذه الصور لا يُتوقع منه أن يفهمها.
ثانيًا: النماذج العامة «ترى» لكنها تخطئ في العد والحكم
في MMOral-OPG-Bench، وهو معيار للأسئلة والأجوبة حول الصور البانورامية، لم تتجاوز دقة النماذج الرائدة مثل GPT-5 وGemini-2.5-Pro وClaude-Sonnet-4.5 نسبة 60%. ووجدنا أيضًا أن تفعيل «وضع التفكير» يحسّن أداءها في مهام طب الأسنان بقدر أقل بوضوح مما يحدث في المجالات الطبية الأخرى.
يورد بحث DentalGPT مثالًا معبّرًا: طُلب من النماذج عدّ الأسنان المحشوة في صورة بانورامية، والإجابة الصحيحة 10. أجاب GPT-5 بنحو 6، وعدّت النسخة غير المفكّرة من Qwen3-VL-235B ستة عشر سنًا، بينما توقفت النسخة المفكّرة عند 8 بعد مراجعة نفسها مرارًا. تجد النماذج المؤشرات البصرية ذات الصلة، لكنها لا تصل منها إلى الإجابة الصحيحة. فالمشكلة ليست في «عدم الرؤية» فحسب، بل في غياب القدرة على ربط التفاصيل البصرية بمعرفة طب الأسنان.
ثالثًا: كلما اقتربنا من الحالات الحقيقية، ازدادت صعوبة الأمر على النموذج
لكشف مواطن الضعف هذه، بنينا مع خبراء طب الأسنان حول العالم معيار التقييم GlobalDentBench: 8,978 سؤالًا تحقق منها خبراء، مصدرها 88 دولة ومنطقة و14 تخصصًا في طب الأسنان. وعلى 12 نموذجًا رائدًا، جاءت النتائج واضحة:
- كلما اقترب السؤال من الممارسة السريرية الفعلية، انخفضت الدرجة: بلغ متوسط أسئلة الاختيار من متعدد 81.34%، وأسئلة الإجابة القصيرة 64.53%، أما أسئلة الحالات المأخوذة من تقارير حالات حقيقية فلم تتجاوز 22.34%.
- كلما احتاج الحكم إلى تخصيص أكبر، ازدادت الصعوبة: انخفض متوسط الدرجات من 74.01% في «استرجاع المعرفة» إلى 55.64% في «الاستدلال الروتيني»، ثم إلى 35.71% في «الاستدلال المخصص»، وجاءت جميع النماذج دون 50% في الاستدلال المخصص.
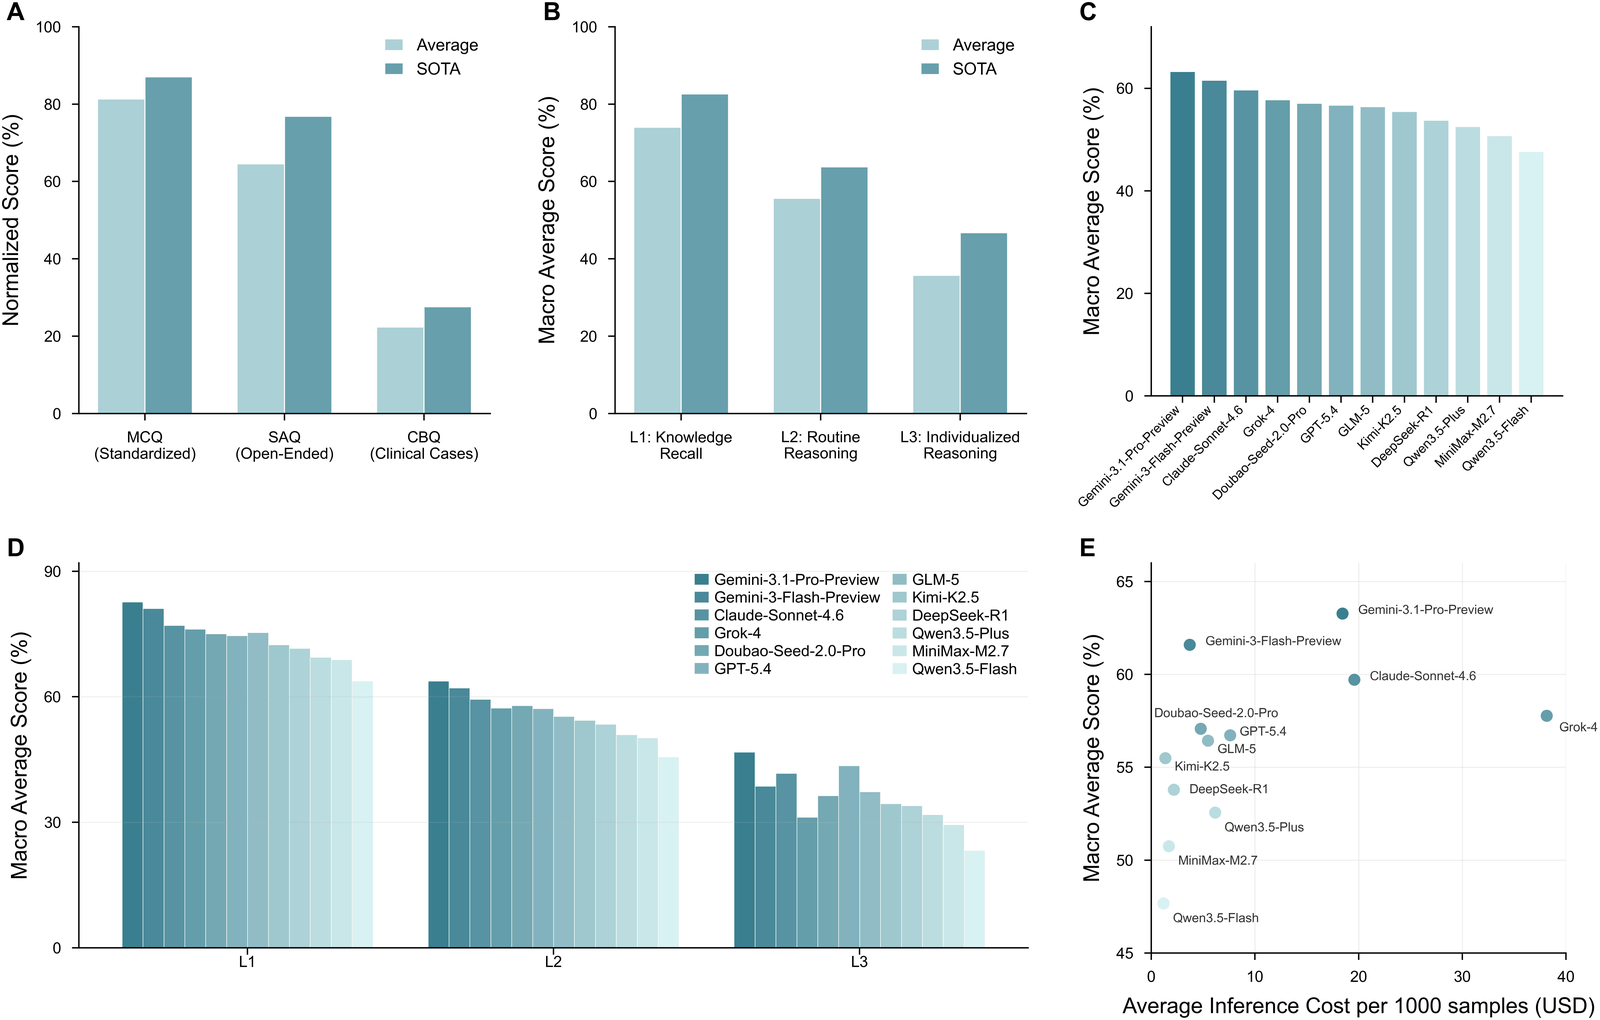 الشكل 1: نتائج 12 نموذجًا رائدًا على GlobalDentBench: أنواع الأسئلة ومستويات الاستدلال والترتيب العام وتكلفة الاستدلال (المصدر: بحث GlobalDentBench)
بعبارة أخرى، تشبه النماذج الكبيرة اليوم طالبًا حفظ الكتاب المدرسي، أكثر مما تشبه طبيبًا قادرًا على اتخاذ القرار لمريض بعينه.
رابعًا: في طب الأسنان، بعض الأخطاء لا يمكن التراجع عنها
أكثر ما يشغلني هو السلامة. فقد قيّم GlobalDentBench مخاطر 19,080 إجابة عن 1,590 سؤال حالة: عُدّت 31.01% منها غير آمنة، و4.51% قد تسبب ضررًا لا رجعة فيه، وسجّل تقويم الأسنان أعلى نسبة من الإجابات غير الآمنة بواقع 44.30%.
الأسنان لا تنمو من جديد. ورسالتنا هي «أن يحتفظ كل إنسان بأسنانه الطبيعية ويعيش بصحة جيدة حتى 120 عامًا». فخلع سن دون داعٍ أو توصية علاجية مفرطة ثمنهما دائم. لهذا نرى أن النماذج الكبيرة في المرحلة الحالية تصلح للمساعدة في البحث عن المعرفة وتنظيمها تحت إشراف الخبراء، لكنها لا تستطيع بعدُ أن تتولى وحدها القرارات السريرية في طب الأسنان.
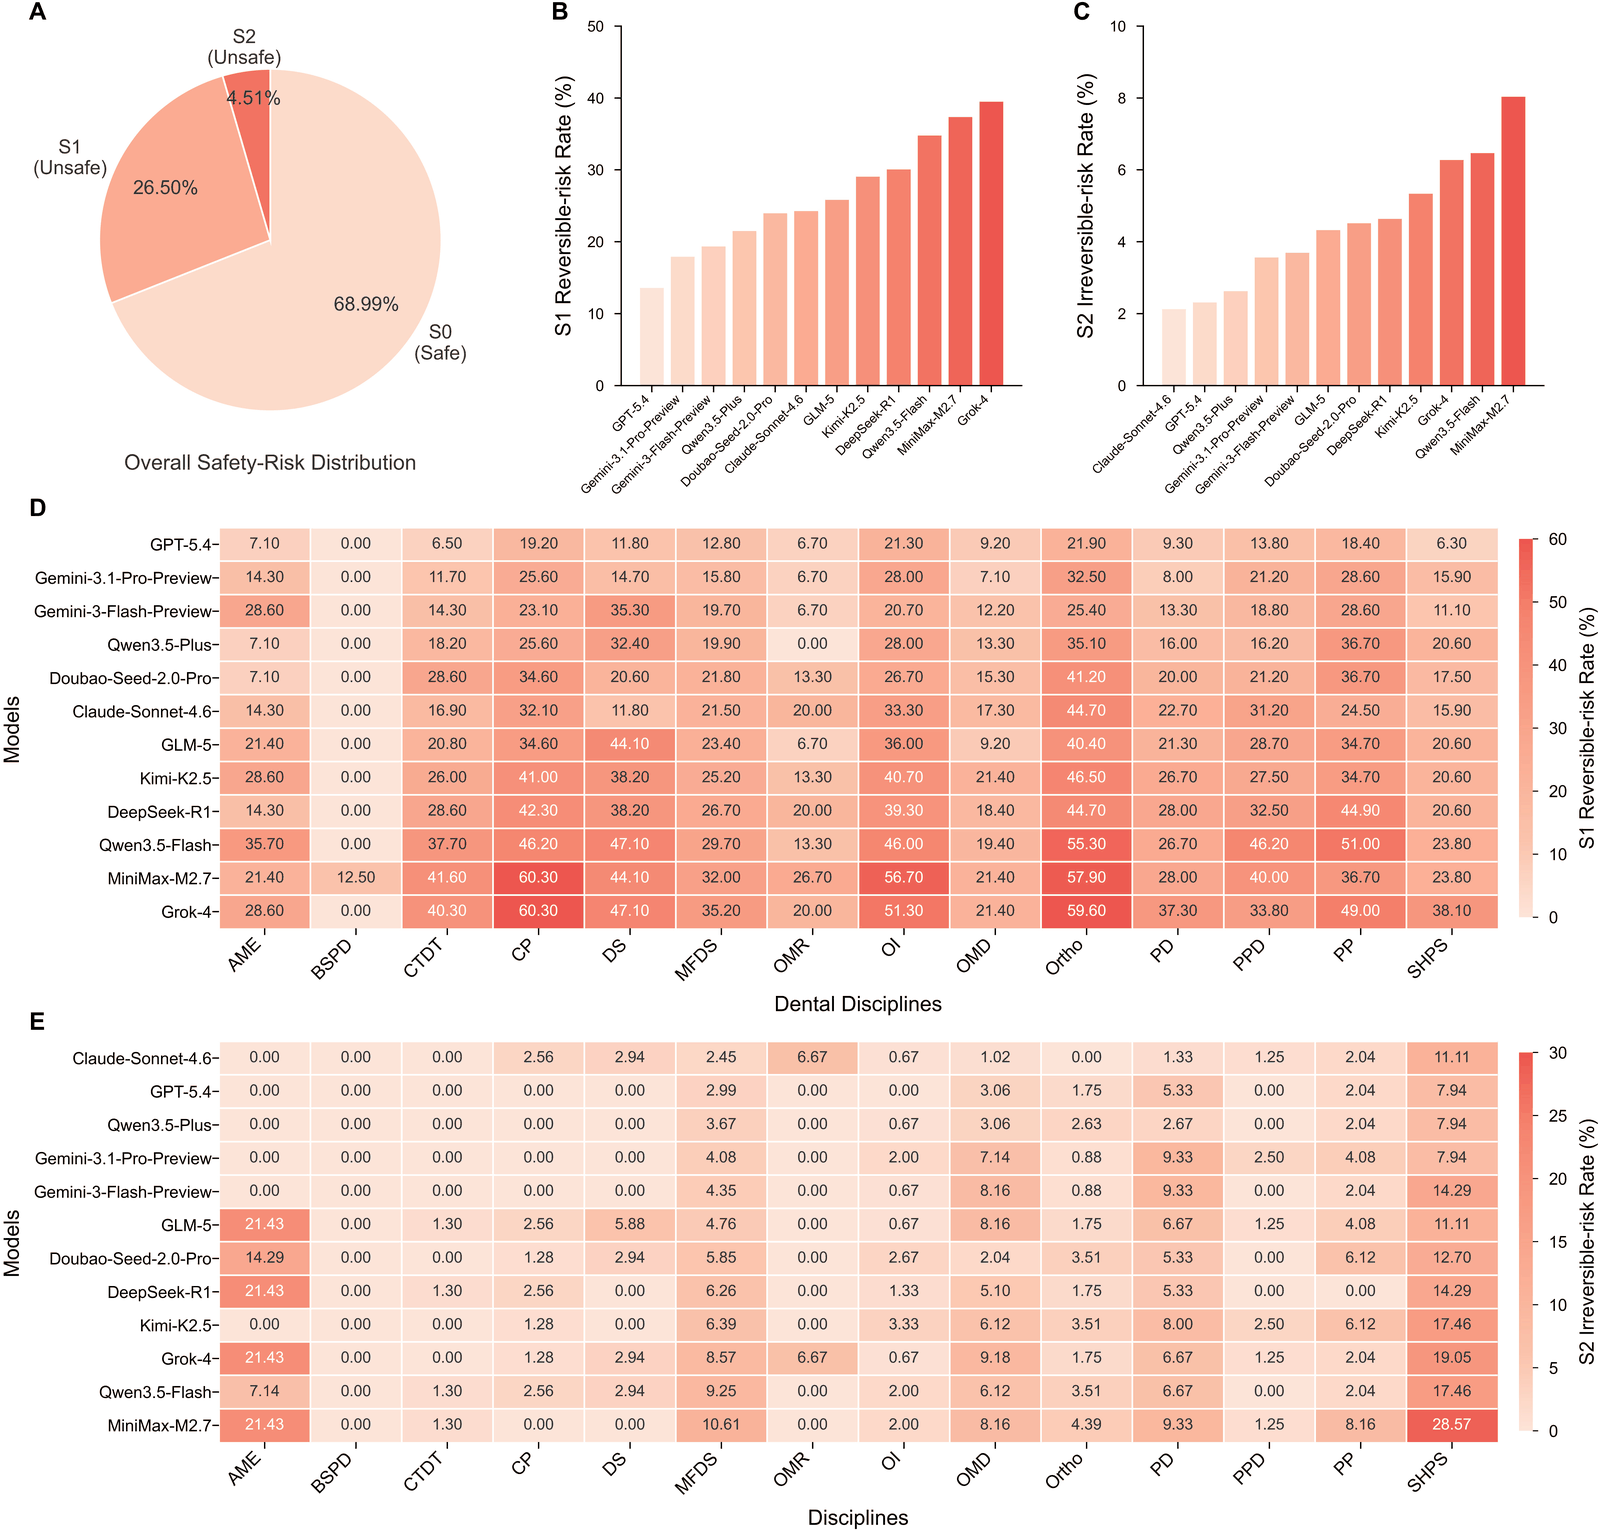 الشكل 2: تحليل مخاطر السلامة في إجابات أسئلة الحالات؛ S1 تعني ضررًا محتملًا قابلًا للعكس، وS2 ضررًا محتملًا لا رجعة فيه (المصدر: بحث GlobalDentBench)
خامسًا: النموذج المتخصص يمكن أن يكون صغيرًا وقويًا
الخبر الجيد أن التدريب المتخصص يجدي. لا يتجاوز حجم DentalGPT 7B معامل. استخدمنا أولًا أكثر من 120,000 صورة أسنان للمواءمة متعددة الوسائط ليتعلم النموذج «الرؤية»، ثم استخدمنا التعلم المعزز لتحفيز الاستدلال المعقد ليتعلم «التفكير». وفي خمسة معايير لطب الأسنان بلغ متوسط دقته 67.1%، متفوقًا على 59.2% لـ GPT-5؛ وفي تصنيف الصور البانورامية بلغ 84.0%، مقابل 50.0% للنموذج الأساسي و63.5% لـ GPT-5. وبالعودة إلى مثال عدّ الحشوات: بعد التدريب، راجع DentalGPT عمله مرارًا ثم عدّ الأسنان العشرة بشكل صحيح.
وتُظهر تجارب الاستئصال أيضًا أهمية الترتيب. فالمواءمة متعددة الوسائط وحدها ترفع متوسط الدقة من 46.7% إلى 63.2%، وبإضافة التعلم المعزز يرتفع إلى 67.1%. أما النموذج الذي لم يخضع لمواءمة في طب الأسنان، فلا يجلب له التعلم المعزز إلا تحسنًا محدودًا، وكلما زادت بيانات المواءمة ارتفع السقف الذي يمكن للتعلم المعزز بلوغه. فالمعرفة المتخصصة أساس الاستدلال، وليست زينة يمكن الاستغناء عنها.
وفي تقييم أعمى أجراه 4 أطباء أسنان ممارسين، تعادل DentalGPT في أغلب الحالات مع GPT-5 وGemini-2.5-Pro، وكانت انتصاراته أكثر من هزائمه؛ وأمام Claude-Sonnet-4.5 وQwen3-VL-235B بلغت نسبة فوزه 63.9% و87.5% على التوالي.
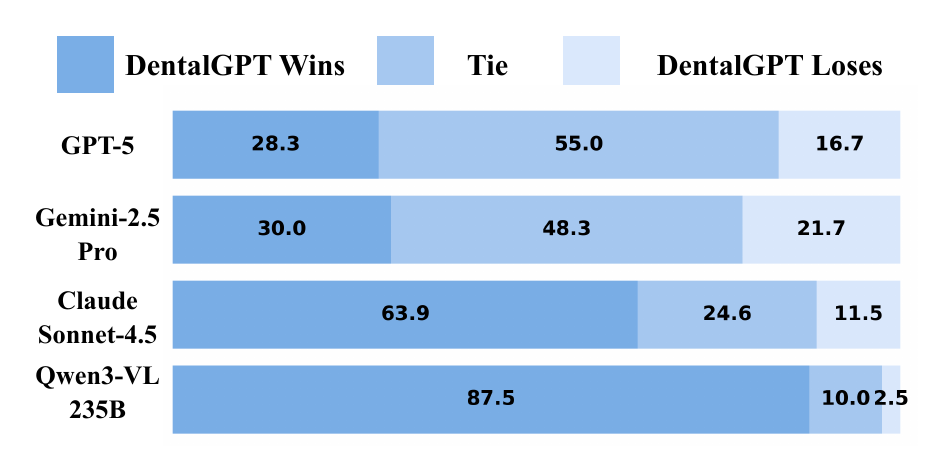 الشكل 3: تقييم ثنائي أجراه أطباء أسنان ممارسون: نسب فوز DentalGPT وتعادله وخسارته (%) (المصدر: بحث DentalGPT)
سادسًا: النموذج المتخصص لا يُبنى خلف أبواب مغلقة
لم تكن صعوبة تدريب نموذج كبير لطب الأسنان في الخوارزمية وحدها قط:
- يجب أن يشارك الخبراء مشاركة عميقة. أشرف ستة أطباء أسنان كبار مرخّصون على بناء GlobalDentBench من البداية إلى النهاية، بما مجموعه 297 ساعة عمل. وفي البيانات التي وسمها الخبراء لـ DentalGPT، تُستبعد أي تسمية تقل نسبة الاتفاق فيها في التحقق المتبادل عن 85%.
- يجب أن يشمل التقييم بلدانًا ومعايير مختلفة. تختلف الإرشادات السريرية وامتحانات الترخيص من بلد إلى آخر، لذا أجرينا التقييم في بلدان متعددة منذ البداية. أما OmniDentBench، الذي لا يزال قيد الإنشاء، فينتقي أسئلة عالية الصعوبة من تقارير حالات حقيقية، يراجعها خبراء طب أسنان من الصين وخارجها سؤالًا سؤالًا، لاختبار القرار السريري على مستوى الخبراء.
- يجب أن تستخدم النماذج الأدوات وتقدّم الأدلة. يتيح DentalAgent الذي نطوّره للنموذج استدعاء أدوات متخصصة لترقيم الأسنان وتصنيف الآفات والقياس، والرجوع إلى الكتب المرجعية والإرشادات والحالات بوصفها أدلة، لتكون أحكامه قابلة للتحقق.
- يبقى القرار الأخير دائمًا للطبيب. في تعاوننا مع Shenzhen Stomatology Hospital (Pingshan) of Southern Medical University ومستشفى فوشان لطب الفم والأسنان، يقدّم الذكاء الاصطناعي اقتراحات ويعرض أدلته وينبّه إلى النواقص، بينما يبقى التشخيص وقرار العلاج دائمًا في يد الطبيب.
كلمة أخيرة
لا نطوّر DentalGPT ليكون نموذجًا «يحل محل أطباء الأسنان»، بل نريد أن يصل الحكم المهني في صحة الفم مبكرًا وإلى عدد أكبر من الناس: أن نكتشف المشكلة وهي ما زالت صغيرة، وأن ننقذ السن ما دام إنقاذه ممكنًا. ستواصل النماذج العامة تقدّمها، لكن في مجال شديد التخصص لا يمكن فيه التراجع عن الأخطاء، لا غنى عن البيانات المتخصصة والتدريب المتخصص والتقييم المتخصص، جنبًا إلى جنب مع الأطباء.
الأبحاث المرجعية
- DentalGPT: Incentivizing Multimodal Reasoning in Dentistry, Findings of ACL 2026: https://aclanthology.org/2026.findings-acl.135/
- GlobalDentBench: A Multinational Benchmark for Evaluating LLM Clinical Reasoning in Dentistry with Expert Calibration, npj Digital Medicine (مقبول للنشر)؛ النسخة الأولية: https://arxiv.org/abs/2605.24636
- Towards Medical Complex Reasoning with LLMs through Medical Verifiable Problems (HuatuoGPT-o1), Findings of ACL 2025: https://aclanthology.org/2025.findings-acl.751/
- لمزيد من المعلومات: DentalGPT والتقنيات الأساسية، تقييم طب الأسنان: GlobalDentBench وOmniDentBench