Benyou Wang: हम दंत चिकित्सा के लिए एक समर्पित बड़ा मॉडल क्यों प्रशिक्षित करते हैं
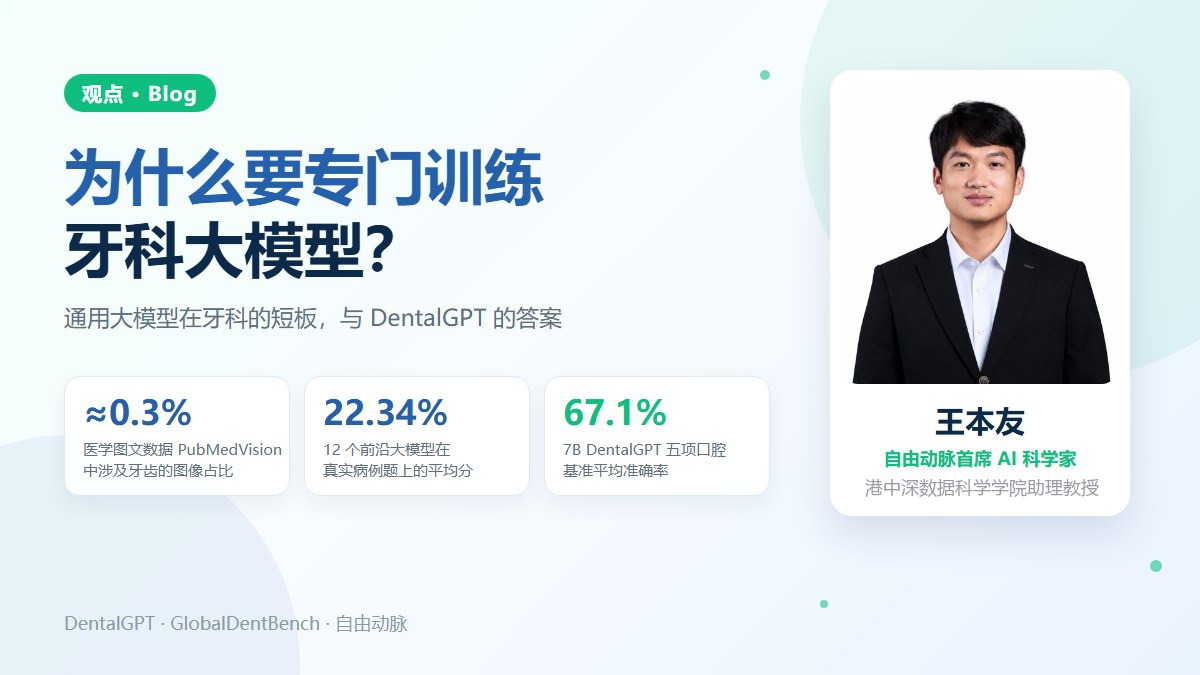
पिछले तीन वर्षों से मैं चिकित्सा बड़े मॉडलों के शोध में भाग ले रहा हूँ: HuatuoGPT और HuatuoGPT-II से लेकर चिकित्सा छवियाँ पढ़ने वाले HuatuoGPT-Vision तक, और फिर जटिल चिकित्सा तर्क करने वाले HuatuoGPT-o1 तक। जब से हमने मौखिक स्वास्थ्य की ओर रुख़ किया है, हमसे सबसे अधिक यही पूछा जाता है: जब सामान्य बड़े मॉडल लगातार बेहतर हो रहे हैं, तो दंत चिकित्सा के लिए अलग मॉडल क्यों प्रशिक्षित करें?
मेरा उत्तर है: दंत चिकित्सा में "सामान्य" काफ़ी नहीं है। मैं राय नहीं दूँगा, केवल अपने शोध-पत्रों के आँकड़े रखूँगा।
1. सामान्य डेटा में दंत चिकित्सा लगभग एक अनदेखा क्षेत्र है
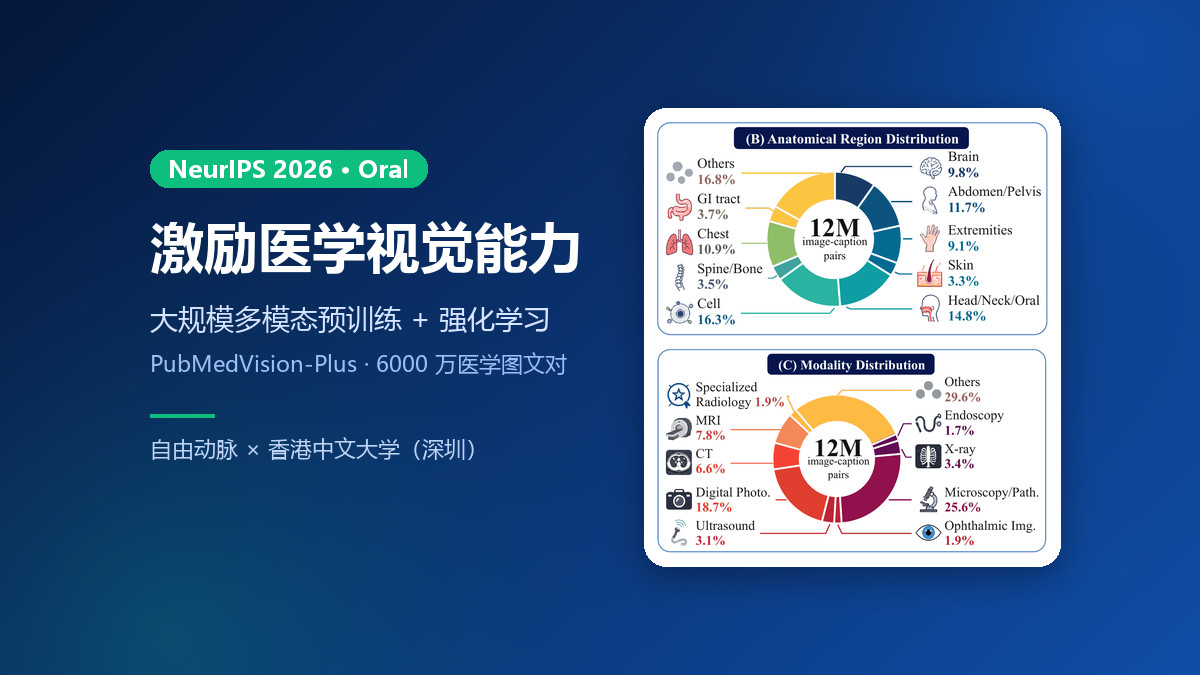
बड़े मॉडल की क्षमता उसके डेटा से आती है, और सामान्य डेटा में दंत चिकित्सा का हिस्सा बहुत छोटा है। DentalGPT के प्रीप्रिंट में हमने पाया कि बड़े पैमाने के चिकित्सा छवि–पाठ डेटासेट PubMedVision में दाँतों से जुड़ी छवियाँ केवल लगभग 0.3% हैं।
दंत छवियाँ बहुत बारीक भी होती हैं। पैनोरमिक रेडियोग्राफ़ में पूरी दंत-पंक्ति दिखती है, जबकि फ़िलिंग, रूट कैनाल उपचार, फँसे हुए दाँत और पेरिएपिकल घाव अक्सर उसका बहुत छोटा हिस्सा घेरते हैं। मुँह के अंदर की तस्वीरें, पेरिएपिकल फ़िल्म, लैटरल सेफ़ैलोग्राम और CBCT, हर एक को पढ़ने का अपना तरीका है। जिस मॉडल ने ऐसी छवियाँ शायद ही देखी हों, उससे उन्हें समझने की उम्मीद नहीं की जा सकती।
2. सामान्य मॉडल "देख" तो लेते हैं, पर सही गिन या आँक नहीं पाते
पैनोरमिक रेडियोग्राफ़ पर प्रश्नोत्तर बेंचमार्क MMOral-OPG-Bench पर GPT-5, Gemini-2.5-Pro और Claude-Sonnet-4.5 जैसे शीर्ष मॉडलों की सटीकता 60% से ऊपर नहीं गई। हमने यह भी पाया कि "थिंकिंग मोड" चालू करने पर भी मौखिक स्वास्थ्य के कार्यों में उनका सुधार अन्य चिकित्सा क्षेत्रों की तुलना में साफ़ तौर पर कम रहता है।
DentalGPT शोध-पत्र में एक स्पष्ट उदाहरण है: मॉडल से पैनोरमिक रेडियोग्राफ़ में फ़िलिंग वाले दाँत गिनने को कहा गया, सही उत्तर 10 है। GPT-5 ने लगभग 6 बताए, Qwen3-VL-235B के बिना-थिंकिंग संस्करण ने 16 गिने, और उसका थिंकिंग संस्करण बार-बार ख़ुद जाँचने के बाद 8 पर रुक गया। मॉडल संबंधित दृश्य संकेत तो खोज लेते हैं, पर उनसे सही उत्तर तक नहीं पहुँच पाते। समस्या केवल "न देख पाना" नहीं है, बल्कि दृश्य बारीकियों को दंत ज्ञान से जोड़ने की क्षमता की कमी है।
3. मामला जितना वास्तविक, मॉडल को उतनी ही कठिनाई
इन कमियों को साफ़ देखने के लिए हमने दुनिया भर के दंत विशेषज्ञों के साथ मिलकर GlobalDentBench बेंचमार्क बनाया: विशेषज्ञों द्वारा सत्यापित 8,978 प्रश्न, जो 88 देशों और क्षेत्रों तथा 14 दंत विशेषज्ञताओं से लिए गए हैं। 12 अग्रणी मॉडलों पर नतीजे स्पष्ट हैं:
- प्रश्न जितना वास्तविक नैदानिक अभ्यास जैसा, अंक उतने ही कम: बहुविकल्पीय प्रश्नों का औसत 81.34%, लघु-उत्तरीय प्रश्नों का 64.53%, और वास्तविक केस रिपोर्टों से लिए गए केस प्रश्नों का केवल 22.34% रहा।
- निर्णय जितना व्यक्तिगत, कठिनाई उतनी अधिक: औसत अंक "ज्ञान स्मरण" में 74.01% से घटकर "सामान्य तर्क" में 55.64% और "व्यक्तिगत तर्क" में 35.71% रह गए; व्यक्तिगत तर्क में सभी मॉडल 50% से नीचे रहे।
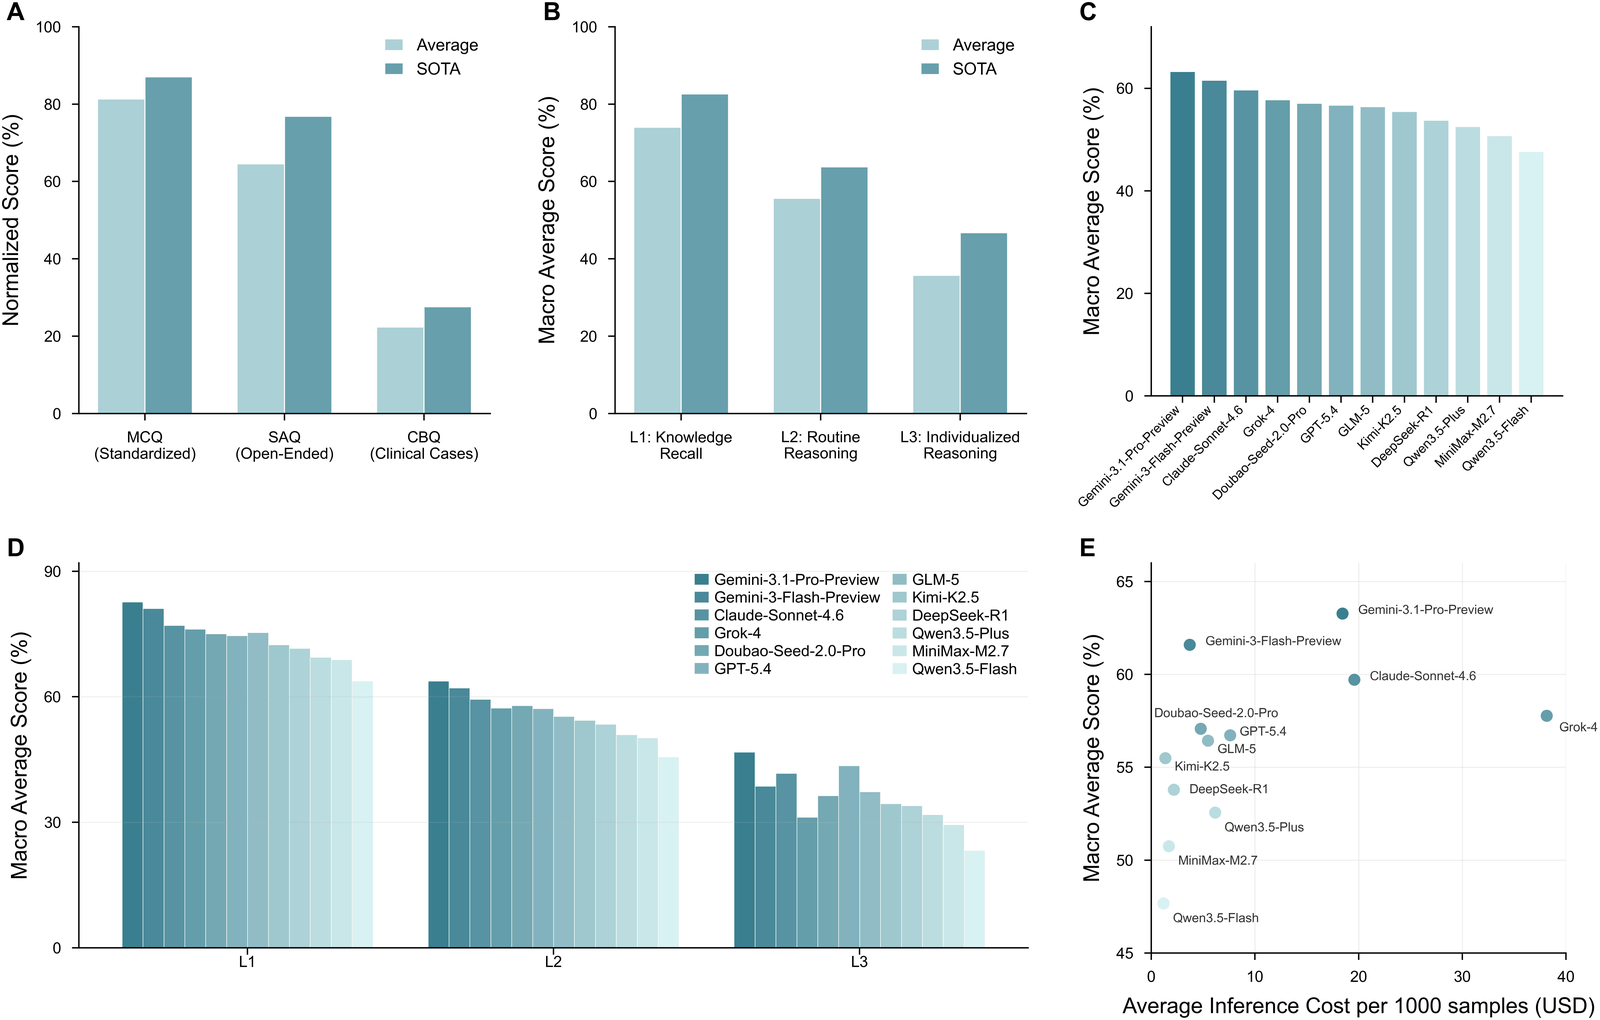 चित्र 1: GlobalDentBench पर 12 अग्रणी मॉडलों के परिणाम: प्रश्न प्रकार, तर्क के स्तर, समग्र रैंकिंग और तर्क की लागत (स्रोत: GlobalDentBench शोध-पत्र)
दूसरे शब्दों में, आज के बड़े मॉडल पाठ्यपुस्तक रट चुके छात्र जैसे अधिक हैं, किसी विशेष रोगी के लिए निर्णय लेने वाले डॉक्टर जैसे कम।
4. दंत चिकित्सा में कुछ ग़लतियाँ अपरिवर्तनीय होती हैं
मुझे सबसे अधिक चिंता सुरक्षा की है। GlobalDentBench ने 1,590 केस प्रश्नों के 19,080 उत्तरों के जोखिम का आकलन किया: 31.01% उत्तर असुरक्षित पाए गए, जिनमें से 4.51% अपरिवर्तनीय नुकसान पहुँचा सकते थे; ऑर्थोडॉन्टिक्स में असुरक्षित उत्तरों का अनुपात सबसे अधिक, 44.30% रहा।
दाँत दोबारा नहीं उगते। हमारा मिशन है "हर व्यक्ति के अपने प्राकृतिक दाँत बने रहें और वह 120 वर्ष तक स्वस्थ जीवन जिए"। एक अनावश्यक दाँत निकालना या ज़रूरत से ज़्यादा उपचार की सलाह, इनकी क़ीमत स्थायी होती है। इसीलिए हमारा मानना है कि इस समय बड़े मॉडल विशेषज्ञों की निगरानी में ज्ञान खोजने और व्यवस्थित करने में मदद के लिए उपयुक्त हैं, पर वे अभी अकेले दंत नैदानिक निर्णय नहीं ले सकते।
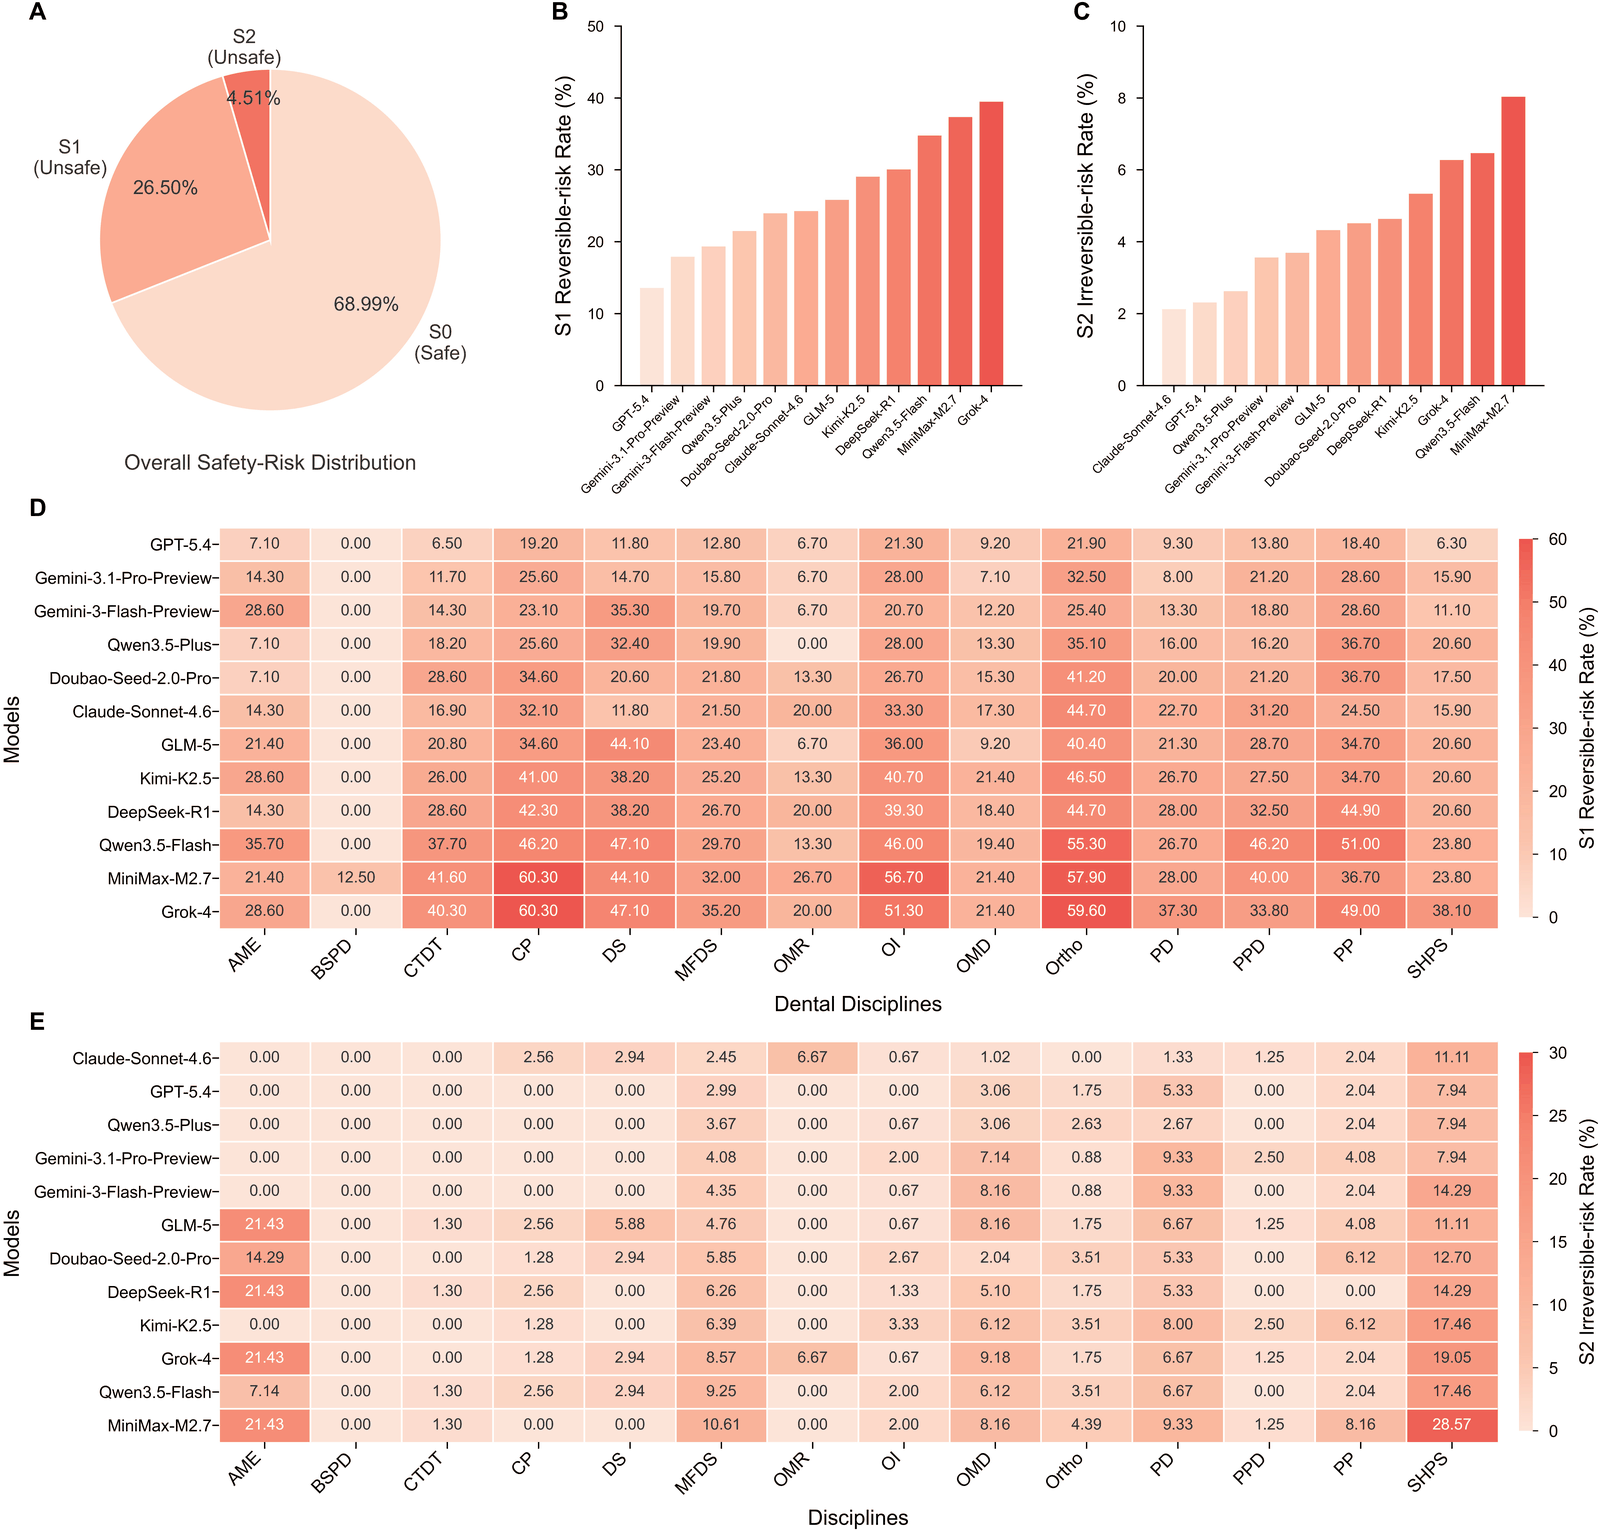 चित्र 2: केस प्रश्नों के उत्तरों का सुरक्षा जोखिम विश्लेषण; S1 का अर्थ संभावित प्रतिवर्ती नुकसान और S2 का अर्थ संभावित अपरिवर्तनीय नुकसान है (स्रोत: GlobalDentBench शोध-पत्र)
5. विशेषज्ञ मॉडल छोटा होकर भी मज़बूत हो सकता है
अच्छी बात यह है कि समर्पित प्रशिक्षण कारगर है। DentalGPT में केवल 7B पैरामीटर हैं। पहले हमने 1,20,000 से अधिक दंत छवियों से बहु-मोडल संरेखण किया, ताकि मॉडल "देखना" सीखे; फिर जटिल तर्क विकसित करने के लिए सुदृढीकरण अधिगम का उपयोग किया, ताकि वह "सोचना" सीखे। पाँच दंत बेंचमार्क पर इसकी औसत सटीकता 67.1% रही, जो GPT-5 के 59.2% से अधिक है; पैनोरमिक रेडियोग्राफ़ वर्गीकरण में यह 84.0% तक पहुँचा, जबकि आधार मॉडल और GPT-5 के अंक क्रमशः 50.0% और 63.5% रहे। फ़िलिंग गिनने के उदाहरण पर लौटें तो प्रशिक्षण के बाद DentalGPT ने बार-बार जाँच करके आख़िरकार सही-सही 10 दाँत गिने।
एब्लेशन प्रयोग यह भी दिखाते हैं कि क्रम महत्वपूर्ण है। केवल बहु-मोडल संरेखण से औसत सटीकता 46.7% से बढ़कर 63.2% हो जाती है; सुदृढीकरण अधिगम जोड़ने पर यह 67.1% तक पहुँचती है। जिस मॉडल का दंत संरेखण नहीं हुआ, उसे सुदृढीकरण अधिगम से सीमित लाभ ही मिलता है, और संरेखण डेटा जितना अधिक होता है, सुदृढीकरण अधिगम की ऊपरी सीमा उतनी ही ऊँची होती है। विशेषज्ञ ज्ञान तर्क की नींव है, कोई वैकल्पिक सजावट नहीं।
4 प्रैक्टिसिंग दंत चिकित्सकों के ब्लाइंड मूल्यांकन में DentalGPT ज़्यादातर मामलों में GPT-5 और Gemini-2.5-Pro के बराबर रहा और उसकी जीतें हार से अधिक रहीं; Claude-Sonnet-4.5 और Qwen3-VL-235B के मुक़ाबले उसकी जीत दर क्रमशः 63.9% और 87.5% रही।
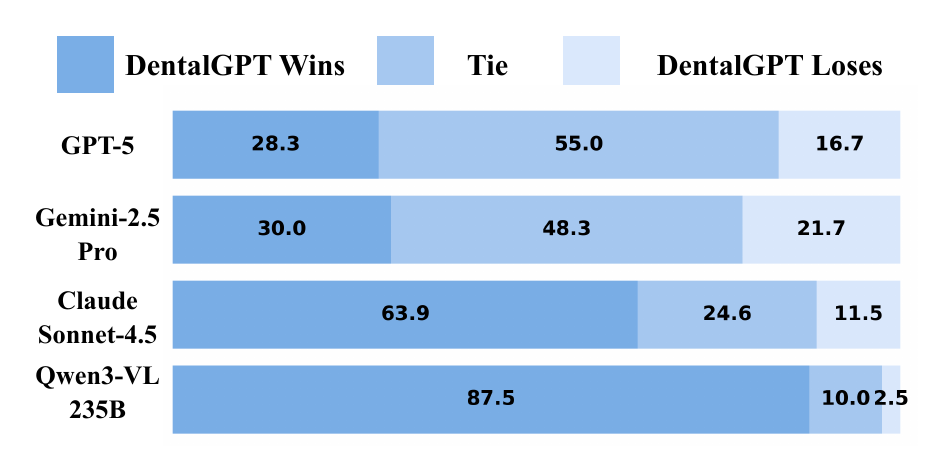 चित्र 3: प्रैक्टिसिंग दंत चिकित्सकों द्वारा जोड़ीवार मूल्यांकन: DentalGPT की जीत, बराबरी और हार का अनुपात (%) (स्रोत: DentalGPT शोध-पत्र)
6. विशेषज्ञ मॉडल बंद कमरे में नहीं बनता
दंत बड़े मॉडल को प्रशिक्षित करने की कठिनाई कभी केवल एल्गोरिद्म में नहीं रही:
- विशेषज्ञों की गहरी भागीदारी ज़रूरी है। छह लाइसेंसधारी वरिष्ठ दंत चिकित्सकों ने GlobalDentBench के निर्माण की शुरू से अंत तक निगरानी की और कुल 297 व्यक्ति-घंटे लगाए। DentalGPT के विशेषज्ञ-एनोटेटेड डेटा में जिन एनोटेशन की क्रॉस-वैलिडेशन सहमति 85% से कम थी, उन्हें हटा दिया गया।
- मूल्यांकन को देशों और मानकों के पार जाना चाहिए। हर देश के नैदानिक दिशानिर्देश और लाइसेंस परीक्षाएँ अलग होती हैं, इसलिए हमने शुरू से ही कई देशों में मूल्यांकन किया। निर्माणाधीन OmniDentBench वास्तविक केस रिपोर्टों से कठिन प्रश्न चुनता है, जिनकी चीन और विदेश के दंत विशेषज्ञ एक-एक कर समीक्षा करते हैं, ताकि विशेषज्ञ-स्तर के नैदानिक निर्णयों को परखा जा सके।
- मॉडल को टूल का उपयोग करना और आधार बताना चाहिए। हमारा DentalAgent मॉडल को दाँतों की नंबरिंग, घावों के वर्गीकरण और माप जैसे पेशेवर टूल का उपयोग करने देता है, और पाठ्यपुस्तकों, दिशानिर्देशों और केसों को साक्ष्य के रूप में खोजने देता है, ताकि उसके निष्कर्ष जाँचे जा सकें।
- अंतिम निर्णय हमेशा डॉक्टर का होता है। Shenzhen Stomatology Hospital (Pingshan) of Southern Medical University और फ़ोशान स्टोमैटोलॉजिकल हॉस्पिटल के साथ हमारे सहयोग में AI सुझाव देता है, साक्ष्य सूचीबद्ध करता है और कमियों की ओर इशारा करता है, जबकि निदान और उपचार का निर्णय हमेशा डॉक्टर के हाथ में रहता है।
अंत में
हम DentalGPT "दंत चिकित्सकों की जगह लेने" के लिए नहीं बना रहे। हम चाहते हैं कि पेशेवर मौखिक स्वास्थ्य सलाह जल्दी और अधिक लोगों तक पहुँचे: समस्या छोटी रहते ही पकड़ में आ जाए, और दाँत बचाए जा सकते हों तो बचा लिए जाएँ। सामान्य बड़े मॉडल आगे भी बेहतर होते रहेंगे, लेकिन ऐसे अत्यंत विशिष्ट क्षेत्र में, जहाँ ग़लतियों को पलटा नहीं जा सकता, समर्पित डेटा, समर्पित प्रशिक्षण और समर्पित मूल्यांकन, डॉक्टरों के साथ मिलकर, सभी अनिवार्य हैं।
संदर्भ शोध-पत्र
- DentalGPT: Incentivizing Multimodal Reasoning in Dentistry, Findings of ACL 2026: https://aclanthology.org/2026.findings-acl.135/
- GlobalDentBench: A Multinational Benchmark for Evaluating LLM Clinical Reasoning in Dentistry with Expert Calibration, npj Digital Medicine (स्वीकृत); प्रीप्रिंट: https://arxiv.org/abs/2605.24636
- Towards Medical Complex Reasoning with LLMs through Medical Verifiable Problems (HuatuoGPT-o1), Findings of ACL 2025: https://aclanthology.org/2025.findings-acl.751/
- और जानें: DentalGPT और मुख्य तकनीक, दंत मूल्यांकन: GlobalDentBench और OmniDentBench