Benyou Wang: por qué entrenamos un gran modelo dedicado a la odontología
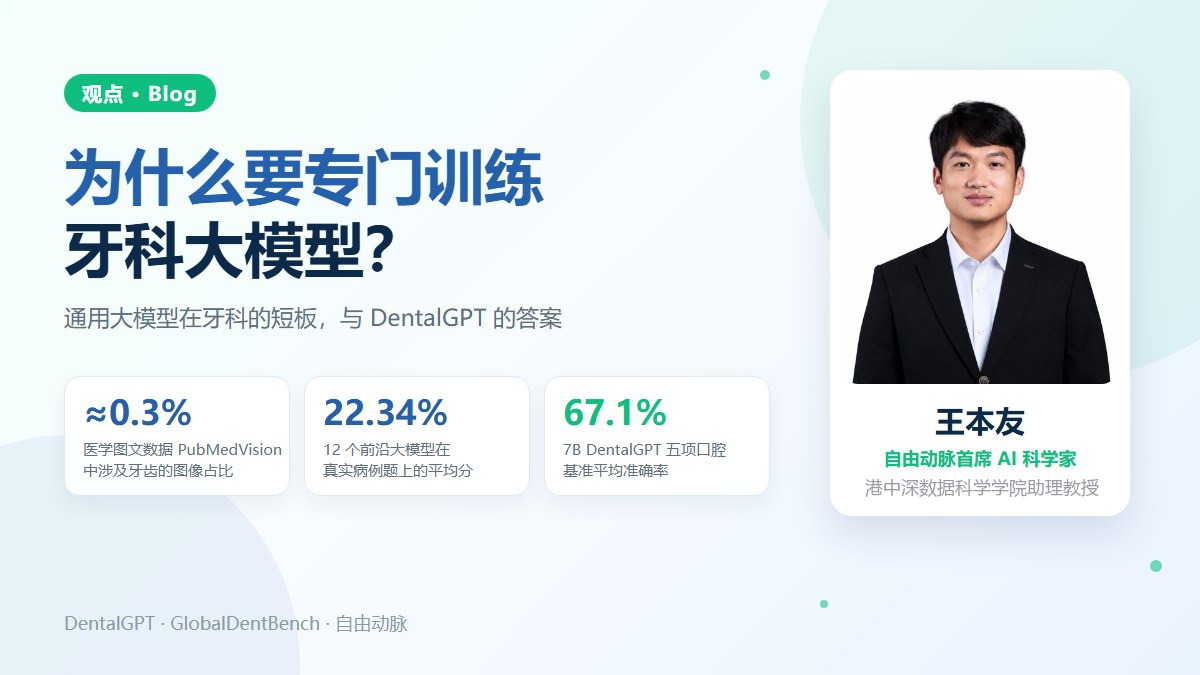
Durante los últimos tres años he participado en la investigación sobre grandes modelos médicos: de HuatuoGPT y HuatuoGPT-II a HuatuoGPT-Vision, capaz de leer imágenes médicas, y a HuatuoGPT-o1, que resuelve razonamientos médicos complejos. Desde que nos centramos en la salud bucodental, la pregunta que más nos hacen es: si los modelos generalistas son cada vez más potentes, ¿por qué entrenar un modelo dedicado a la odontología?
Mi respuesta: en odontología, lo «general» no basta. En lugar de opinar, me limitaré a los datos de nuestros propios artículos.
1. La odontología es casi un punto ciego en los datos generales
Las capacidades de un gran modelo provienen de sus datos, y la odontología ocupa una parte mínima de los datos generales. En el preprint de DentalGPT comprobamos que en PubMedVision, un conjunto de datos médicos de imagen y texto de gran escala, las imágenes relacionadas con los dientes representan solo alrededor del 0,3 %.
Además, las imágenes dentales exigen mucho detalle. Una radiografía panorámica muestra toda la dentición, mientras que las obturaciones, los tratamientos de conductos, los dientes retenidos o las lesiones periapicales ocupan a menudo una zona muy pequeña. Las fotografías intraorales, las radiografías periapicales, las telerradiografías laterales de cráneo y la CBCT tienen cada una su propia forma de lectura. Un modelo que apenas ha visto estas imágenes difícilmente puede entenderlas.
2. Los modelos generalistas «ven», pero no cuentan ni juzgan bien
En MMOral-OPG-Bench, un benchmark de preguntas y respuestas sobre radiografías panorámicas, modelos punteros como GPT-5, Gemini-2.5-Pro y Claude-Sonnet-4.5 no superan el 60 % de precisión. También observamos que, incluso con el «modo de razonamiento» activado, sus mejoras en tareas bucodentales son claramente menores que en otros campos de la medicina.
El artículo de DentalGPT recoge un ejemplo muy ilustrativo: se pide al modelo que cuente los dientes con obturaciones en una radiografía panorámica, y la respuesta correcta es 10. GPT-5 responde unos 6; la versión sin razonamiento de Qwen3-VL-235B cuenta 16, y su versión con razonamiento se queda en 8 tras comprobarse varias veces. Los modelos encuentran las pistas visuales relevantes, pero no llegan a la respuesta correcta. El problema no es solo «no ver», sino la falta de capacidad para relacionar los detalles visuales con el conocimiento odontológico.
3. Cuanto más se parece a un caso real, más le cuesta al modelo
Para ver estas carencias con claridad, construimos junto con expertos en odontología de todo el mundo el benchmark GlobalDentBench: 8.978 preguntas verificadas por expertos, procedentes de 88 países y regiones y de 14 especialidades odontológicas. Con 12 modelos punteros, los resultados son claros:
- Cuanto más se parece la pregunta a la práctica clínica real, menor es la puntuación: las preguntas de opción múltiple promedian un 81,34 %, las de respuesta corta un 64,53 % y las preguntas de casos extraídas de informes de casos reales solo un 22,34 %.
- Cuanto más individualizado es el juicio, más difícil resulta: la puntuación media cae del 74,01 % en «recuerdo de conocimientos» al 55,64 % en «razonamiento rutinario» y al 35,71 % en «razonamiento individualizado»; todos los modelos quedan por debajo del 50 % en razonamiento individualizado.
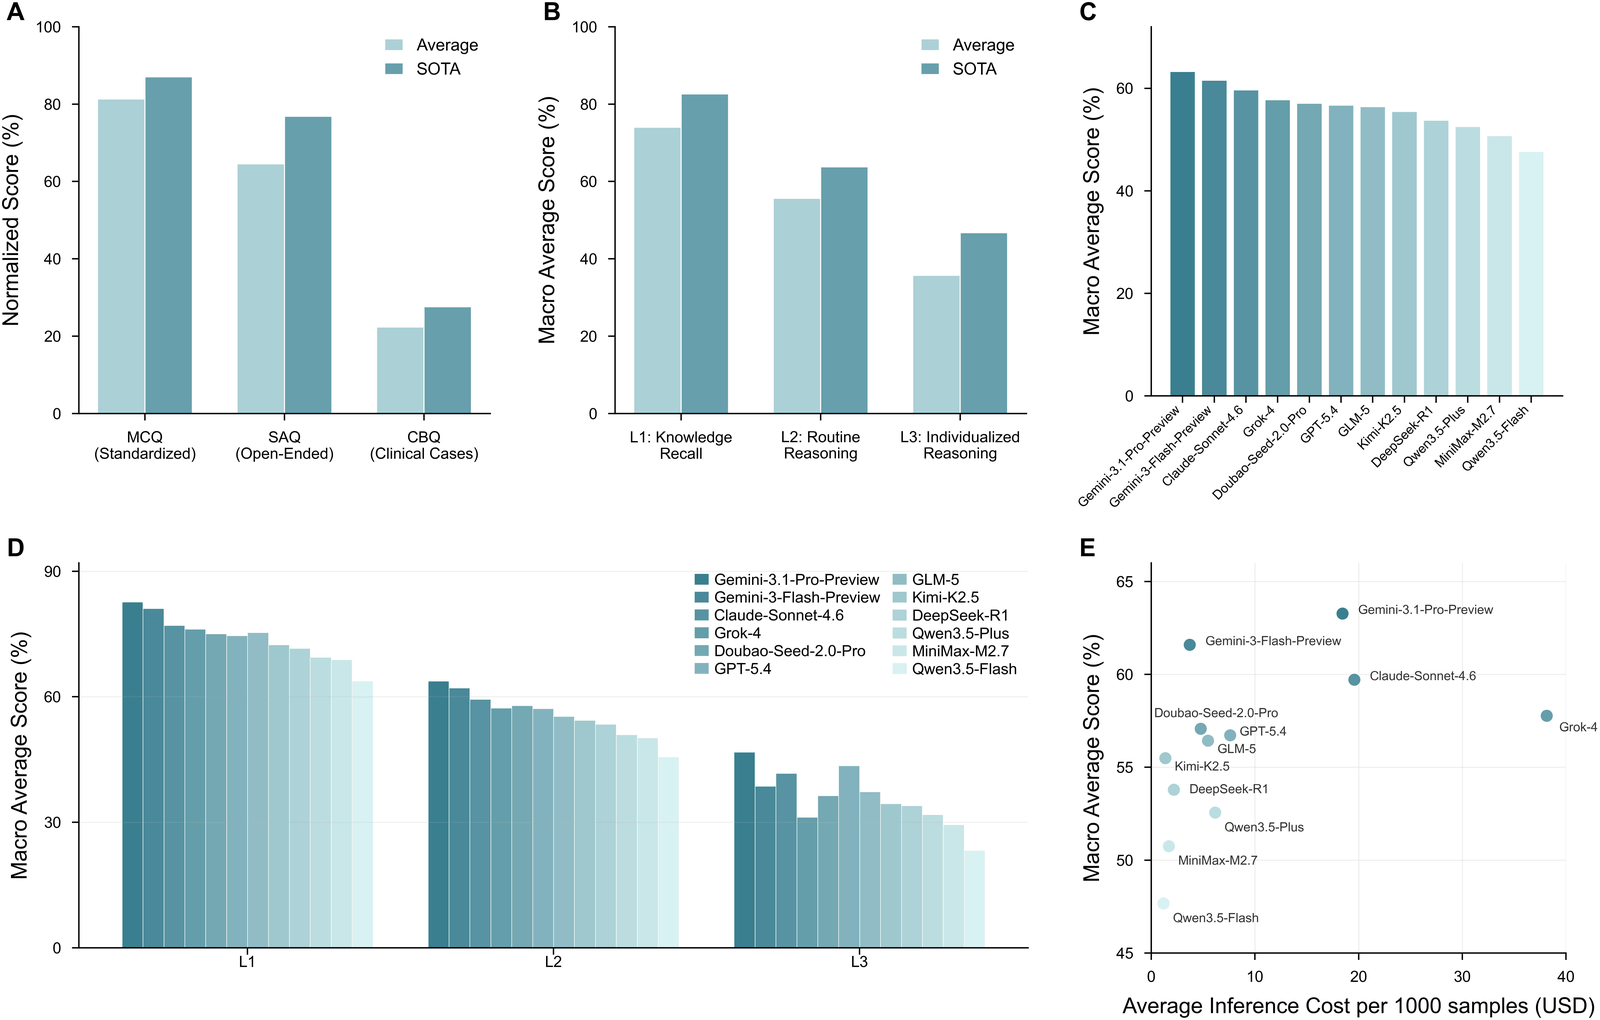 Figura 1: Resultados de 12 modelos punteros en GlobalDentBench: tipos de pregunta, niveles de razonamiento, clasificación general y coste del razonamiento (fuente: artículo de GlobalDentBench)
Dicho de otro modo, los grandes modelos actuales se parecen más a un estudiante que se ha aprendido el manual que a un médico capaz de decidir para un paciente concreto.
4. En odontología, algunos errores son irreversibles
Lo que más me preocupa es la seguridad. GlobalDentBench evaluó el riesgo de 19.080 respuestas a 1.590 preguntas de casos: el 31,01 % se consideró inseguro y el 4,51 % podría causar daños irreversibles. La ortodoncia registró la mayor proporción de respuestas inseguras, un 44,30 %.
Los dientes no vuelven a crecer. Nuestra misión es «que todos conserven sus dientes naturales y vivan con salud hasta los 120 años». Una extracción innecesaria o una recomendación de tratamiento excesiva tienen un coste permanente. Por eso creemos que, hoy por hoy, los grandes modelos sirven para ayudar a buscar y organizar conocimientos bajo la supervisión de expertos, pero todavía no pueden asumir por sí solos decisiones clínicas odontológicas.
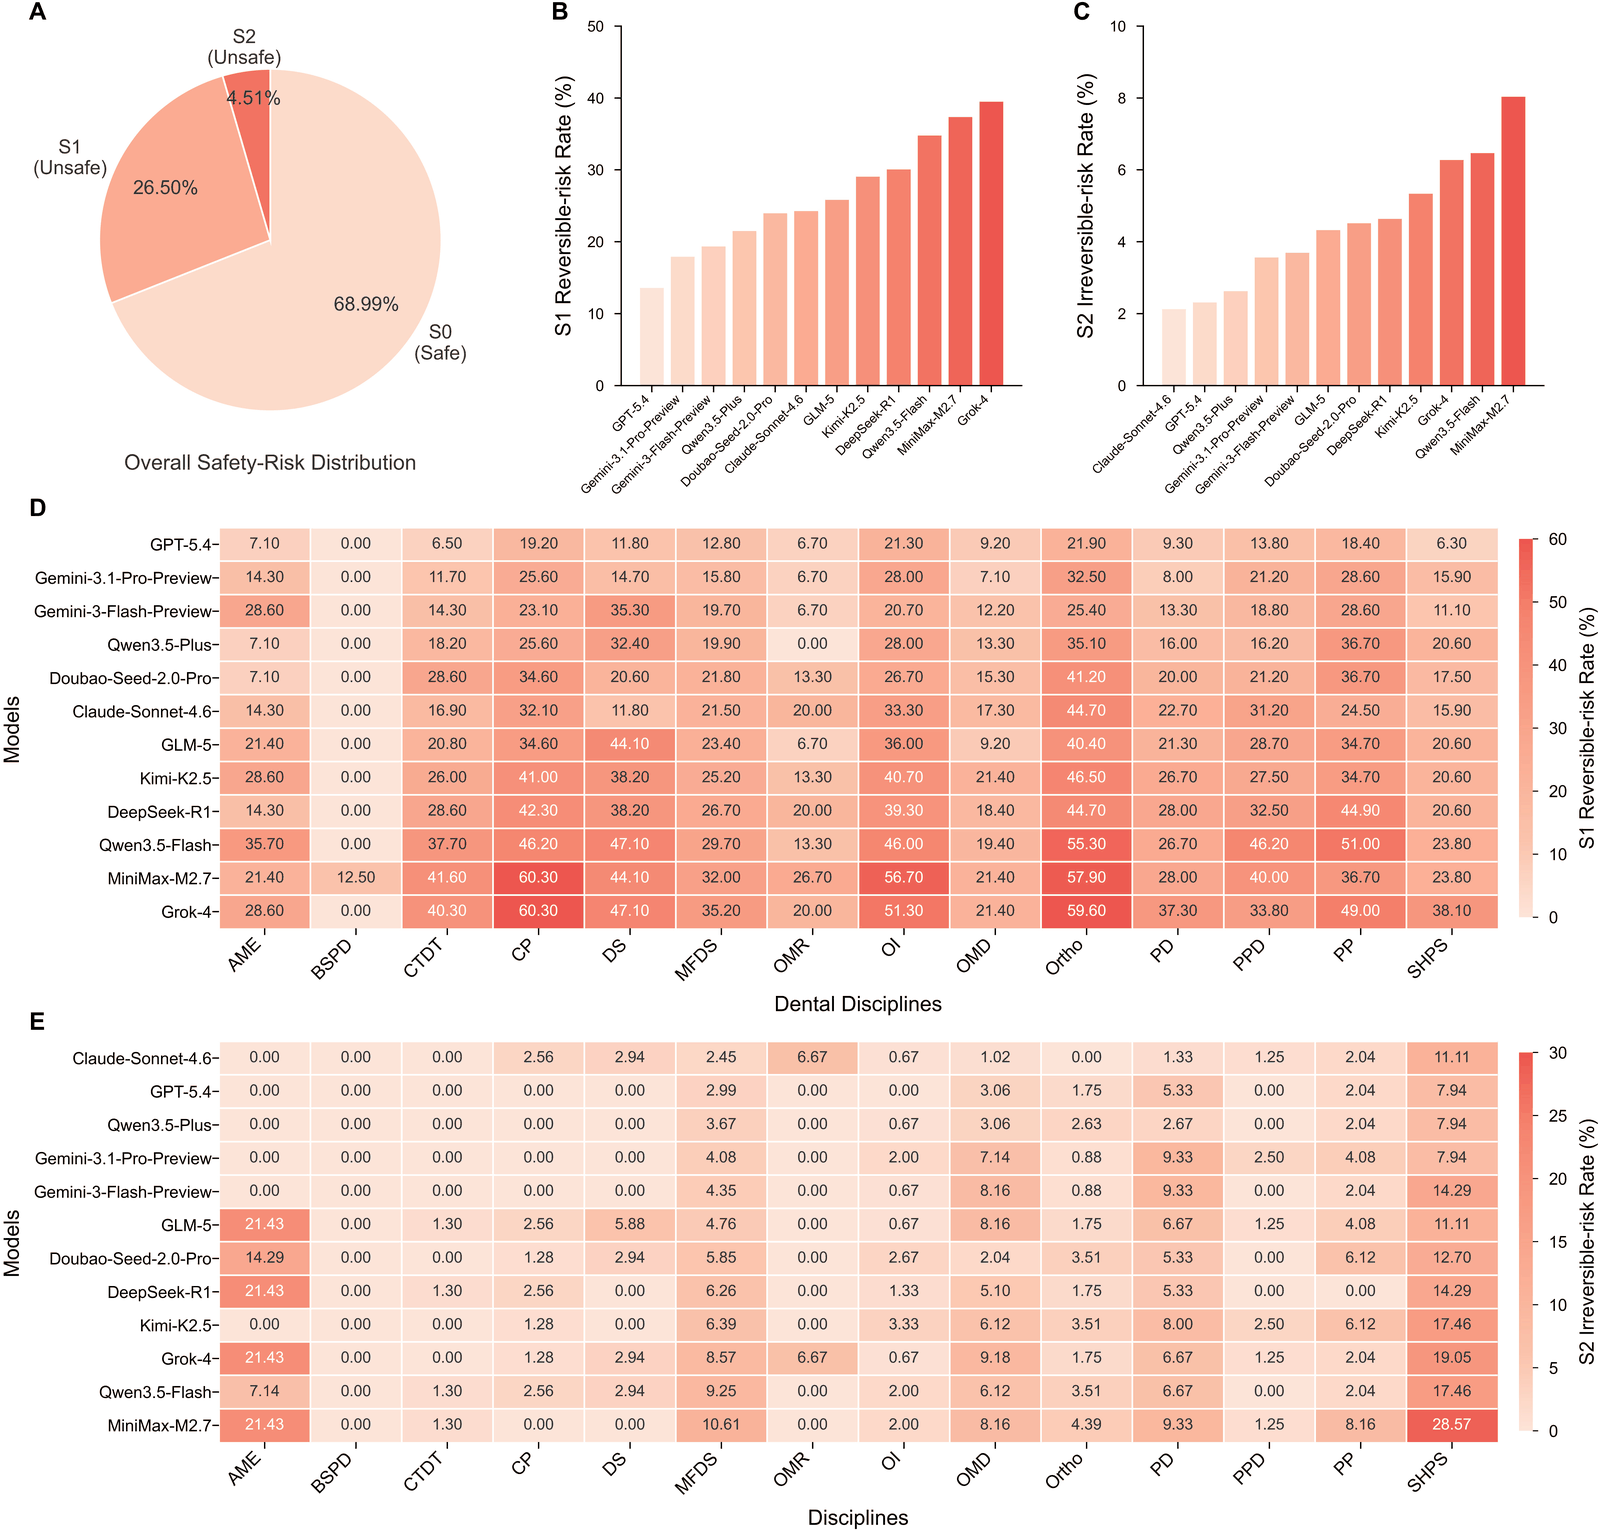 Figura 2: Análisis del riesgo para la seguridad de las respuestas a preguntas de casos. S1 indica un posible daño reversible y S2 un posible daño irreversible (fuente: artículo de GlobalDentBench)
5. Un modelo especializado puede ser pequeño y potente
La buena noticia es que el entrenamiento específico funciona. DentalGPT tiene solo 7B de parámetros. Primero usamos más de 120.000 imágenes dentales para el alineamiento multimodal, de modo que el modelo aprendiera a «ver»; después aplicamos aprendizaje por refuerzo para estimular el razonamiento complejo, de modo que aprendiera a «pensar». En cinco benchmarks bucodentales alcanza una precisión media del 67,1 %, por encima del 59,2 % de GPT-5; en la clasificación de radiografías panorámicas llega al 84,0 %, frente al 50,0 % de su modelo base y el 63,5 % de GPT-5. Volviendo al ejemplo de las obturaciones: tras el entrenamiento, DentalGPT revisó su trabajo varias veces y acabó contando correctamente las 10.
Los experimentos de ablación también muestran que el orden importa. Solo con el alineamiento multimodal, la precisión media pasa del 46,7 % al 63,2 %; al añadir el aprendizaje por refuerzo, sube al 67,1 %. En un modelo sin alineamiento odontológico, el aprendizaje por refuerzo aporta mejoras limitadas, y cuantos más datos de alineamiento hay, más alto es el techo que puede alcanzar. El conocimiento especializado es la base del razonamiento, no un adorno prescindible.
En una evaluación a ciegas realizada por 4 dentistas en ejercicio, DentalGPT empató en la mayoría de los casos con GPT-5 y Gemini-2.5-Pro, con más victorias que derrotas; frente a Claude-Sonnet-4.5 y Qwen3-VL-235B, sus tasas de victoria alcanzaron el 63,9 % y el 87,5 %, respectivamente.
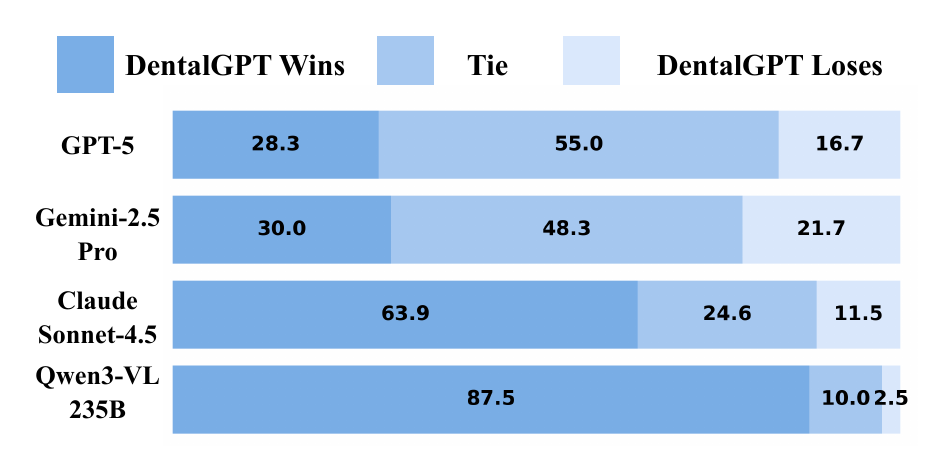 Figura 3: Evaluación por pares realizada por dentistas en ejercicio: proporción de victorias, empates y derrotas de DentalGPT (%) (fuente: artículo de DentalGPT)
6. Un modelo especializado no se construye a puerta cerrada
La dificultad de entrenar un gran modelo dental nunca ha estado solo en el algoritmo:
- Los expertos deben implicarse a fondo. Seis dentistas sénior colegiados supervisaron de principio a fin la construcción de GlobalDentBench, con una dedicación de 297 horas-persona. En los datos anotados por expertos de DentalGPT, se descartan las anotaciones con una concordancia de validación cruzada inferior al 85 %.
- La evaluación debe abarcar países y normas. Las guías clínicas y los exámenes de habilitación varían de un país a otro, por eso evaluamos en varios países desde el principio. OmniDentBench, en construcción, selecciona preguntas difíciles de informes de casos reales, revisadas una a una por expertos en odontología de China y de otros países, para evaluar la toma de decisiones clínicas de nivel experto.
- Los modelos deben usar herramientas y justificar sus conclusiones. Nuestro DentalAgent permite al modelo recurrir a herramientas profesionales de numeración dental, clasificación de lesiones y medición, y consultar manuales, guías y casos como evidencia, de modo que sus juicios puedan verificarse.
- El dentista siempre toma la decisión final. En nuestras colaboraciones con el Shenzhen Stomatology Hospital (Pingshan) of Southern Medical University y el Hospital Estomatológico de Foshan, la IA hace sugerencias, enumera las evidencias y señala lo que falta, mientras que el diagnóstico y las decisiones de tratamiento siguen siempre en manos del dentista.
Para terminar
No desarrollamos DentalGPT para «sustituir a los dentistas». Queremos que el juicio bucodental profesional llegue antes y a más personas: detectar los problemas cuando aún son pequeños y salvar los dientes cuando todavía se pueden salvar. Los modelos generalistas seguirán mejorando, pero en un campo tan especializado, donde los errores no tienen vuelta atrás, los datos específicos, el entrenamiento específico y la evaluación específica, junto con los dentistas, son imprescindibles.
Artículos de referencia
- DentalGPT: Incentivizing Multimodal Reasoning in Dentistry, Findings of ACL 2026: https://aclanthology.org/2026.findings-acl.135/
- GlobalDentBench: A Multinational Benchmark for Evaluating LLM Clinical Reasoning in Dentistry with Expert Calibration, npj Digital Medicine (aceptado); preprint: https://arxiv.org/abs/2605.24636
- Towards Medical Complex Reasoning with LLMs through Medical Verifiable Problems (HuatuoGPT-o1), Findings of ACL 2025: https://aclanthology.org/2025.findings-acl.751/
- Más información: DentalGPT y tecnología central, evaluación dental: GlobalDentBench y OmniDentBench