
Evaluación dental
Junto con expertos dentales de todo el mundo, comprobamos cómo razonan los grandes modelos en la práctica dental real y qué riesgos de seguridad presentan.
8978 preguntas validadas por expertos de 88 países y regiones y 14 especialidades dentales, que evalúan el razonamiento clínico y los riesgos de seguridad de los grandes modelos en odontología.
Global Partners
Nuestra red de colaboración abarca 10 países y regiones
16 universidades, hospitales e institutos de investigación, junto con expertos dentales de Hong Kong, China continental y el extranjero, participan en el desarrollo, la evaluación y la validación clínica de la IA dental de FreedomAI.
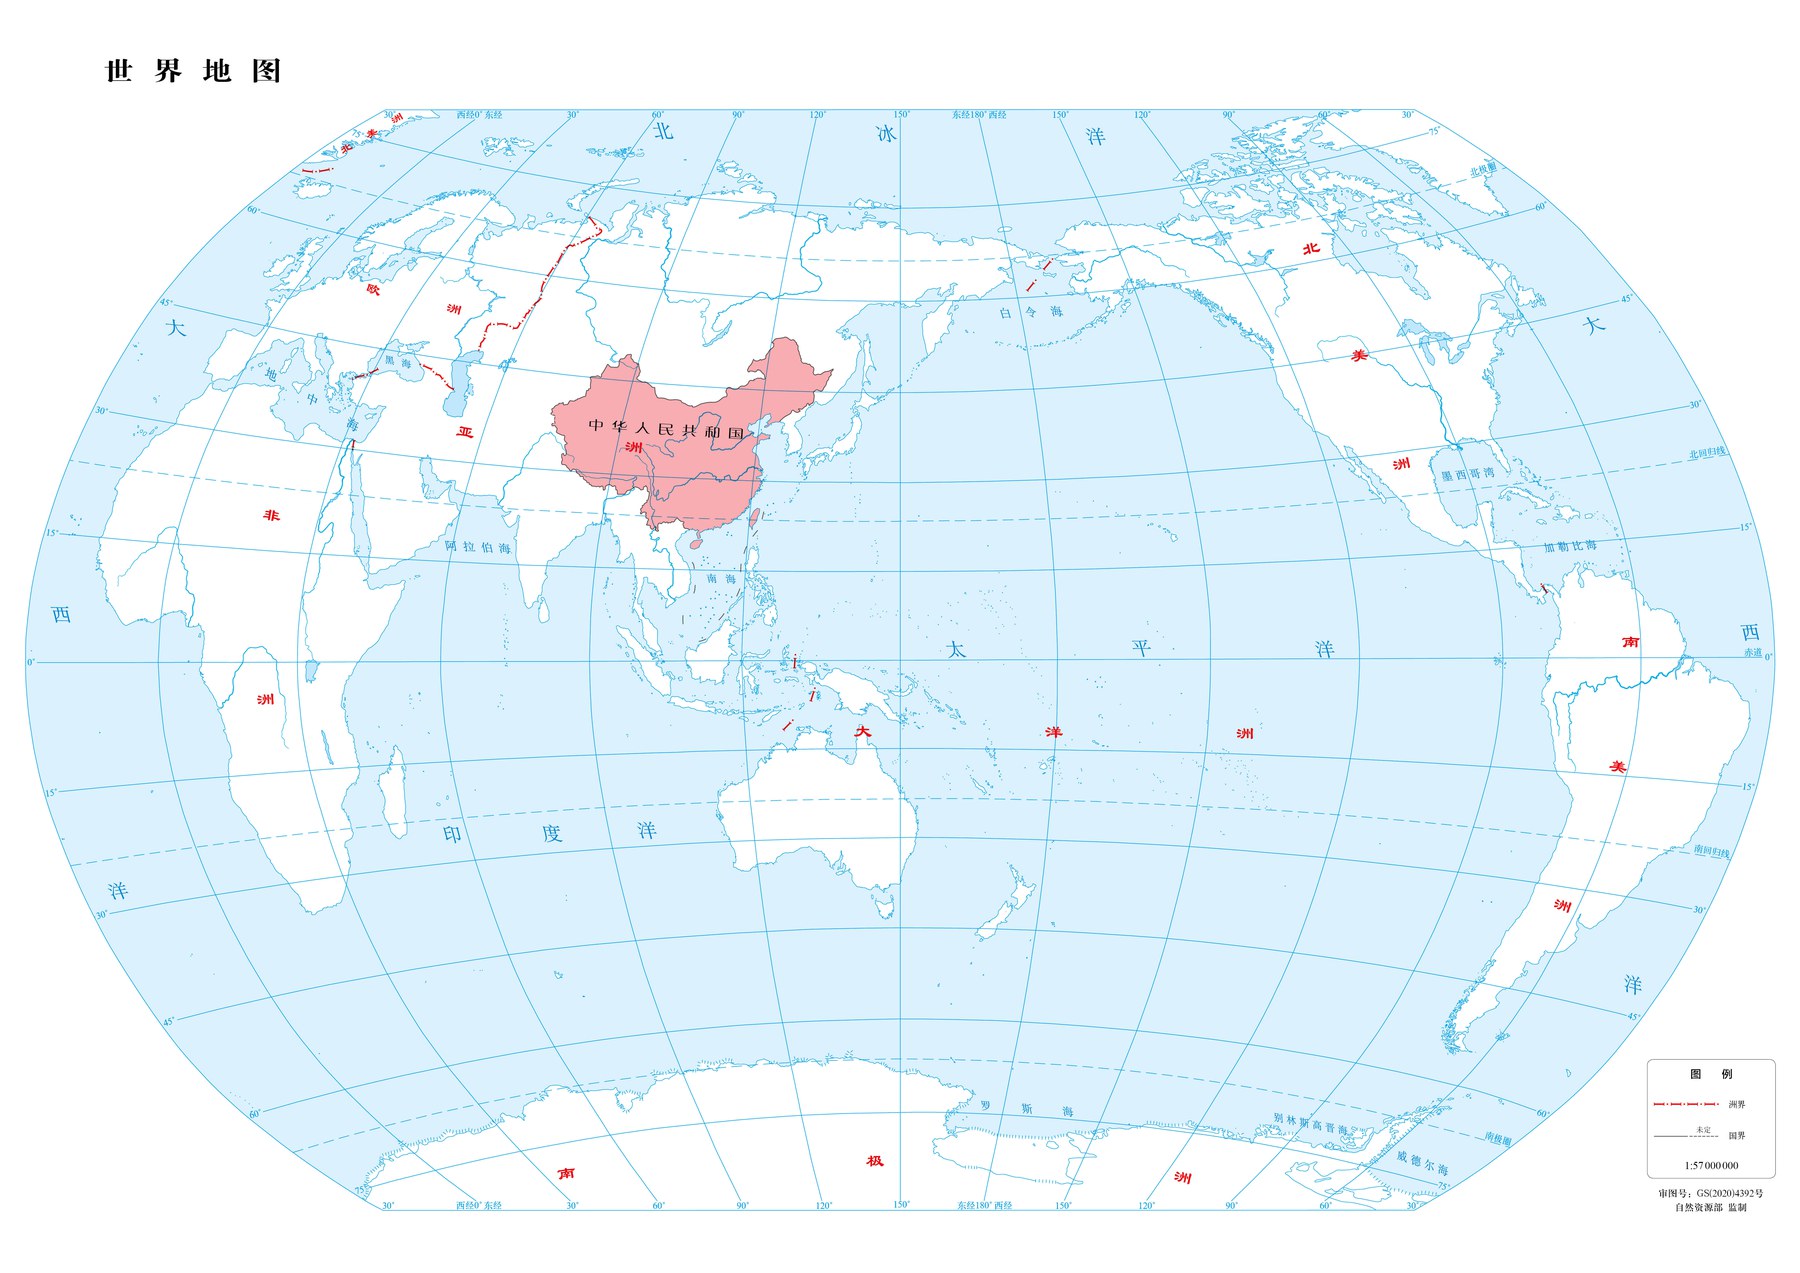
Mapa base: mapa mundial (1:57 000 000, edición de contorno) del Servicio de Mapas Estándar del Ministerio de Recursos Naturales de China N.º de aprobación del mapa: GS(2020)4392
- ChinaUniversidad China de Hong Kong (Shenzhen), Peking University, National Biomedical Imaging Center, Peking University, Peking-Tsinghua Center for Life Sciences, Shenzhen Stomatology Hospital (Pingshan) of Southern Medical University
- Hong Kong (China)Facultad de Odontología, Universidad de Hong Kong, The Prince Philip Dental Hospital
- Estados UnidosClínica Mayo
- AlemaniaLMU University Hospital Munich
- SuizaPaís colaborador
- IndiaPaís colaborador
- MalasiaSEGi University & Colleges
- AustraliaPaís colaborador
- NigeriaNational Hospital Abuja, College of Medicine, University of Lagos, Bayero University, Usmanu Danfodiyo University, Sokoto, University of Maiduguri
- EtiopíaMadda Walabu University
Por qué hace falta una evaluación dental global
Los grandes modelos de lenguaje ya se acercan a los expertos humanos en los exámenes de habilitación médica, pero la práctica clínica real exige razonar en varios pasos con información incompleta y ambigua. La odontología es especialmente exigente: combina análisis espacial, habilidades técnicas y planificación a largo plazo, adaptadas a cada paciente. Las evaluaciones actuales de LLM dentales se limitan sobre todo a los exámenes de un país o a subespecialidades concretas, se basan en preguntas de opción múltiple y miden más la memoria que el razonamiento basado en casos.
GlobalDentBench nació para cubrir esta carencia. Según el artículo, es la primera evaluación dental multinacional: 8978 preguntas validadas por expertos de 88 países y regiones de seis continentes, que abarcan 14 especialidades dentales, 3 tipos de pregunta y 3 niveles progresivos de razonamiento. Las preguntas proceden de exámenes oficiales, libros de texto de referencia e informes de casos revisados por pares; se construye con un flujo automatizado de agentes y la calibran de principio a fin 6 dentistas sénior.
El equipo evaluó 12 grandes modelos punteros (6 cerrados y 6 abiertos). Cuanto más se parecen las preguntas a casos reales y más dependen del paciente concreto, peores son las puntuaciones; en las preguntas de casos reales, casi un tercio de las respuestas incluía contenido que podría dañar al paciente. El artículo concluye que los grandes modelos actuales sirven para apoyar la búsqueda y la síntesis de conocimiento bajo supervisión experta, pero aún no pueden tomar decisiones clínicas dentales por sí solos.
El estudio lo realizaron 25 autores de instituciones como la Facultad de Odontología de la Universidad de Hong Kong, la Universidad China de Hong Kong (Shenzhen), el Hospital Estomatológico de Shenzhen (Pingshan) de la Universidad Médica del Sur, la Universidad de Pekín, la Clínica Mayo (EE. UU.) y el Hospital Universitario LMU de Múnich (Alemania), con participación del equipo de FreedomAI: el COO Junjie Zhao y el CTO Zhenyang Cai son coprimeros autores, el científico jefe de IA Benyou Wang y el científico médico jefe Junwen Wang son autores de correspondencia, y el CEO Jianquan Li participó en la inferencia de modelos y la recogida de resultados. El código de construcción y evaluación es abierto en GitHub y el subconjunto abierto GlobalDentBench-OA está disponible en Hugging Face.
en seis continentes
Origen de las preguntas
El artículo contabiliza el origen de las preguntas según el estándar M49 de la ONU. A continuación figuran los 73 países y regiones etiquetados en el conjunto de datos abierto GlobalDentBench-OA; los marcados enverdeaportaron los exámenes oficiales de habilitación dental usados en las preguntas de opción múltiple.
Asia28
- China continental
- Hong Kong (China)
- Taiwán (China)
- India
- Japón
- Corea del Sur
- Arabia Saudí
- Irán
- Emiratos Árabes Unidos
- Tailandia
- Indonesia
- Malasia
- Turquía
- Nepal
- Vietnam
- Camboya
- Irak
- Israel
- Jordania
- Filipinas
- Catar
- Siria
- Georgia
- Líbano
- Pakistán
- Singapur
- Sri Lanka
- Territorios Palestinos
Europa24
- Reino Unido
- Italia
- España
- Alemania
- Suiza
- Países Bajos
- Francia
- Portugal
- Croacia
- Hungría
- Bulgaria
- Grecia
- Rusia
- Austria
- Bélgica
- Irlanda
- Suecia
- Albania
- Chequia
- Dinamarca
- Noruega
- Rumanía
- Eslovenia
- Ucrania
África7
- Túnez
- Egipto
- Sudáfrica
- Libia
- Marruecos
- Nigeria
- Uganda
América del Norte6
- Canadá
- Estados Unidos
- México
- Costa Rica
- Guatemala
- Puerto Rico
América del Sur6
- Brasil
- Colombia
- Ecuador
- Chile
- Perú
- Venezuela
Oceanía2
- Australia
- Nueva Zelanda
Diseño de la evaluación: 3 niveles de razonamiento × 3 tipos de pregunta × 14 especialidades
Recuerdo de conocimientos
Recordar conocimientos dentales establecidos, sin razonamiento sustancial sobre el caso.
Media de 12 modelos: 74.01%
Razonamiento habitual
Razonar sobre todo a partir de los hallazgos clínicos principales, siguiendo una vía diagnóstica o terapéutica típica.
Media de 12 modelos: 55.64%
Razonamiento individualizado
El juicio final exige tener en cuenta la información individual del paciente, sus limitaciones o factores clínicos no estándar.
Media de 12 modelos: 35.71%
Opción múltiple MCQ
3,679 preguntas
Puntuación: Coincidencia de respuesta
Procedentes de exámenes oficiales de habilitación dental de Australia, Nueva Zelanda, Canadá, India, Reino Unido y Estados Unidos, miden conocimiento estandarizado.
Media de 12 modelos: 81.34%
Respuesta corta SAQ
3,709 preguntas
Puntuación: Corrección por un modelo evaluador (calibrado por dentistas)
Procedentes de libros de texto odontológicos de referencia (como Diagnosis and Treatment Planning in Dentistry); los modelos responden en lenguaje natural.
Media de 12 modelos: 64.53%
Casos clínicos CBQ
1,590 preguntas
Puntuación: 5 puntos clave puntuados uno a uno, más evaluación del riesgo para la seguridad
Generadas a partir de informes de casos revisados por pares en revistas dentales de alto impacto de 2020–2025, evalúan el razonamiento clínico en escenarios reales.
Media de 12 modelos: 22.34%
Abarca 14 especialidades dentales
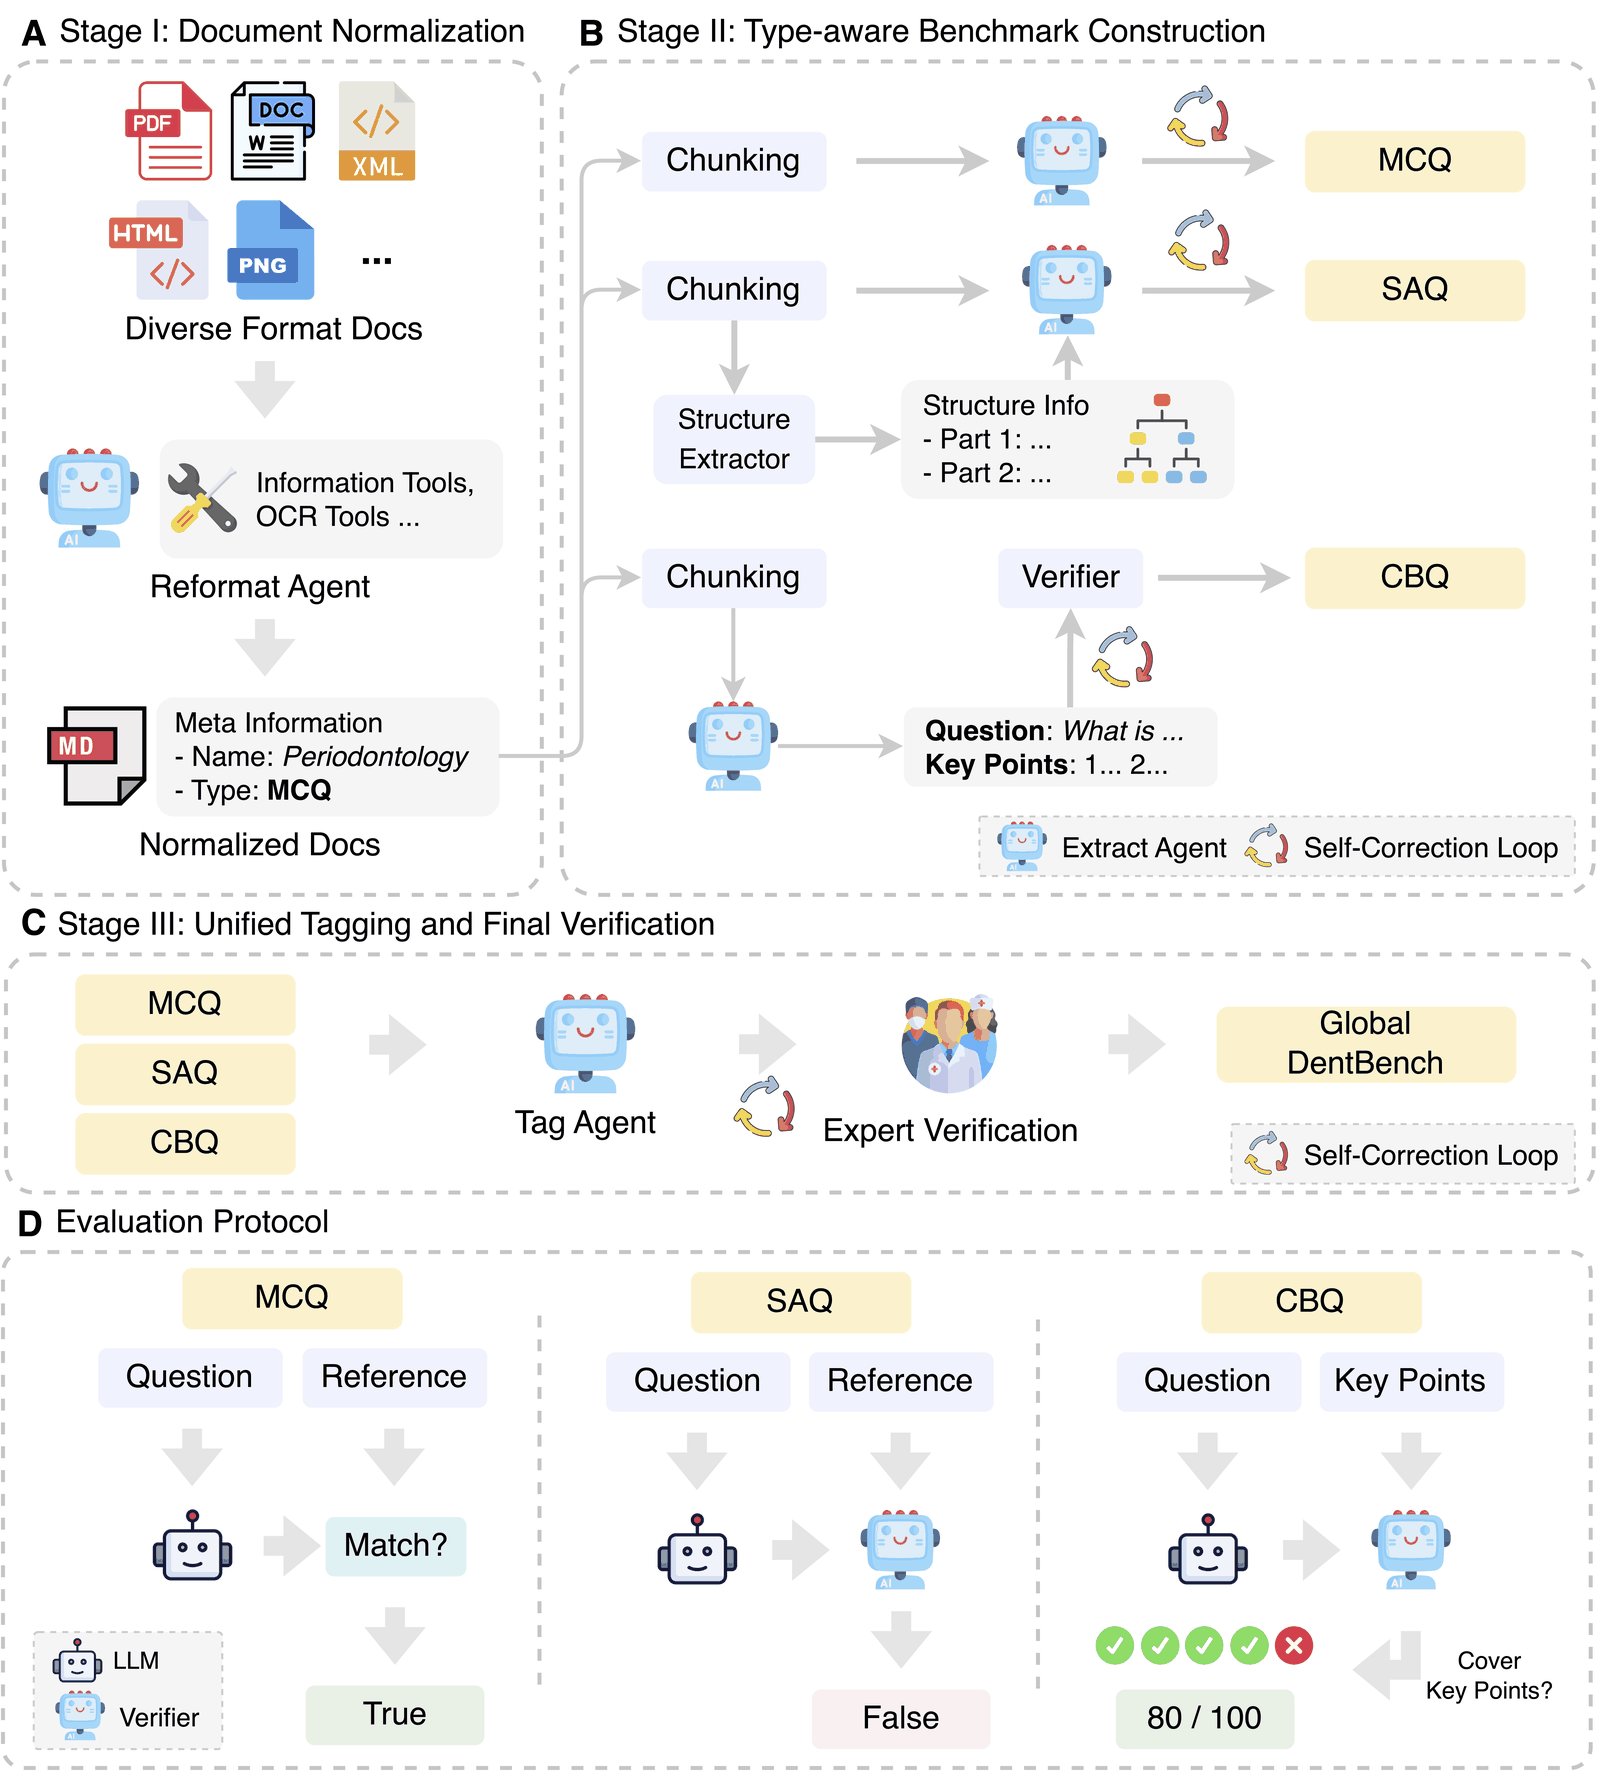
Construido por agentes, calibrado por dentistas
- 1Recopilación de fuentes de referencia
Bajo la dirección de dentistas sénior, se recopilan fuentes de exámenes oficiales de habilitación, libros de texto odontológicos de referencia e informes de casos revisados por pares de 2020–2025, y se etiquetan los países y regiones de origen según el estándar M49 de la ONU.
- 2Normalización de documentos
El Reformat Agent usa OCR (DeepSeek-OCR2), BeautifulSoup, Pandoc y otras herramientas para convertir PDF, imágenes, documentos de Office, XML y páginas web a Markdown, y añade metadatos como título, fuente y autores.
- 3Construcción de preguntas por tipo
El Extract Agent divide y luego extrae: las preguntas de opción múltiple se convierten en enunciado, opciones y respuesta; se extraen pares de pregunta y respuesta corta; para los casos clínicos se genera la pregunta y 5 puntos clave de puntuación. Cada pregunta pasa como máximo por 3 rondas de autocorrección y se descarta si sigue sin ser válida.
- 4Etiquetado unificado y revisión final
El Tag Agent etiqueta la especialidad y el nivel de razonamiento de cada pregunta: si dos rondas de predicción coinciden, se acepta; si no, una tercera ronda decide por mayoría. Solo entran en la evaluación tras la autocorrección y la revisión de dentistas sénior.
- 5Evaluación por tipo de pregunta
En opción múltiple se compara la respuesta directamente; las respuestas cortas las juzga un modelo evaluador; en los casos clínicos se puntúan 5 puntos clave (20 puntos cada uno) y cada respuesta se clasifica por seguridad: S0 segura, S1 posible daño reversible, S2 posible daño irreversible.
- 6Calibración por dentistas de principio a fin
Seis dentistas sénior colegiados (6,8 años de experiencia clínica de media) revisaron las fuentes, perfeccionaron el proceso y calibraron la puntuación del 5 de febrero al 25 de marzo de 2026, con un total de 297 horas-persona.
Hallazgos principales
Cuanto más se parece a un caso real, peor puntuación
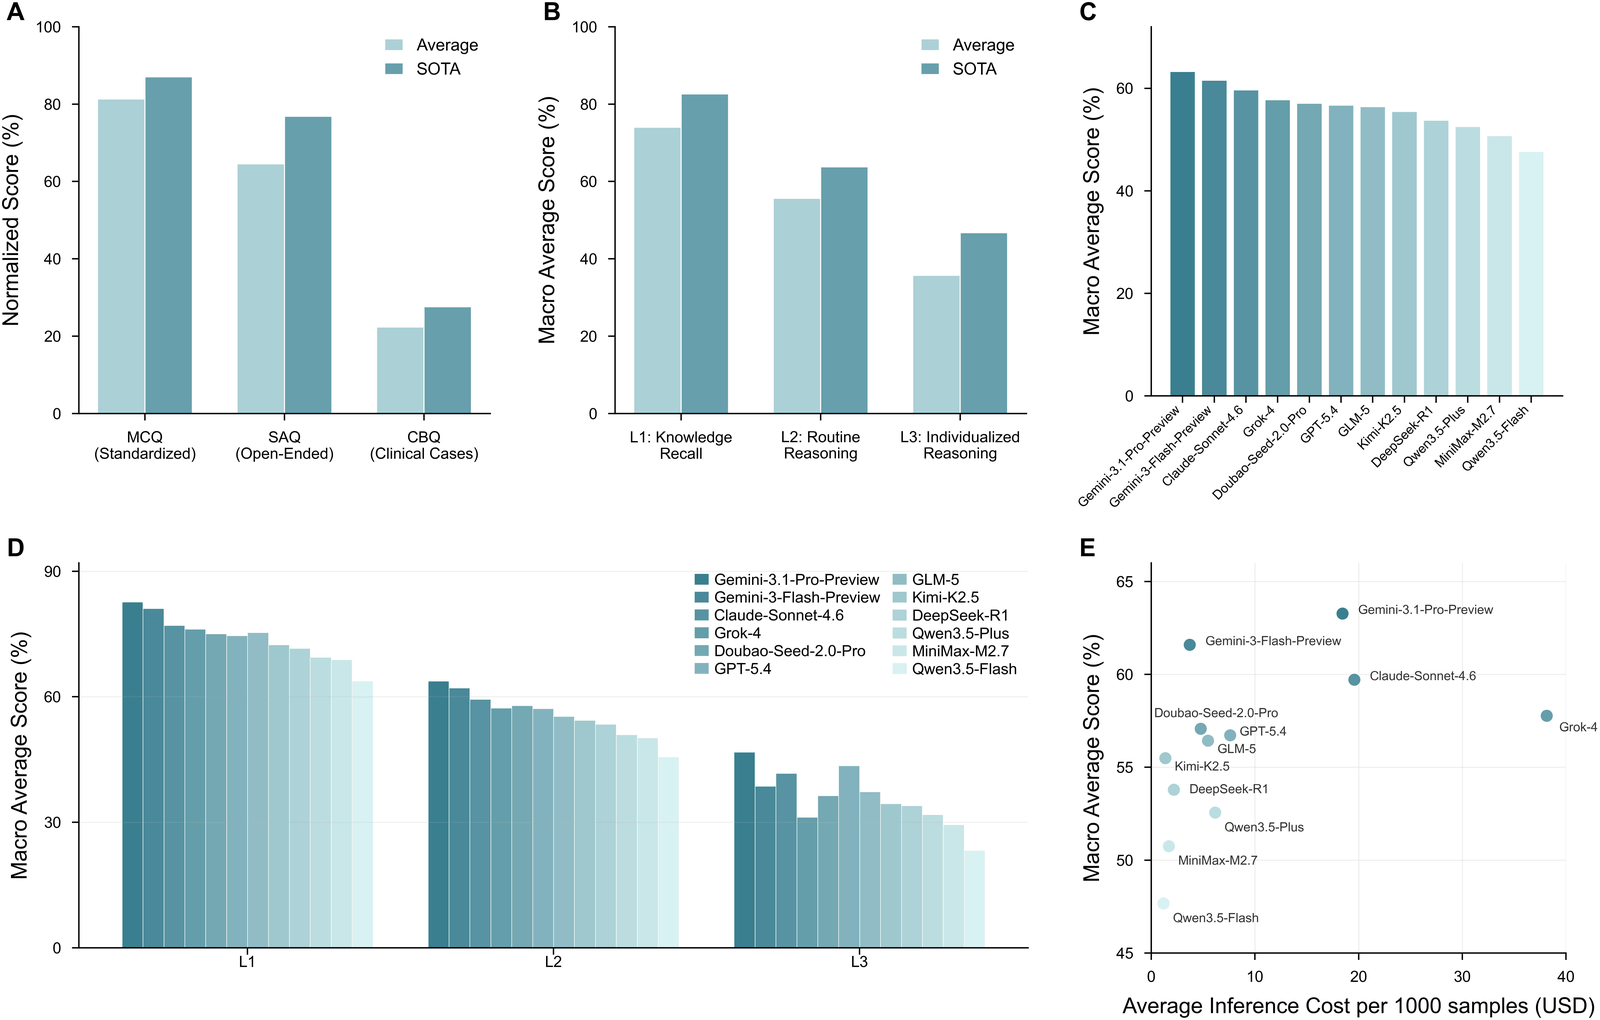
Puntuación media de 12 modelos: 81,34 % en opción múltiple, 64,53 % en respuesta corta y solo 22,34 % en casos clínicos.
El razonamiento individualizado es un punto débil común
La puntuación media cae del 74,01 % en L1 al 55,64 % en L2 y al 35,71 % en L3; todos los modelos quedan por debajo del 50 % en L3.
Más caro no significa mejor
Gemini-3.1-Pro-Preview obtiene la mejor puntuación global (63,27 %) y GLM-5 lidera entre los modelos abiertos (56,43 %). Las diferencias de coste de inferencia superan con creces a las de puntuación: un coste mayor no garantiza un mejor rendimiento.
Diferencias claras entre especialidades
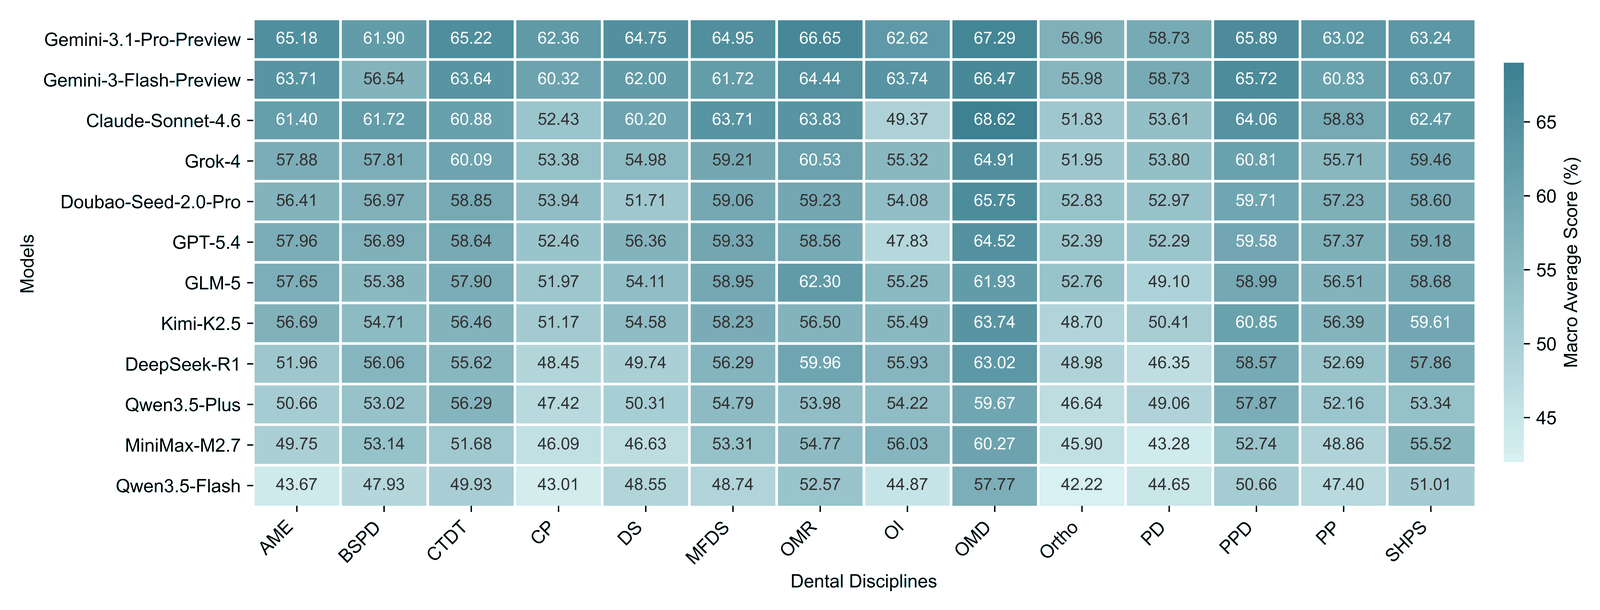
Las enfermedades de la mucosa oral tienen la mejor puntuación media (63,66 %), mientras que ortodoncia (50,59 %), odontopediatría (51,08 %) y prostodoncia convencional (51,92 %) son las más bajas: 13,07 puntos de diferencia entre la mayor y la menor.
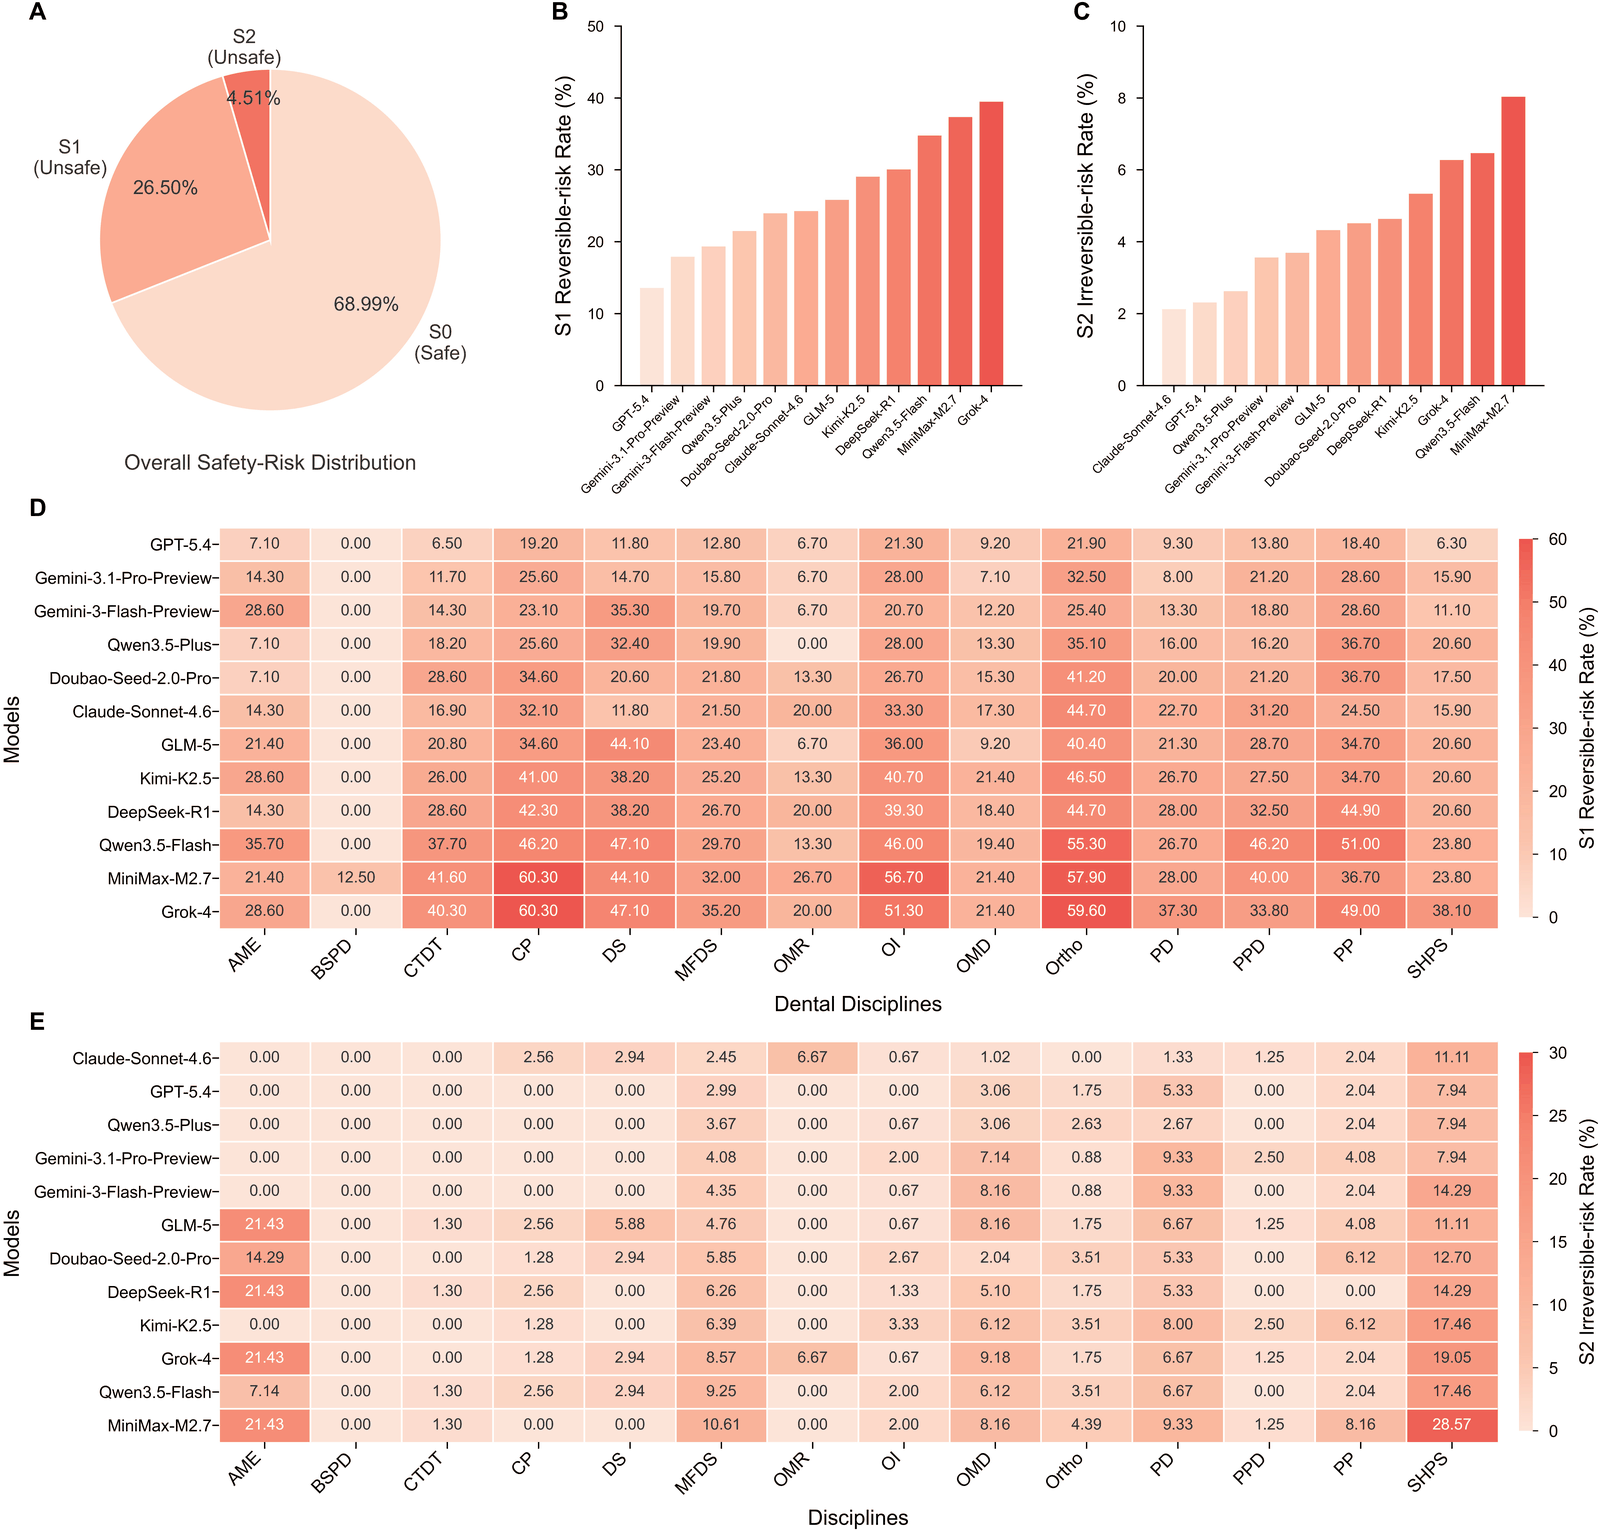
Casi una de cada tres respuestas conlleva un riesgo para la seguridad
De 19 080 respuestas a 1590 casos clínicos, el 31,01 % se consideró insegura, incluido un 4,51 % que podría causar daños irreversibles; ortodoncia tuvo la mayor proporción de respuestas inseguras, un 44,30 %.
Los riesgos graves se concentran en especialidades sensibles
Las respuestas que podrían causar daños irreversibles se concentran sobre todo en «salud sistémica, farmacología y seguridad» (14,15 % de media entre modelos), seguidas de anestesia y urgencias médicas (8,93 %) y odontopediatría (6,33 %).
La corrección automática coincide en gran medida con el criterio de los dentistas
Los dentistas validaron el 98,15 % de los resultados del modelo evaluador Gemini-3-Flash-Preview (concordancia entre dos dentistas: 96,67 %). Las preguntas de opción múltiple y respuesta corta se revisaron íntegramente por expertos, con un 99,98 % de exactitud; una muestra de 523 casos clínicos mostró un 96,78 %.
Puntuación global y coste de inferencia de modelos representativos (6 de los 12 evaluados)
| Modelo | Tipo | Puntuación global (macropromedio) | Coste por 1000 llamadas (USD) | Notas |
|---|---|---|---|---|
| Gemini-3.1-Pro-Preview | Cerrado | 63.27% | 18.45 | Mejor puntuación global |
| Gemini-3-Flash-Preview | Cerrado | 61.59% | 3.72 | Mejor relación calidad-precio entre los modelos cerrados; modelo evaluador de este estudio |
| Claude-Sonnet-4.6 | Cerrado | 59.71% | 19.59 | Cerca de los primeros, con un coste mayor |
| Grok-4 | Cerrado | 57.77% | 38.14 | Mayor coste de inferencia |
| GLM-5 | Abierto | 56.43% | 5.48 | Mejor puntuación global entre los modelos abiertos |
| Kimi-K2.5 | Abierto | 55.49% | 1.37 | Excelente relación calidad-precio entre los modelos abiertos |
Fuente: Texto de la sección 2.3 del artículo (figuras 2C y 2E). El artículo no incluye tabla de datos; las puntuaciones de los otros 6 modelos solo aparecen en gráficos.
25 autores
Dentistas e investigadores médicos y de IA de Hong Kong, China continental, Estados Unidos y Alemania, incluidos miembros del equipo de FreedomAI.
Afiliaciones
Red de expertos de FreedomAI
Bajo la dirección de reconocidos expertos dentales, especialistas e instituciones de China y del extranjero participan en la anotación, la evaluación profesional y la validación clínica de la IA dental de FreedomAI. Esta es la red de colaboración de la empresa, no la lista de autores del artículo; los profesores Lijian Jin, Falk Schwendicke y Zuolin Jin son autores de GlobalDentBench.
Lijian Jin
Facultad de Odontología, Universidad de Hong Kong Autor del artículo
- Miembro del Consejo de la FDI World Dental Federation
- Miembro del Consejo de la International Association for Dental Research (IADR)
- Presidente de la región Asia-Pacífico de la IADR
- Presidente de la Asian Pacific Society of Periodontology
- Miembro honorario del Consejo de la Asociación Estomatológica China
- Vicepresidente de la Alianza de Salud Bucodental de la Gran Área de la Bahía Guangdong–Hong Kong–Macao
Falk Schwendicke
LMU University Hospital Munich Autor del artículo
- Responsable del grupo temático dental de la Organización Mundial de la Salud (OMS) sobre IA para la salud
- Coordinador del grupo de trabajo de la Organización Internacional de Normalización (ISO) sobre IA en odontología
- Galardonado con el Distinguished Scientist Award de la IADR
Zuolin Jin
Shenzhen Stomatology Hospital (Pingshan) of Southern Medical University Autor del artículo
- Presidente del Comité de Ortodoncia de la Asociación Estomatológica China (COS)
- Miembro del Consejo de la Asociación Estomatológica China
- Miembro del Comité Ejecutivo de la Asian Pacific Orthodontic Society (APOS)
- Editor asociado de la Revista China de Ortodoncia
- Miembro de la World Federation of Orthodontists
Ming Zhong
Facultad de Estomatología, Universidad Médica de China
- Experto jefe de la Facultad de Estomatología de la Universidad Médica de China
- Beneficiario de la asignación especial del Consejo de Estado
- Fellow del International College of Dentists
- Presidente del Comité de Patología Oral de la Asociación Estomatológica China
- Editor jefe del manual nacional de formación especializada Patología oral (1.ª y 2.ª ediciones)
Especialistas colaboradores
 Bing Liu
 Daheng Li
 Dongfei Wang
 Fangjie Zhou
 Fen Liu
 Fujia Kang
 Hao Chunxiu
 Jiamin ZhaoJiaming Zhang
 Jinwen Liu
 Jinyan Chen
 Junting Wang
 Kuan Yang
 Lei Shi
 Lin Zhao
 MAO Yilin
 Menghong Li
 Mengmeng Song
 Min Huang
 Minghui Wei
 Mingxin Zhang
 Patricia Ho
 Peijuan Wang
 Peng Chen
 Rui Lu
 Shiduo Sun
 Shirong He
 Shixin Zhang
 Shuwei Huang
 Siqi Qiu
 Tai Pak Chuen Patrick
 Wu Songying
 XU Leyao
 Xiangjie Jin
 Xue Qiao
 Yang Jiang
 Yaqiu Zhang
 Yefeng Wu
 Yidan Guo
 Yifan Zheng
 Ying Wang
 Yujia Wu
 Zhenlai Zhu
 Zhiqiang Deng
 Zhuoying Li
Instituciones colaboradoras
 Universidad China de Hong Kong (Shenzhen)China
 Facultad de Odontología, Universidad de Hong KongHong Kong (China)
 Peking UniversityChina
 National Biomedical Imaging Center, Peking UniversityChina
 Peking-Tsinghua Center for Life SciencesChina
 The Prince Philip Dental HospitalHong Kong (China)
 Mayo ClinicEstados Unidos
 LMU University Hospital MunichAlemania
 SEGi University & CollegesMalasia
 National Hospital AbujaNigeria
 College of Medicine, University of LagosNigeria
 Bayero UniversityNigeria
 Usmanu Danfodiyo University, SokotoNigeria
 University of MaiduguriNigeria
 Madda Walabu UniversityEtiopía
Países y regiones colaboradores
Cita
@article{zhao2026globaldentbench,
  title={GlobalDentBench: A Multinational Benchmark for Evaluating LLM Clinical Reasoning in Dentistry with Expert Calibration},
  author={Junjie Zhao and Jingyi Liang and Zhenyang Cai and Jiaming Zhang and Zhenwei Wen and Shuzhi Deng and Wenjing Yi and Chunfeng Luo and Hexian Zhang and Junying Chen and Tianrui Liu and Zhuhui Bai and Zixu Zhang and Pradeep Singh and Xiang Liu and Jianquan Li and Nhan L Tran and Falk Schwendicke and Zuolin Jin and Lijian Jin and Liangyi Chen and Wei-fa Yang and Benyou Wang and Junwen Wang and Shan Jiang},
  journal={npj Digital Medicine},
  year={2026},
  note={Accepted},
  url={https://arxiv.org/abs/2605.24636}
}