
Évaluation dentaire
Avec des experts dentaires du monde entier, nous évaluons comment les grands modèles raisonnent en pratique dentaire réelle, et quels risques ils présentent.
8 978 questions validées par des experts, issues de 88 pays et régions et de 14 spécialités dentaires, pour évaluer le raisonnement clinique et les risques de sécurité des grands modèles en dentisterie.
Global Partners
Notre réseau de partenaires couvre 10 pays et régions
16 universités, hôpitaux et instituts de recherche, avec des experts dentaires de Hong Kong, de Chine continentale et de l'étranger, participent au développement, à l'évaluation et à la validation clinique de l'IA dentaire de FreedomAI.
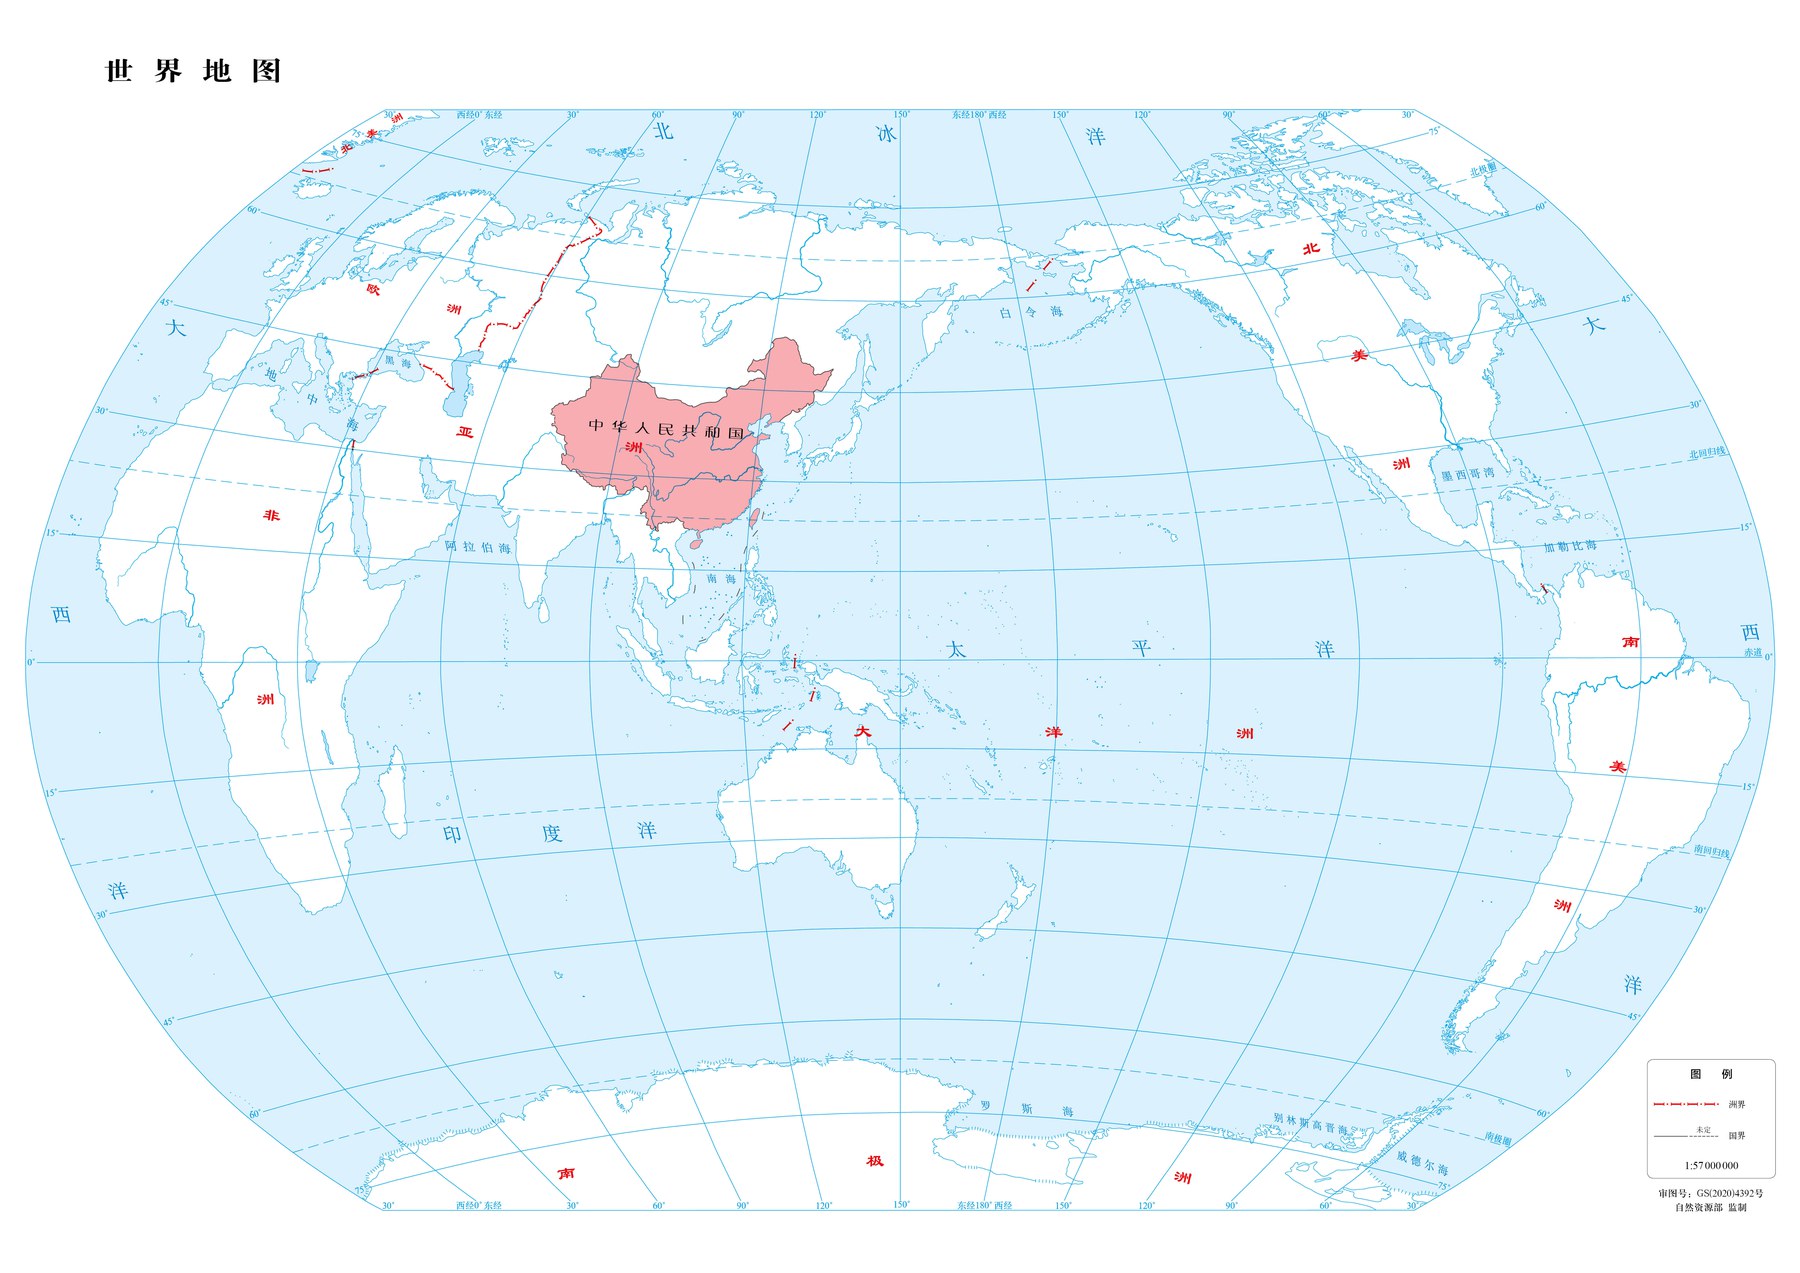
Fond de carte : carte du monde (1/57 000 000, édition contours) du service de cartes standard du ministère des Ressources naturelles de Chine N° d'approbation de la carte : GS(2020)4392
- ChineUniversité chinoise de Hong Kong (Shenzhen), Peking University, National Biomedical Imaging Center, Peking University, Peking-Tsinghua Center for Life Sciences, Shenzhen Stomatology Hospital (Pingshan) of Southern Medical University
- Hong Kong (Chine)Faculté de médecine dentaire, Université de Hong Kong, The Prince Philip Dental Hospital
- États-UnisClinique Mayo
- AllemagneLMU University Hospital Munich
- SuissePays partenaire
- IndePays partenaire
- MalaisieSEGi University & Colleges
- AustraliePays partenaire
- NigeriaNational Hospital Abuja, College of Medicine, University of Lagos, Bayero University, Usmanu Danfodiyo University, Sokoto, University of Maiduguri
- ÉthiopieMadda Walabu University
Pourquoi une évaluation dentaire mondiale
Les grands modèles de langage approchent désormais les experts humains aux examens médicaux, mais la pratique clinique réelle exige un raisonnement en plusieurs étapes à partir d'informations incomplètes et ambiguës. La dentisterie est particulièrement exigeante : elle combine analyse spatiale, gestes techniques et planification à long terme, adaptés à chaque patient. Les évaluations existantes des LLM dentaires se limitent surtout aux examens d'un seul pays ou à quelques sous-spécialités, reposent sur des QCM et mesurent davantage la mémoire que le raisonnement sur des cas.
GlobalDentBench a été créé pour combler ce manque. Selon l'article, c'est la première évaluation dentaire multinationale : 8 978 questions validées par des experts, issues de 88 pays et régions sur six continents, couvrant 14 spécialités dentaires, 3 types de questions et 3 niveaux de raisonnement progressifs. Les questions proviennent d'examens officiels, de manuels de référence et de rapports de cas évalués par des pairs ; le benchmark est construit par un pipeline d'agents automatisé et calibré de bout en bout par 6 dentistes expérimentés.
L'équipe a évalué 12 grands modèles de pointe (6 fermés, 6 ouverts). Plus les questions se rapprochent de cas réels et dépendent du patient, plus les scores baissent ; sur les questions de cas réels, près d'un tiers des réponses contenait des éléments susceptibles de nuire au patient. L'article conclut que les grands modèles actuels peuvent aider à rechercher et synthétiser les connaissances sous supervision d'experts, mais ne peuvent pas encore prendre seuls des décisions cliniques dentaires.
L'étude réunit 25 auteurs d'institutions dont la Faculté de médecine dentaire de l'Université de Hong Kong, l'Université chinoise de Hong Kong (Shenzhen), l'Hôpital stomatologique de Shenzhen (Pingshan) de l'Université médicale du Sud, l'Université de Pékin, la Clinique Mayo (États-Unis) et l'Hôpital universitaire LMU de Munich (Allemagne), avec la participation de l'équipe FreedomAI : le COO Junjie Zhao et le CTO Zhenyang Cai sont co-premiers auteurs, le directeur scientifique IA Benyou Wang et le directeur scientifique médical Junwen Wang sont auteurs correspondants, et le CEO Jianquan Li a contribué à l'inférence des modèles et à la collecte des résultats. Le code de construction et d'évaluation est en open source sur GitHub, et le sous-ensemble ouvert GlobalDentBench-OA est disponible sur Hugging Face.
sur six continents
Origine des questions
L'article recense l'origine des questions selon la norme M49 de l'ONU. Voici les 73 pays et régions étiquetés dans le jeu de données ouvert GlobalDentBench-OA ; ceux envertont fourni les examens officiels d'exercice dentaire utilisés pour les questions à choix multiples.
Asie28
- Chine continentale
- Hong Kong (Chine)
- Taïwan (Chine)
- Inde
- Japon
- Corée du Sud
- Arabie saoudite
- Iran
- Émirats arabes unis
- Thaïlande
- Indonésie
- Malaisie
- Turquie
- Népal
- Viêt Nam
- Cambodge
- Irak
- Israël
- Jordanie
- Philippines
- Qatar
- Syrie
- Géorgie
- Liban
- Pakistan
- Singapour
- Sri Lanka
- Territoires palestiniens
Europe24
- Royaume-Uni
- Italie
- Espagne
- Allemagne
- Suisse
- Pays-Bas
- France
- Portugal
- Croatie
- Hongrie
- Bulgarie
- Grèce
- Russie
- Autriche
- Belgique
- Irlande
- Suède
- Albanie
- Tchéquie
- Danemark
- Norvège
- Roumanie
- Slovénie
- Ukraine
Afrique7
- Tunisie
- Égypte
- Afrique du Sud
- Libye
- Maroc
- Nigeria
- Ouganda
Amérique du Nord6
- Canada
- États-Unis
- Mexique
- Costa Rica
- Guatemala
- Porto Rico
Amérique du Sud6
- Brésil
- Colombie
- Équateur
- Chili
- Pérou
- Venezuela
Océanie2
- Australie
- Nouvelle-Zélande
Conception : 3 niveaux de raisonnement × 3 types de questions × 14 spécialités
Rappel des connaissances
Se rappeler des connaissances dentaires établies, sans raisonnement substantiel sur le cas.
Moyenne de 12 modèles : 74.01%
Raisonnement courant
Raisonner surtout à partir des signes cliniques principaux, selon une démarche diagnostique ou thérapeutique typique.
Moyenne de 12 modèles : 55.64%
Raisonnement individualisé
La décision finale exige de tenir compte des informations propres au patient, de ses contraintes ou de facteurs cliniques non standard.
Moyenne de 12 modèles : 35.71%
QCM MCQ
3,679 questions
Notation : Correspondance de la réponse
Issues d'examens officiels d'exercice dentaire d'Australie, de Nouvelle-Zélande, du Canada, d'Inde, du Royaume-Uni et des États-Unis, pour évaluer des connaissances standardisées.
Moyenne de 12 modèles : 81.34%
Réponse courte SAQ
3,709 questions
Notation : Notée par un modèle évaluateur (calibré par des dentistes)
Issues de manuels dentaires de référence (comme Diagnosis and Treatment Planning in Dentistry) ; les modèles répondent en langage naturel.
Moyenne de 12 modèles : 64.53%
Cas cliniques CBQ
1,590 questions
Notation : 5 points clés notés un par un, avec évaluation des risques pour la sécurité
Générées à partir de rapports de cas évalués par des pairs, publiés entre 2020 et 2025 dans des revues dentaires à fort impact, pour évaluer le raisonnement clinique en situation réelle.
Moyenne de 12 modèles : 22.34%
Couvre 14 spécialités dentaires
Construit par des agents, calibré par des dentistes
- 1Collecte de sources de référence
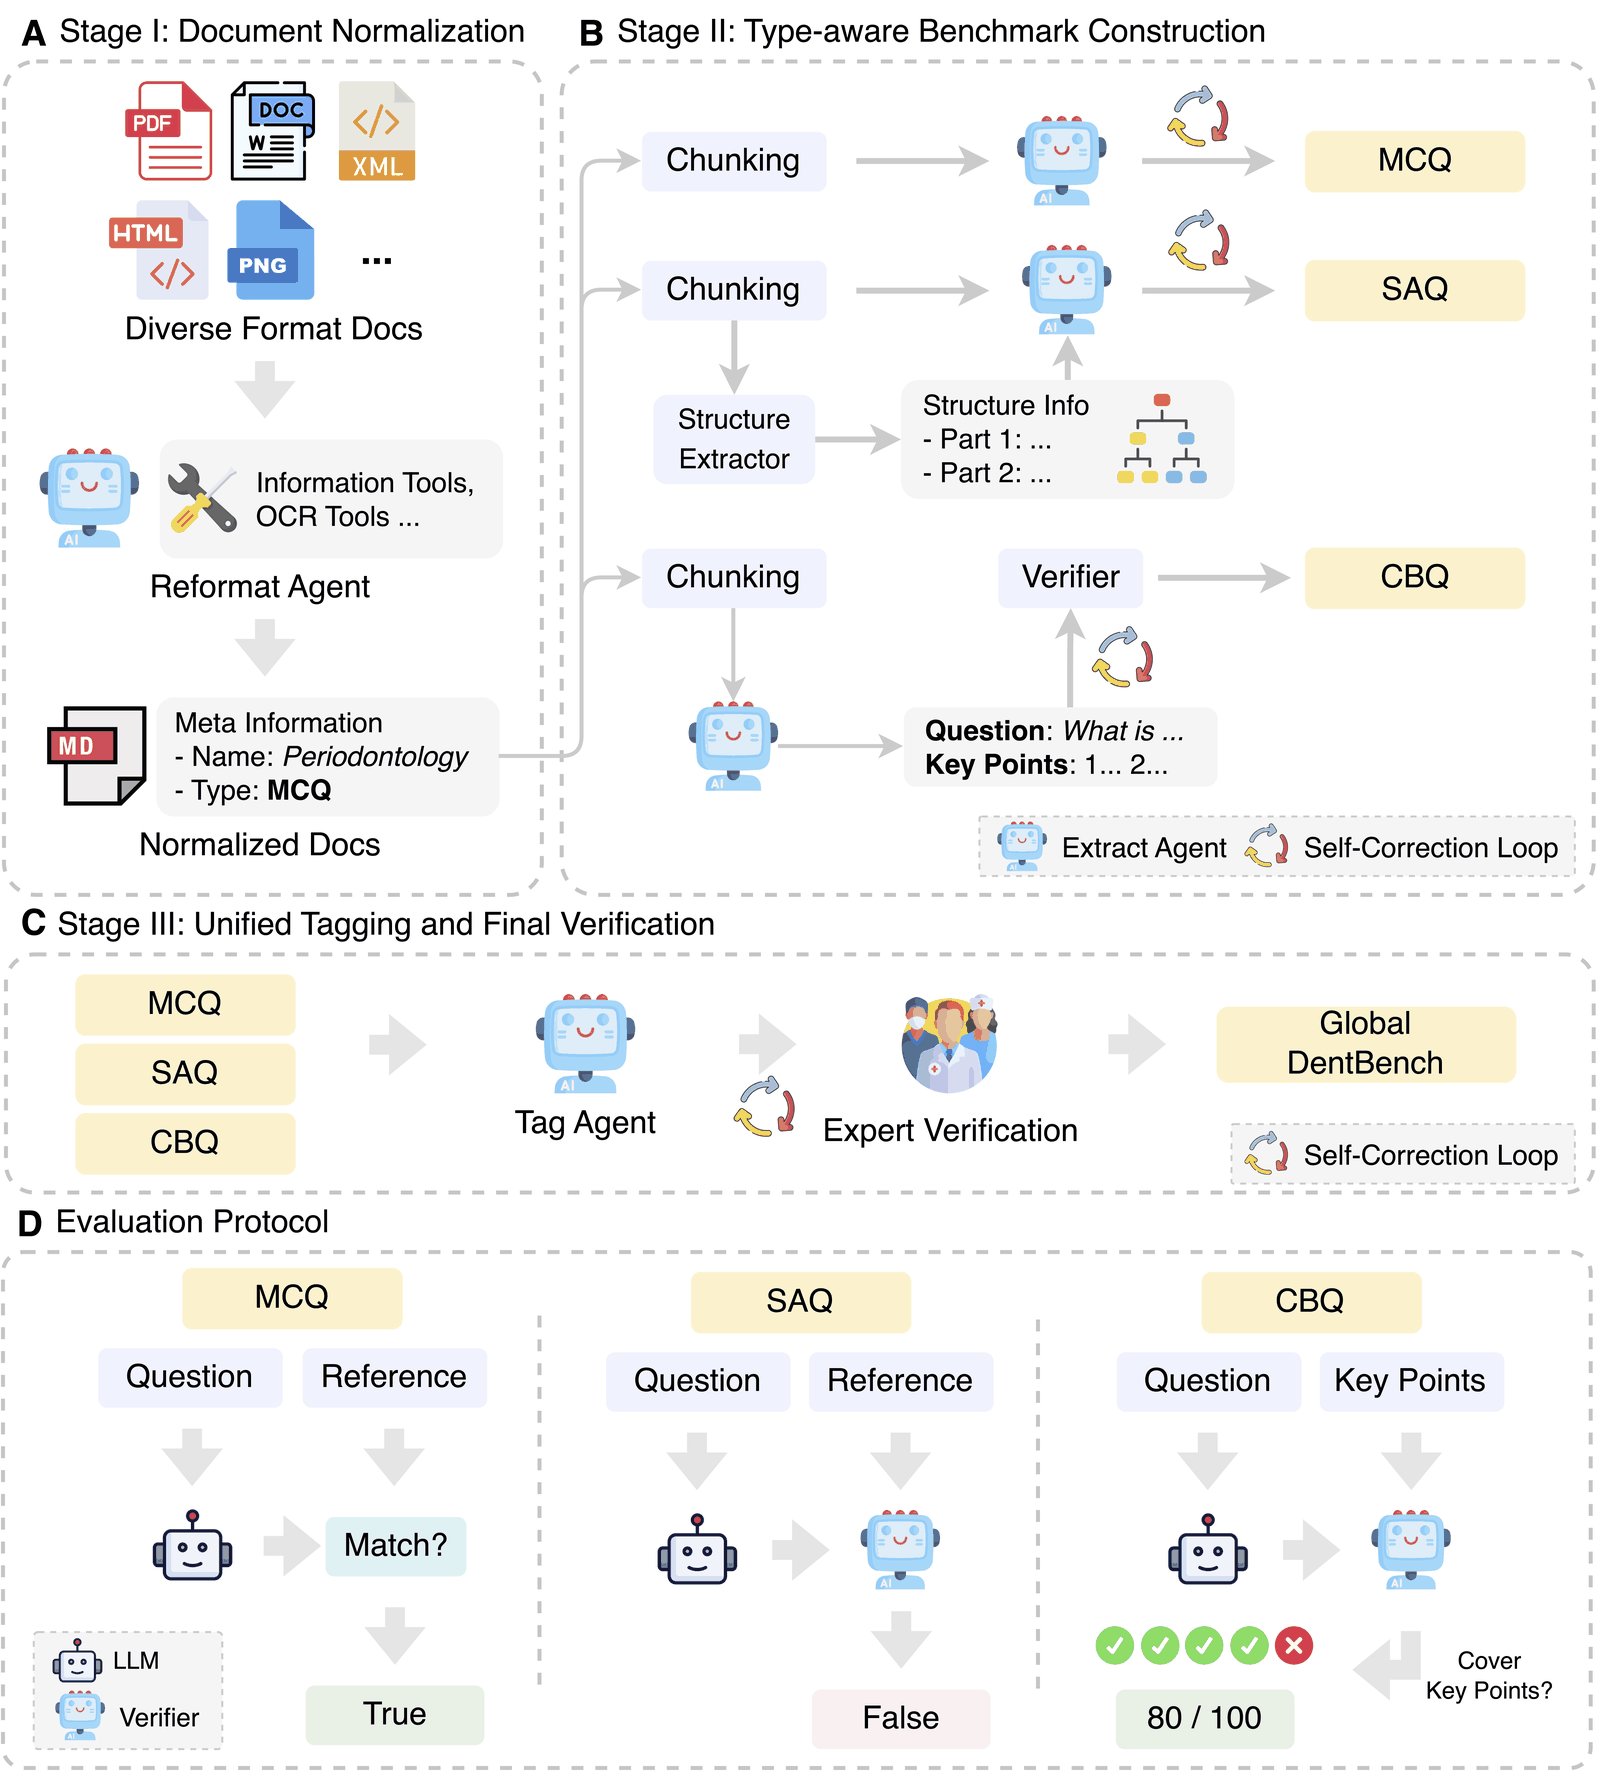
Sous la conduite de dentistes expérimentés, les sources sont collectées dans les examens officiels d'exercice et de qualification, les manuels dentaires de référence et les rapports de cas évalués par des pairs publiés entre 2020 et 2025, avec l'indication des pays et régions d'origine selon la norme M49 de l'ONU.
- 2Normalisation des documents
Le Reformat Agent utilise l'OCR (DeepSeek-OCR2), BeautifulSoup, Pandoc et d'autres outils pour convertir PDF, images, documents Office, XML et pages web en Markdown, en ajoutant des métadonnées comme le titre, la source et les auteurs.
- 3Construction des questions par type
L'Extract Agent découpe puis extrait : les QCM sont structurés en énoncé, options et réponse ; des paires question-réponse courtes sont extraites ; pour les cas cliniques, une question et 5 points clés de notation sont produits. Chaque question passe au plus par 3 cycles d'autocorrection et est écartée si elle reste non conforme.
- 4Étiquetage unifié et relecture finale
Le Tag Agent attribue à chaque question une spécialité et un niveau de raisonnement : si deux prédictions concordent, l'étiquette est retenue ; sinon, une troisième tranche à la majorité. Les questions n'intègrent le benchmark qu'après autocorrection et relecture par des dentistes expérimentés.
- 5Évaluation par type de question
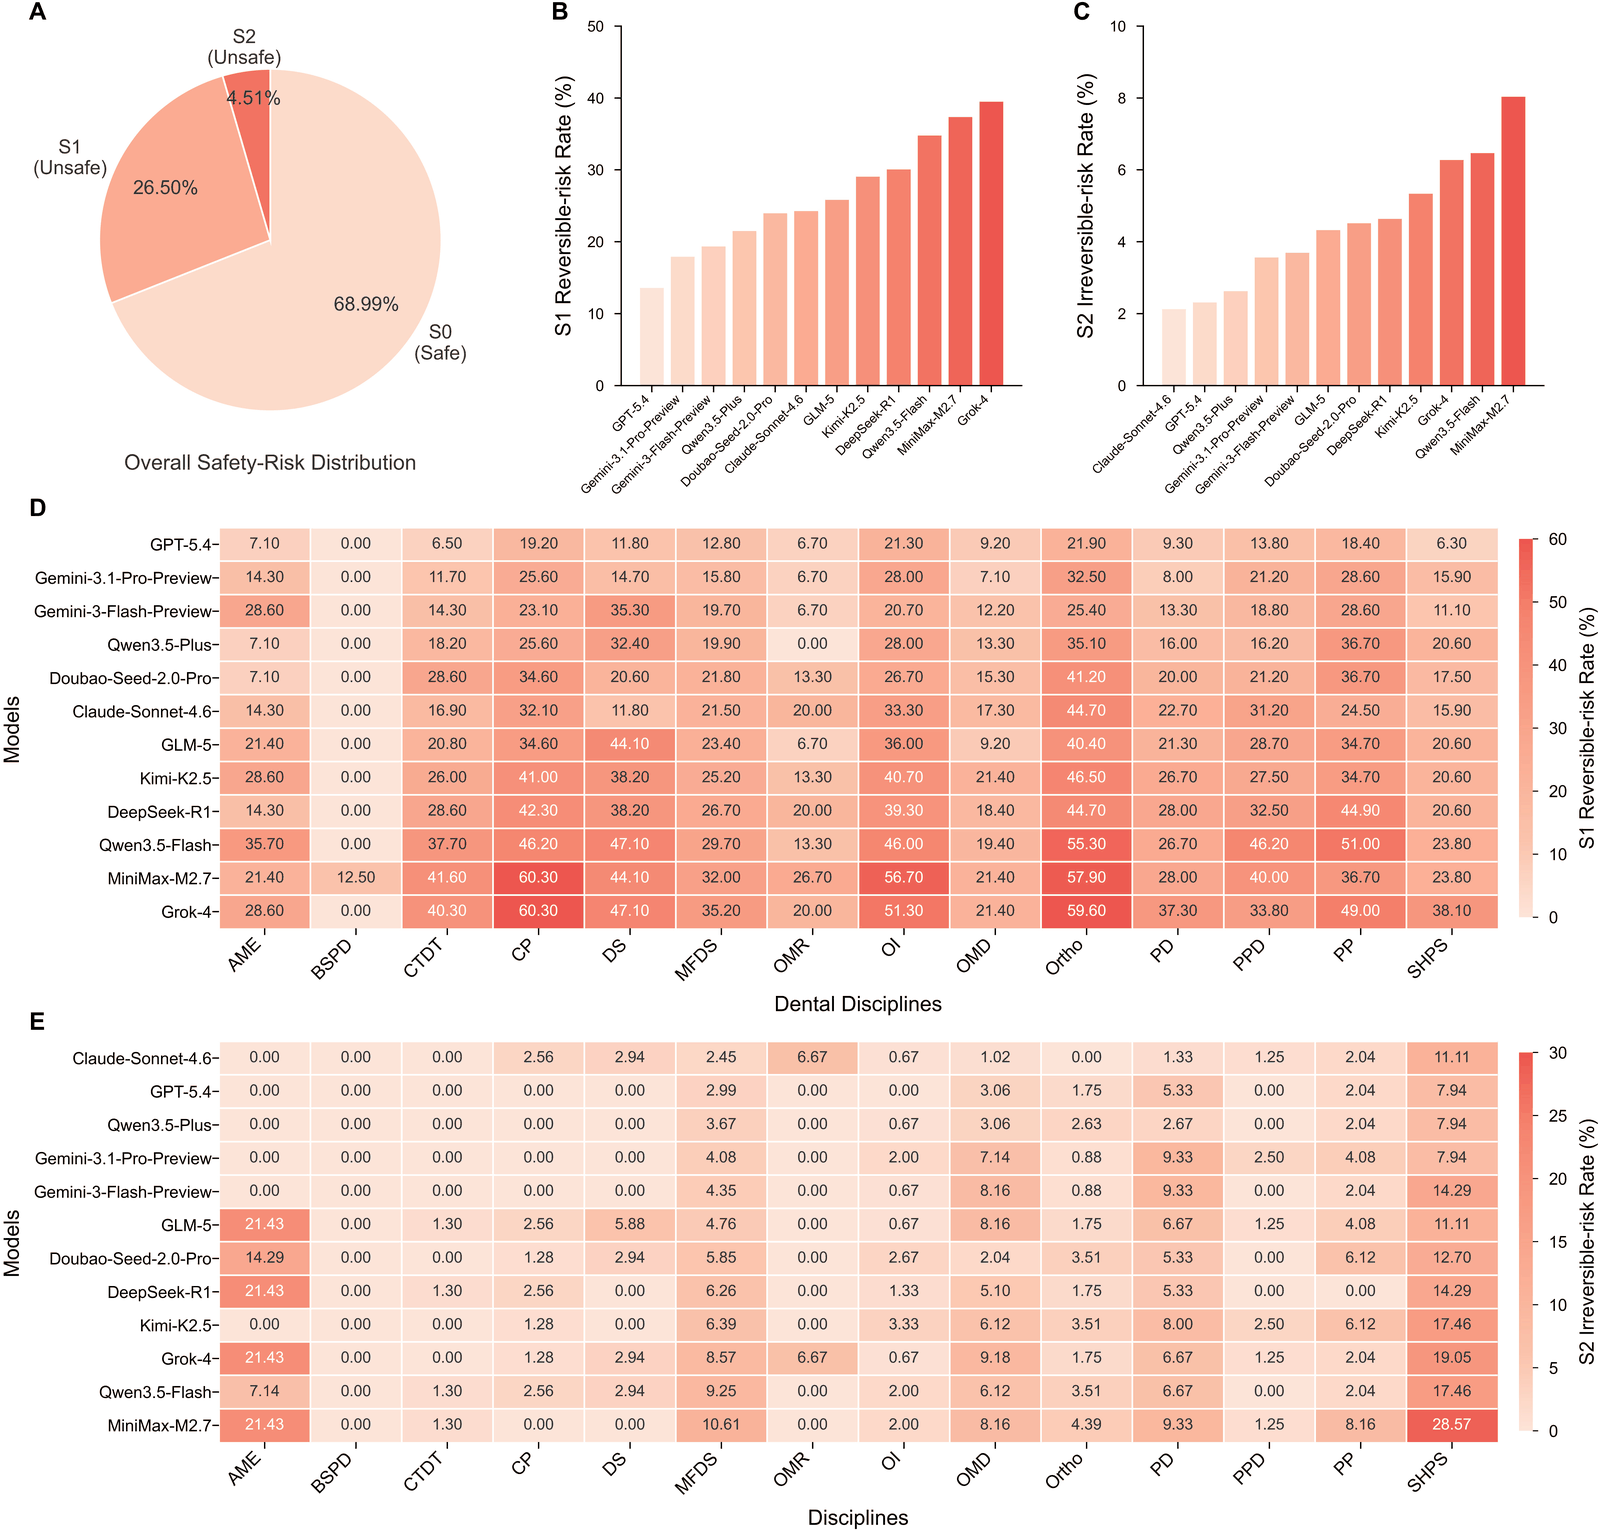
Les QCM sont comparés directement à la réponse ; les réponses courtes sont jugées par un modèle évaluateur ; les cas cliniques sont notés sur 5 points clés (20 points chacun), et chaque réponse reçoit un niveau de sécurité : S0 sûre, S1 dommage réversible possible, S2 dommage irréversible possible.
- 6Calibrage par des dentistes de bout en bout
Six dentistes expérimentés diplômés (6,8 ans d'expérience clinique en moyenne) ont vérifié les sources, optimisé le processus et calibré la notation du 5 février au 25 mars 2026, pour un total de 297 heures-personnes.
Principaux résultats
Plus on se rapproche des cas réels, plus les scores baissent
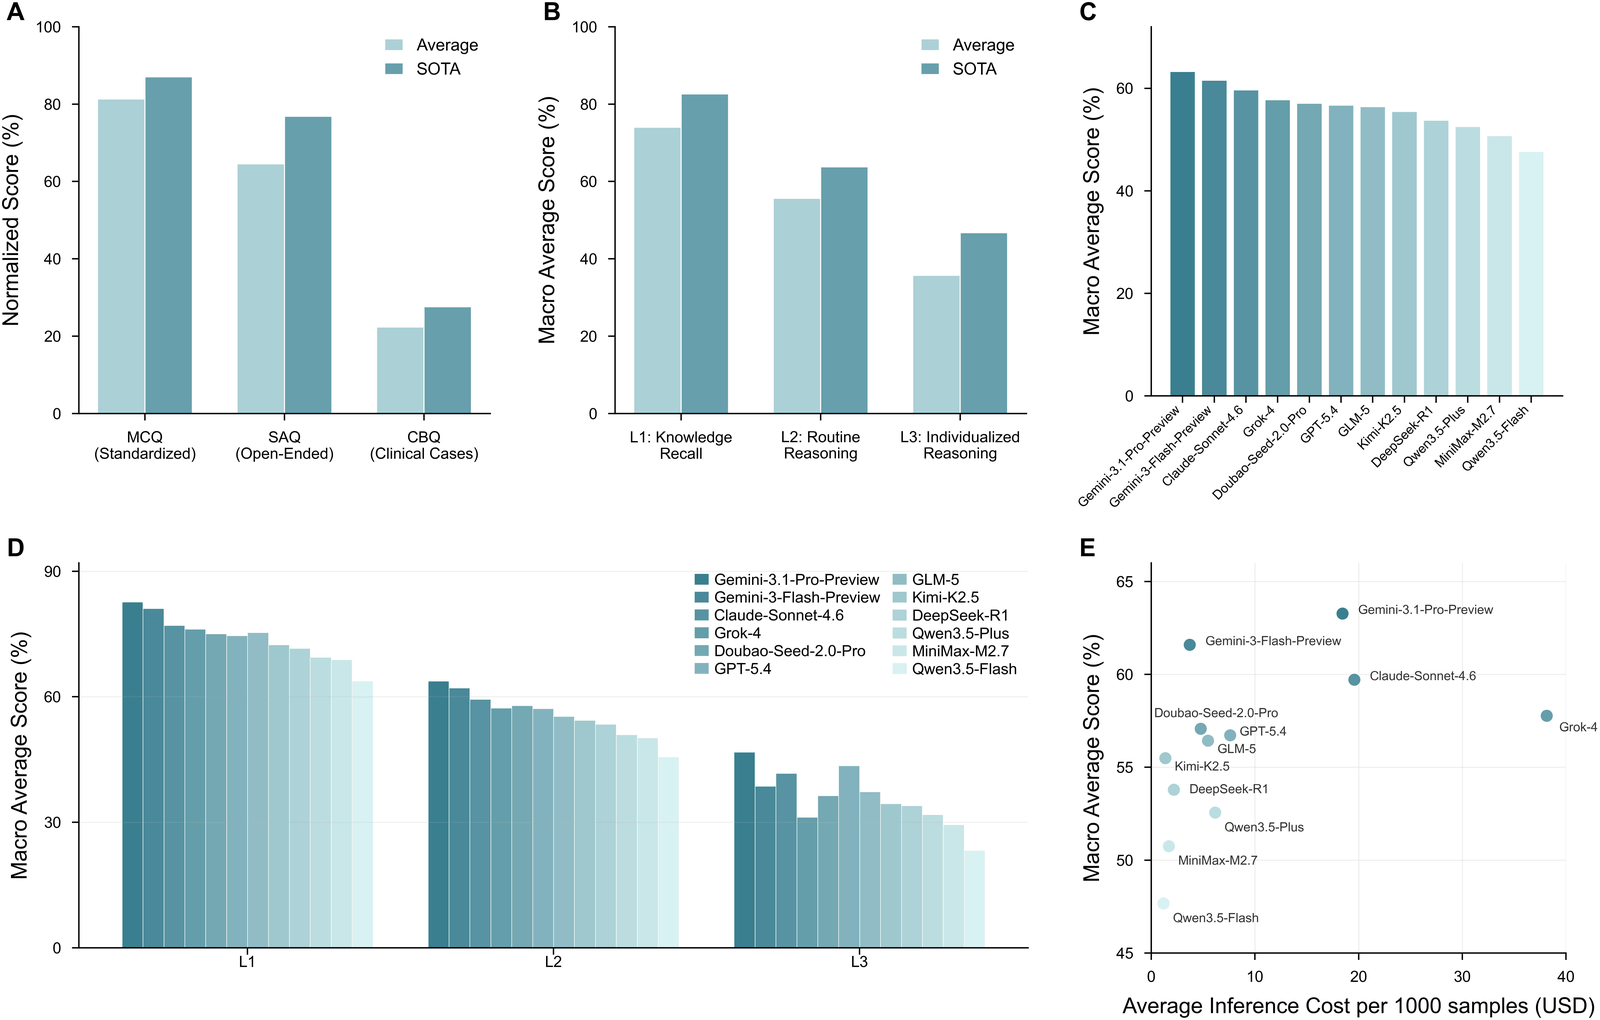
Scores moyens de 12 modèles : 81,34 % aux QCM, 64,53 % aux réponses courtes et seulement 22,34 % aux cas cliniques.
Le raisonnement individualisé est une faiblesse commune
Le score moyen passe de 74,01 % en L1 à 55,64 % en L2, puis 35,71 % en L3 ; tous les modèles restent sous 50 % en L3.
Plus cher ne veut pas dire meilleur
Gemini-3.1-Pro-Preview obtient le meilleur score global (63,27 %) et GLM-5 domine les modèles ouverts (56,43 %). Les écarts de coût d'inférence dépassent de loin les écarts de score : un coût plus élevé ne garantit pas de meilleures performances.
Des écarts nets entre spécialités
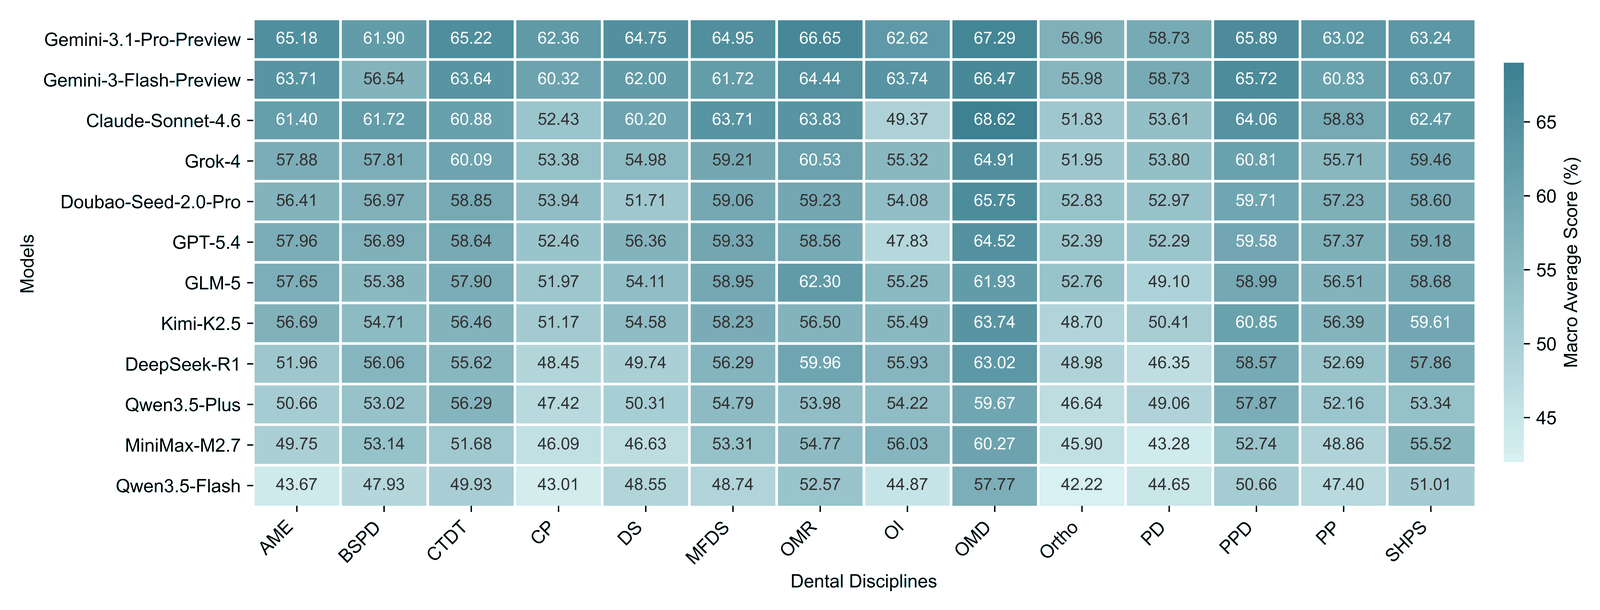
Les pathologies de la muqueuse buccale obtiennent le meilleur score moyen (63,66 %), tandis que l'orthodontie (50,59 %), l'odontologie pédiatrique (51,08 %) et la prothèse conventionnelle (51,92 %) sont les plus faibles, soit 13,07 points d'écart entre la meilleure et la moins bonne.
Près d'une réponse sur trois présente un risque
Sur 19 080 réponses à 1 590 cas cliniques, 31,01 % ont été jugées dangereuses, dont 4,51 % pouvant causer un dommage irréversible ; l'orthodontie présente la plus forte proportion de réponses dangereuses, avec 44,30 %.
Les risques graves se concentrent dans les spécialités sensibles
Les réponses pouvant causer un dommage irréversible se concentrent surtout dans la catégorie « santé générale, pharmacologie et sécurité » (14,15 % en moyenne selon les modèles), suivie de l'anesthésie et des urgences médicales (8,93 %) et de l'odontologie pédiatrique (6,33 %).
La notation automatique concorde fortement avec le jugement des dentistes
Les dentistes ont validé 98,15 % des résultats du modèle évaluateur Gemini-3-Flash-Preview (concordance entre deux dentistes : 96,67 %). Les QCM et réponses courtes ont été entièrement relus par des experts, avec 99,98 % d'exactitude ; un échantillon de 523 cas cliniques affiche 96,78 %.
Score global et coût d'inférence de modèles représentatifs (6 des 12 évalués)
| Modèle | Type | Score global (macro-moyenne) | Coût pour 1 000 appels (USD) | Remarques |
|---|---|---|---|---|
| Gemini-3.1-Pro-Preview | Fermé | 63.27% | 18.45 | Meilleur score global |
| Gemini-3-Flash-Preview | Fermé | 61.59% | 3.72 | Meilleur rapport qualité-prix parmi les modèles fermés ; modèle évaluateur de l'étude |
| Claude-Sonnet-4.6 | Fermé | 59.71% | 19.59 | Proche du haut du classement, pour un coût plus élevé |
| Grok-4 | Fermé | 57.77% | 38.14 | Coût d'inférence le plus élevé |
| GLM-5 | Ouvert | 56.43% | 5.48 | Meilleur score global parmi les modèles ouverts |
| Kimi-K2.5 | Ouvert | 55.49% | 1.37 | Excellent rapport qualité-prix parmi les modèles ouverts |
Source : Texte de la section 2.3 de l'article (figures 2C et 2E). L'article ne fournit pas de tableau de données ; les scores des 6 autres modèles n'apparaissent que sur des graphiques.
25 auteurs
Des dentistes et des chercheurs en médecine et en IA de Hong Kong, de Chine continentale, des États-Unis et d'Allemagne, dont des membres de l'équipe FreedomAI.
Affiliations
Réseau d'experts de FreedomAI
Sous la conduite d'experts dentaires renommés, des spécialistes et des institutions de Chine et de l'étranger participent à l'annotation, à l'évaluation professionnelle et à la validation clinique de l'IA dentaire de FreedomAI. Il s'agit du réseau de partenaires de l'entreprise, et non de la liste des auteurs de l'article ; les professeurs Lijian Jin, Falk Schwendicke et Zuolin Jin sont auteurs de GlobalDentBench.
Lijian Jin
Faculté de médecine dentaire, Université de Hong Kong Auteur de l'article
- Membre du Conseil de la FDI World Dental Federation
- Membre du conseil d'administration de l'International Association for Dental Research (IADR)
- Président de la région Asie-Pacifique de l'IADR
- Président de l'Asian Pacific Society of Periodontology
- Membre honoraire du conseil de l'Association stomatologique chinoise
- Vice-président de l'Alliance pour la santé bucco-dentaire de la Grande Baie Guangdong–Hong Kong–Macao
Falk Schwendicke
LMU University Hospital Munich Auteur de l'article
- Responsable du groupe thématique dentaire de l'Organisation mondiale de la santé (OMS) sur l'IA pour la santé
- Animateur du groupe de travail de l'Organisation internationale de normalisation (ISO) sur l'IA en dentisterie
- Lauréat du Distinguished Scientist Award de l'IADR
Zuolin Jin
Shenzhen Stomatology Hospital (Pingshan) of Southern Medical University Auteur de l'article
- Président du Comité d'orthodontie de l'Association stomatologique chinoise (COS)
- Membre du conseil de l'Association stomatologique chinoise
- Membre du comité exécutif de l'Asian Pacific Orthodontic Society (APOS)
- Rédacteur en chef adjoint du Chinese Journal of Orthodontics
- Membre de la World Federation of Orthodontists
Ming Zhong
École de stomatologie, Université médicale de Chine
- Expert en chef de l'École de stomatologie de l'Université médicale de Chine
- Bénéficiaire de l'allocation spéciale du Conseil des affaires d'État
- Fellow de l'International College of Dentists
- Président du Comité de pathologie buccale de l'Association stomatologique chinoise
- Rédacteur en chef du manuel national de formation des internes Pathologie buccale (1re et 2e éditions)
Spécialistes partenaires
 Bing Liu
 Daheng Li
 Dongfei Wang
 Fangjie Zhou
 Fen Liu
 Fujia Kang
 Hao Chunxiu
 Jiamin ZhaoJiaming Zhang
 Jinwen Liu
 Jinyan Chen
 Junting Wang
 Kuan Yang
 Lei Shi
 Lin Zhao
 MAO Yilin
 Menghong Li
 Mengmeng Song
 Min Huang
 Minghui Wei
 Mingxin Zhang
 Patricia Ho
 Peijuan Wang
 Peng Chen
 Rui Lu
 Shiduo Sun
 Shirong He
 Shixin Zhang
 Shuwei Huang
 Siqi Qiu
 Tai Pak Chuen Patrick
 Wu Songying
 XU Leyao
 Xiangjie Jin
 Xue Qiao
 Yang Jiang
 Yaqiu Zhang
 Yefeng Wu
 Yidan Guo
 Yifan Zheng
 Ying Wang
 Yujia Wu
 Zhenlai Zhu
 Zhiqiang Deng
 Zhuoying Li
Institutions partenaires
 Université chinoise de Hong Kong (Shenzhen)Chine
 Faculté de médecine dentaire, Université de Hong KongHong Kong (Chine)
 Peking UniversityChine
 National Biomedical Imaging Center, Peking UniversityChine
 Peking-Tsinghua Center for Life SciencesChine
 The Prince Philip Dental HospitalHong Kong (Chine)
 Mayo ClinicÉtats-Unis
 LMU University Hospital MunichAllemagne
 SEGi University & CollegesMalaisie
 National Hospital AbujaNigeria
 College of Medicine, University of LagosNigeria
 Bayero UniversityNigeria
 Usmanu Danfodiyo University, SokotoNigeria
 University of MaiduguriNigeria
 Madda Walabu UniversityÉthiopie
Pays et régions partenaires
Citation
@article{zhao2026globaldentbench,
  title={GlobalDentBench: A Multinational Benchmark for Evaluating LLM Clinical Reasoning in Dentistry with Expert Calibration},
  author={Junjie Zhao and Jingyi Liang and Zhenyang Cai and Jiaming Zhang and Zhenwei Wen and Shuzhi Deng and Wenjing Yi and Chunfeng Luo and Hexian Zhang and Junying Chen and Tianrui Liu and Zhuhui Bai and Zixu Zhang and Pradeep Singh and Xiang Liu and Jianquan Li and Nhan L Tran and Falk Schwendicke and Zuolin Jin and Lijian Jin and Liangyi Chen and Wei-fa Yang and Benyou Wang and Junwen Wang and Shan Jiang},
  journal={npj Digital Medicine},
  year={2026},
  note={Accepted},
  url={https://arxiv.org/abs/2605.24636}
}