
दंत मूल्यांकन
दुनिया भर के दंत विशेषज्ञों के साथ मिलकर हम परखते हैं कि बड़े मॉडल वास्तविक दंत चिकित्सा में कितनी अच्छी तरह तर्क करते हैं और उनमें सुरक्षा के क्या जोखिम हैं।
88 देशों व क्षेत्रों और 14 दंत विशेषज्ञताओं से 8,978 विशेषज्ञ-सत्यापित प्रश्न, जो दंत चिकित्सा में बड़े मॉडलों के नैदानिक तर्क और सुरक्षा जोखिमों को परखते हैं।
Global Partners
हमारा साझेदार नेटवर्क 10 देशों और क्षेत्रों में फैला है
16 विश्वविद्यालय, अस्पताल और शोध संस्थान, हांगकांग, चीनी मुख्यभूमि और विदेश के दंत विशेषज्ञों के साथ, FreedomAI के दंत AI के विकास, मूल्यांकन और नैदानिक सत्यापन में भाग लेते हैं।
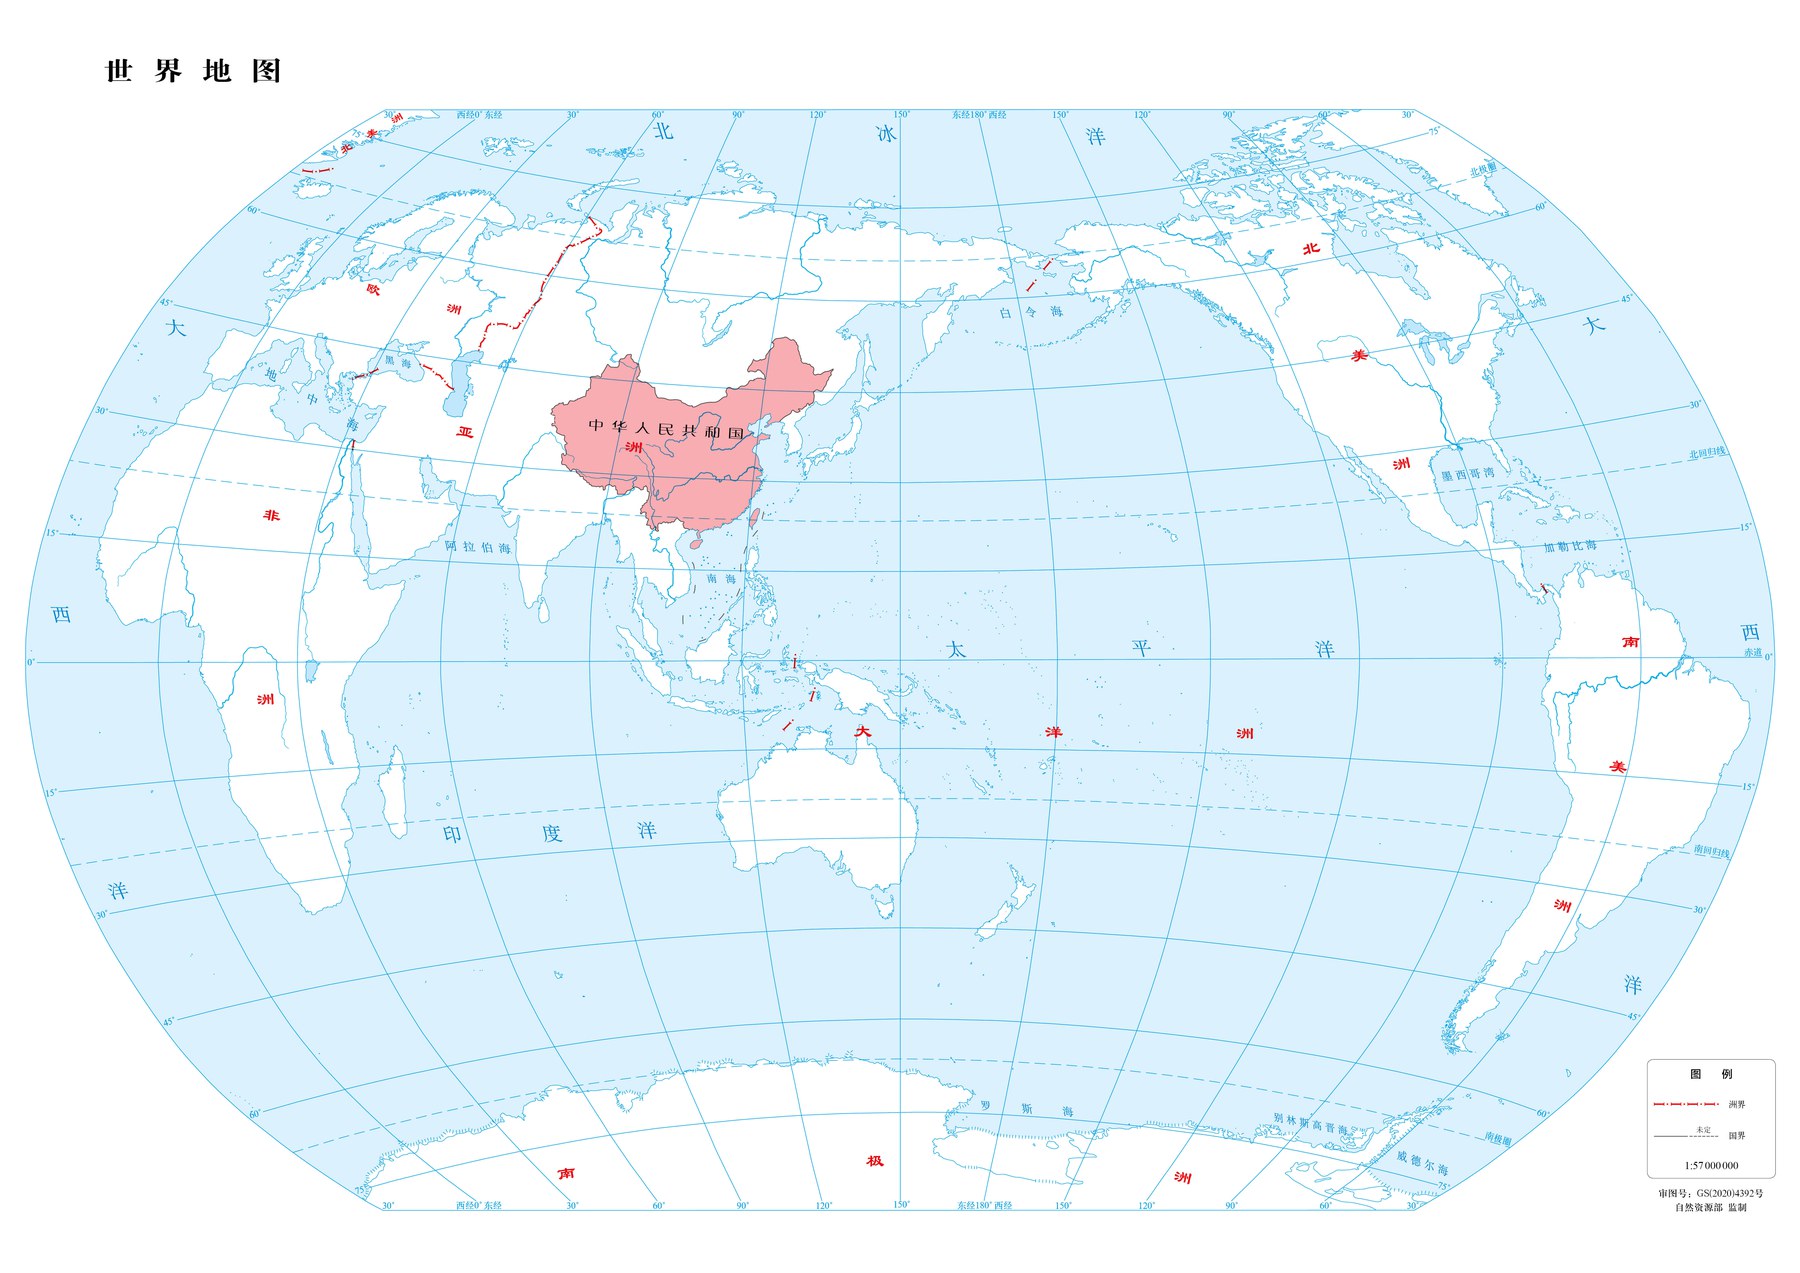
आधार मानचित्र: चीन के प्राकृतिक संसाधन मंत्रालय की मानक मानचित्र सेवा का विश्व मानचित्र (1:5,70,00,000, रूपरेखा संस्करण) मानचित्र अनुमोदन संख्या: GS(2020)4392
- चीनद चाइनीज़ यूनिवर्सिटी ऑफ़ हांगकांग, शेनझेन, Peking University, National Biomedical Imaging Center, Peking University, Peking-Tsinghua Center for Life Sciences, Shenzhen Stomatology Hospital (Pingshan) of Southern Medical University
- हांगकांग (चीन)दंत चिकित्सा संकाय, हांगकांग विश्वविद्यालय, The Prince Philip Dental Hospital
- संयुक्त राज्यमेयो क्लिनिक
- जर्मनीLMU University Hospital Munich
- स्विट्ज़रलैंडसाझेदार देश
- भारतसाझेदार देश
- मलेशियाSEGi University & Colleges
- ऑस्ट्रेलियासाझेदार देश
- नाइजीरियाNational Hospital Abuja, College of Medicine, University of Lagos, Bayero University, Usmanu Danfodiyo University, Sokoto, University of Maiduguri
- इथियोपियाMadda Walabu University
वैश्विक दंत मूल्यांकन क्यों ज़रूरी है
बड़े भाषा मॉडल अब चिकित्सा लाइसेंस परीक्षाओं में मानव विशेषज्ञों के क़रीब पहुँच रहे हैं, लेकिन वास्तविक नैदानिक काम में अधूरी और अस्पष्ट जानकारी के साथ कई चरणों में तर्क करना पड़ता है। दंत चिकित्सा ख़ास तौर पर कठिन है: इसमें स्थानिक विश्लेषण, प्रक्रियात्मक कौशल और दीर्घकालिक उपचार योजना को हर रोगी के अनुसार जोड़ना पड़ता है। मौजूदा दंत LLM मूल्यांकन ज़्यादातर किसी एक देश की लाइसेंस परीक्षाओं या कुछ उप-विशेषज्ञताओं तक सीमित हैं, बहुविकल्पीय प्रश्नों पर निर्भर हैं और केस-आधारित तर्क से अधिक स्मरण को परखते हैं।
इसी कमी को दूर करने के लिए GlobalDentBench बनाया गया। शोध-पत्र के अनुसार यह पहला बहुराष्ट्रीय दंत मूल्यांकन है: छह महाद्वीपों के 88 देशों और क्षेत्रों से 8,978 विशेषज्ञ-सत्यापित प्रश्न, जो 14 दंत विशेषज्ञताओं, 3 प्रश्न-प्रकारों और 3 क्रमिक तर्क-स्तरों को कवर करते हैं। प्रश्न आधिकारिक परीक्षाओं, प्रामाणिक पाठ्यपुस्तकों और सहकर्मी-समीक्षित केस रिपोर्टों से लिए गए हैं; इसे स्वचालित एजेंट-प्रक्रिया से बनाया गया और 6 वरिष्ठ दंत चिकित्सकों ने शुरू से अंत तक अंशांकित किया।
टीम ने 12 अग्रणी बड़े मॉडलों (6 क्लोज़्ड-सोर्स, 6 ओपन-सोर्स) का मूल्यांकन किया। प्रश्न जितने वास्तविक मामलों के क़रीब और रोगी की व्यक्तिगत स्थिति पर निर्भर होते हैं, स्कोर उतने कम होते हैं; वास्तविक केस प्रश्नों में लगभग एक-तिहाई उत्तरों में ऐसी सामग्री थी जो रोगी को नुकसान पहुँचा सकती थी। शोध-पत्र का निष्कर्ष है कि आज के बड़े मॉडल विशेषज्ञ निगरानी में ज्ञान खोजने और व्यवस्थित करने में मदद कर सकते हैं, लेकिन अभी अकेले दंत नैदानिक निर्णय नहीं ले सकते।
यह अध्ययन 25 लेखकों ने मिलकर किया, जो हांगकांग विश्वविद्यालय के दंत चिकित्सा संकाय, द चाइनीज़ यूनिवर्सिटी ऑफ़ हांगकांग, शेनझेन, सदर्न मेडिकल यूनिवर्सिटी के शेनझेन स्टोमैटोलॉजी हॉस्पिटल (पिंगशान), पेकिंग विश्वविद्यालय, अमेरिका के मेयो क्लिनिक और जर्मनी के LMU यूनिवर्सिटी हॉस्पिटल म्यूनिख जैसे संस्थानों से हैं। FreedomAI टीम के सदस्य भी शामिल रहे: COO Junjie Zhao और CTO Zhenyang Cai सह-प्रथम लेखक हैं, मुख्य AI वैज्ञानिक Benyou Wang और मुख्य चिकित्सा वैज्ञानिक Junwen Wang संवाददाता लेखक हैं, और CEO Jianquan Li ने मॉडल इनफ़रेंस और परिणाम संग्रह में योगदान दिया। निर्माण और मूल्यांकन कोड GitHub पर ओपन-सोर्स है, और खुला उपसमूह GlobalDentBench-OA Hugging Face पर उपलब्ध है।
छह महाद्वीपों में
प्रश्नों के स्रोत
शोध-पत्र प्रश्नों के स्रोत को संयुक्त राष्ट्र के M49 मानक से गिनता है। नीचे खुले डेटासेट GlobalDentBench-OA में चिह्नित 73 देश और क्षेत्र दिए गए हैं;हरे रंगवाले देशों ने बहुविकल्पीय प्रश्नों में प्रयुक्त आधिकारिक दंत लाइसेंसिंग परीक्षाएँ उपलब्ध कराईं।
एशिया28
- चीनी मुख्यभूमि
- हांगकांग (चीन)
- ताइवान (चीन)
- भारत
- जापान
- दक्षिण कोरिया
- सऊदी अरब
- ईरान
- संयुक्त अरब अमीरात
- थाईलैंड
- इंडोनेशिया
- मलेशिया
- तुर्किये
- नेपाल
- वियतनाम
- कंबोडिया
- इराक
- इज़राइल
- जॉर्डन
- फ़िलिपींस
- क़तर
- सीरिया
- जॉर्जिया
- लेबनान
- पाकिस्तान
- सिंगापुर
- श्रीलंका
- फ़िलिस्तीनी क्षेत्र
यूरोप24
- यूनाइटेड किंगडम
- इटली
- स्पेन
- जर्मनी
- स्विट्ज़रलैंड
- नीदरलैंड
- फ़्रांस
- पुर्तगाल
- क्रोएशिया
- हंगरी
- बुल्गारिया
- यूनान
- रूस
- ऑस्ट्रिया
- बेल्जियम
- आयरलैंड
- स्वीडन
- अल्बानिया
- चेकिया
- डेनमार्क
- नॉर्वे
- रोमानिया
- स्लोवेनिया
- यूक्रेन
अफ़्रीका7
- ट्यूनीशिया
- मिस्र
- दक्षिण अफ़्रीका
- लीबिया
- मोरक्को
- नाइजीरिया
- युगांडा
उत्तरी अमेरिका6
- कनाडा
- संयुक्त राज्य
- मैक्सिको
- कोस्टारिका
- ग्वाटेमाला
- पोर्टो रिको
दक्षिण अमेरिका6
- ब्राज़ील
- कोलंबिया
- इक्वाडोर
- चिली
- पेरू
- वेनेज़ुएला
ओशिनिया2
- ऑस्ट्रेलिया
- न्यूज़ीलैंड
मूल्यांकन डिज़ाइन: 3 तर्क स्तर × 3 प्रश्न प्रकार × 14 विशेषज्ञताएँ
ज्ञान स्मरण
स्थापित दंत ज्ञान को याद करना, केस पर ठोस तर्क की ज़रूरत नहीं।
12 मॉडलों का औसत: 74.01%
सामान्य तर्क
मुख्य नैदानिक लक्षणों के आधार पर, सामान्य निदान या उपचार के तरीक़े से तर्क करना।
12 मॉडलों का औसत: 55.64%
रोगी-विशेष तर्क
अंतिम निर्णय के लिए रोगी की व्यक्तिगत जानकारी, सीमाएँ या ग़ैर-मानक नैदानिक कारकों पर विचार ज़रूरी है।
12 मॉडलों का औसत: 35.71%
बहुविकल्पीय MCQ
3,679 प्रश्न
मूल्यांकन: उत्तर मिलान
ऑस्ट्रेलिया, न्यूज़ीलैंड, कनाडा, भारत, ब्रिटेन और अमेरिका की आधिकारिक दंत लाइसेंस और योग्यता परीक्षाओं से, मानकीकृत ज्ञान की जाँच के लिए।
12 मॉडलों का औसत: 81.34%
लघु उत्तर SAQ
3,709 प्रश्न
मूल्यांकन: मूल्यांकक मॉडल द्वारा जाँच (दंत चिकित्सकों द्वारा अंशांकित)
प्रामाणिक दंत पाठ्यपुस्तकों (जैसे Diagnosis and Treatment Planning in Dentistry) से; मॉडल प्राकृतिक भाषा में उत्तर देते हैं।
12 मॉडलों का औसत: 64.53%
केस-आधारित CBQ
1,590 प्रश्न
मूल्यांकन: 5 मुख्य बिंदुओं का अलग-अलग मूल्यांकन, साथ में सुरक्षा जोखिम आकलन
2020–2025 की उच्च-प्रभाव वाली दंत पत्रिकाओं में प्रकाशित सहकर्मी-समीक्षित केस रिपोर्टों से बने, वास्तविक स्थितियों में नैदानिक तर्क की जाँच के लिए।
12 मॉडलों का औसत: 22.34%
शामिल 14 दंत विशेषज्ञताएँ
एजेंटों द्वारा निर्मित, दंत चिकित्सकों द्वारा अंशांकित
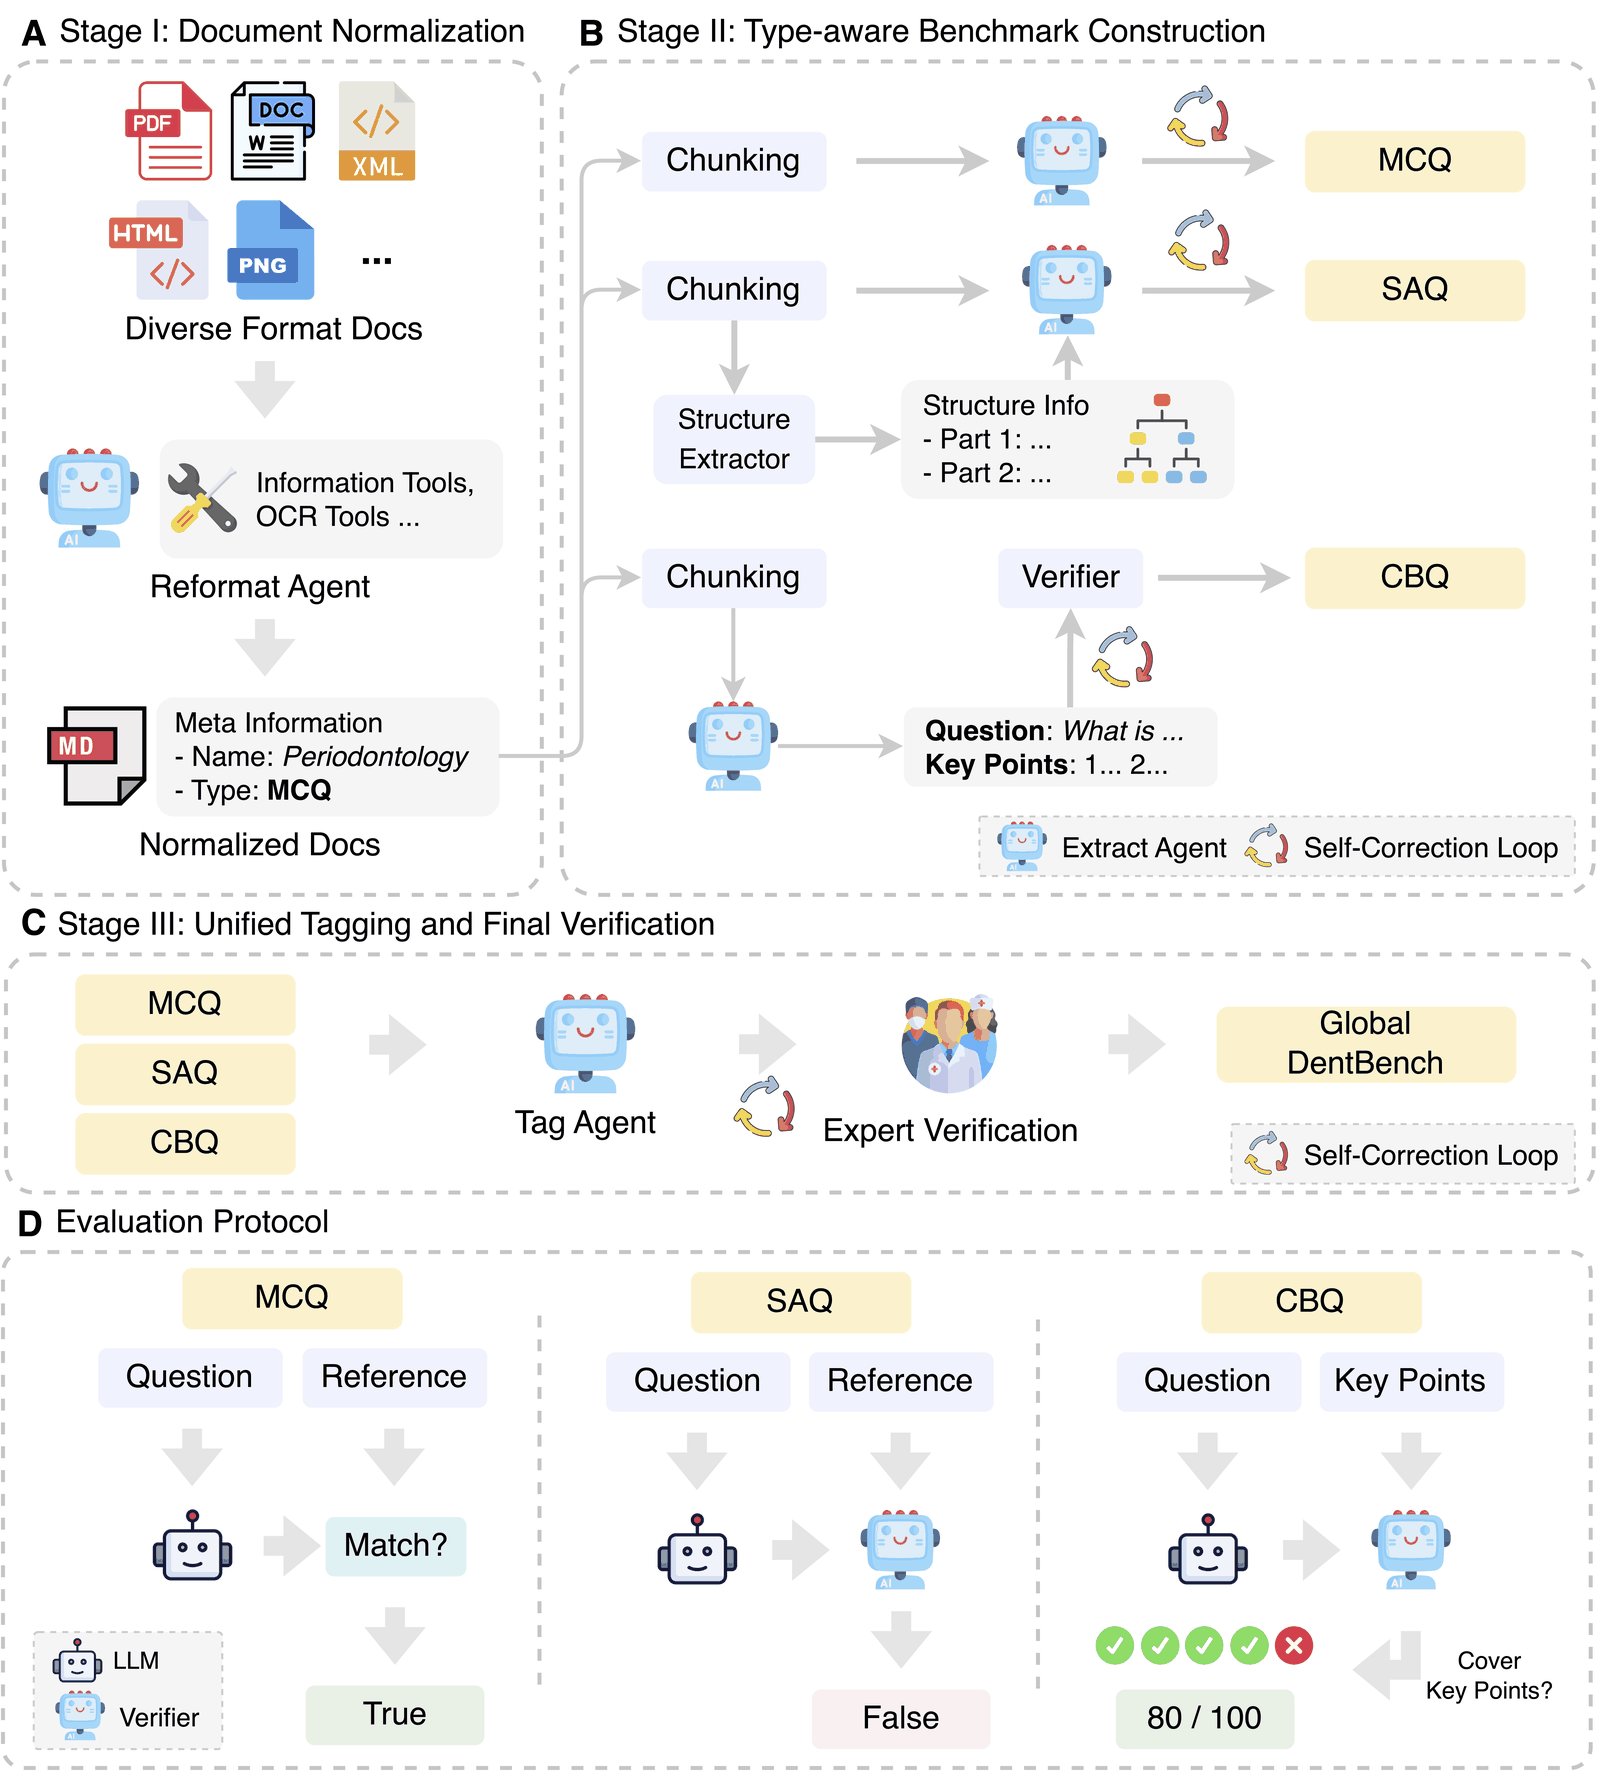
- 1प्रामाणिक स्रोतों का संग्रह
वरिष्ठ दंत चिकित्सकों के मार्गदर्शन में आधिकारिक लाइसेंस और योग्यता परीक्षाओं, प्रामाणिक दंत पाठ्यपुस्तकों और 2020–2025 की सहकर्मी-समीक्षित केस रिपोर्टों से सामग्री जुटाई जाती है, और स्रोत देशों व क्षेत्रों को संयुक्त राष्ट्र के M49 मानक से चिह्नित किया जाता है।
- 2दस्तावेज़ों का मानकीकरण
Reformat Agent, OCR (DeepSeek-OCR2), BeautifulSoup, Pandoc आदि टूल से PDF, इमेज, Office दस्तावेज़, XML और वेब पेजों को Markdown में बदलता है और शीर्षक, स्रोत, लेखक जैसे मेटाडेटा जोड़ता है।
- 3प्रकार के अनुसार प्रश्न निर्माण
Extract Agent पहले टुकड़ों में बाँटता है, फिर निकालता है: बहुविकल्पीय प्रश्नों को प्रश्न, विकल्प और उत्तर में व्यवस्थित करता है; लघु उत्तर के प्रश्न-उत्तर जोड़े निकालता है; केस प्रश्नों के लिए प्रश्न और 5 मूल्यांकन बिंदु बनाता है। हर प्रश्न अधिकतम 3 दौर के आत्म-सुधार से गुज़रता है और फिर भी अनुपयुक्त हो तो हटा दिया जाता है।
- 4एकीकृत टैगिंग और अंतिम समीक्षा
Tag Agent हर प्रश्न की विशेषज्ञता और तर्क-स्तर चिह्नित करता है: दो दौर के अनुमान मिलें तो उसे अपनाया जाता है, न मिलें तो तीसरा दौर बहुमत से तय करता है। आत्म-सुधार और वरिष्ठ दंत चिकित्सकों की समीक्षा के बाद ही प्रश्न बेंचमार्क में शामिल होते हैं।
- 5प्रश्न-प्रकार के अनुसार मूल्यांकन
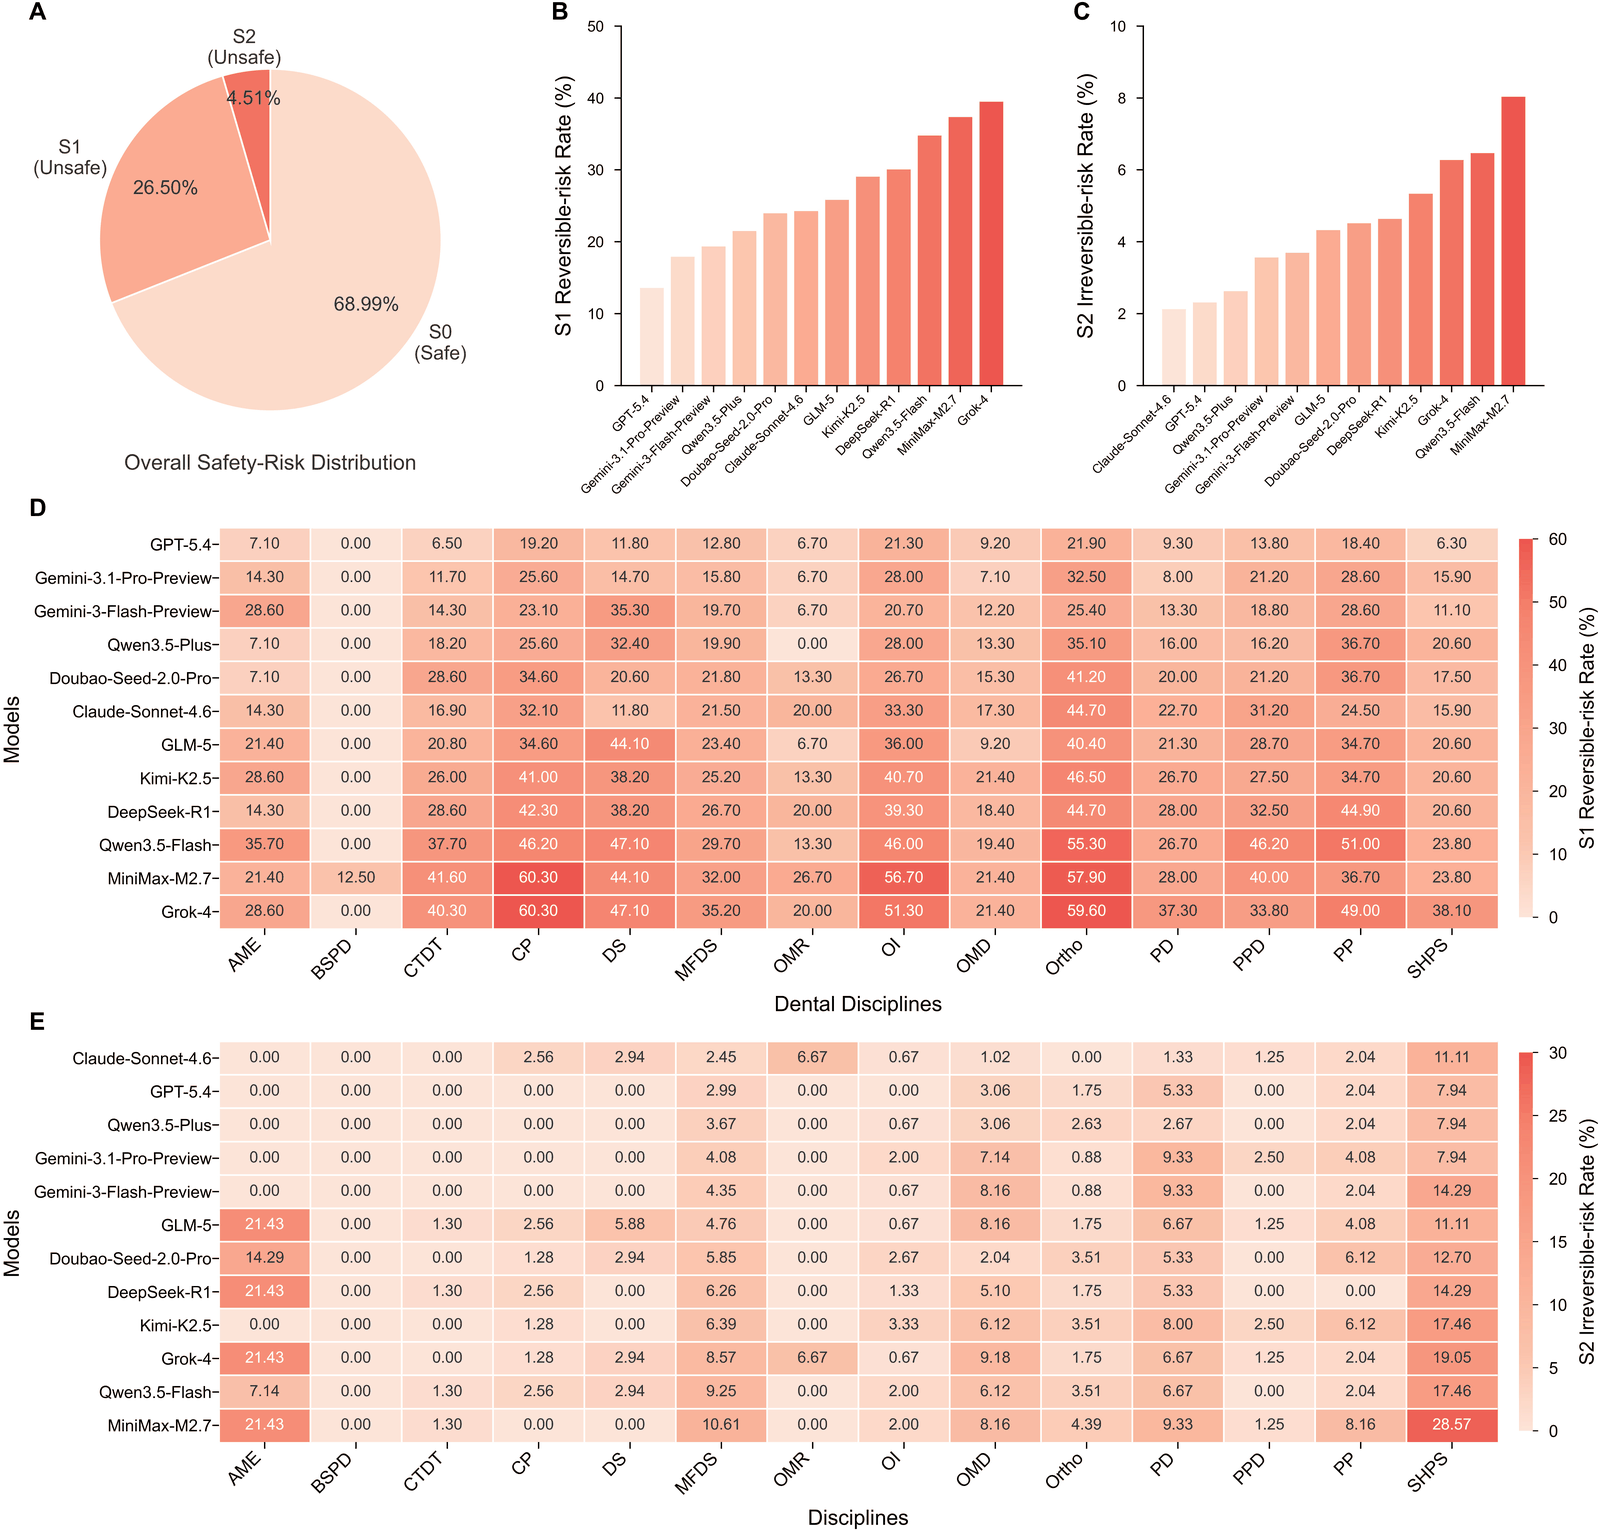
बहुविकल्पीय उत्तरों का सीधा मिलान होता है; लघु उत्तरों को मूल्यांकक मॉडल जाँचता है; केस प्रश्नों को 5 मुख्य बिंदुओं (हर बिंदु 20 अंक) पर परखा जाता है, और हर उत्तर को सुरक्षा के अनुसार तीन स्तरों में रखा जाता है: S0 सुरक्षित, S1 संभावित ठीक होने योग्य नुकसान, S2 संभावित अपरिवर्तनीय नुकसान।
- 6शुरू से अंत तक दंत चिकित्सकों का अंशांकन
6 लाइसेंसधारी वरिष्ठ दंत चिकित्सकों (औसत नैदानिक अनुभव 6.8 वर्ष) ने 5 फ़रवरी से 25 मार्च 2026 तक स्रोतों की जाँच, प्रक्रिया में सुधार और स्कोरिंग अंशांकन किया—कुल 297 व्यक्ति-घंटे।
मुख्य निष्कर्ष
प्रश्न जितने वास्तविक केस के क़रीब, स्कोर उतने कम
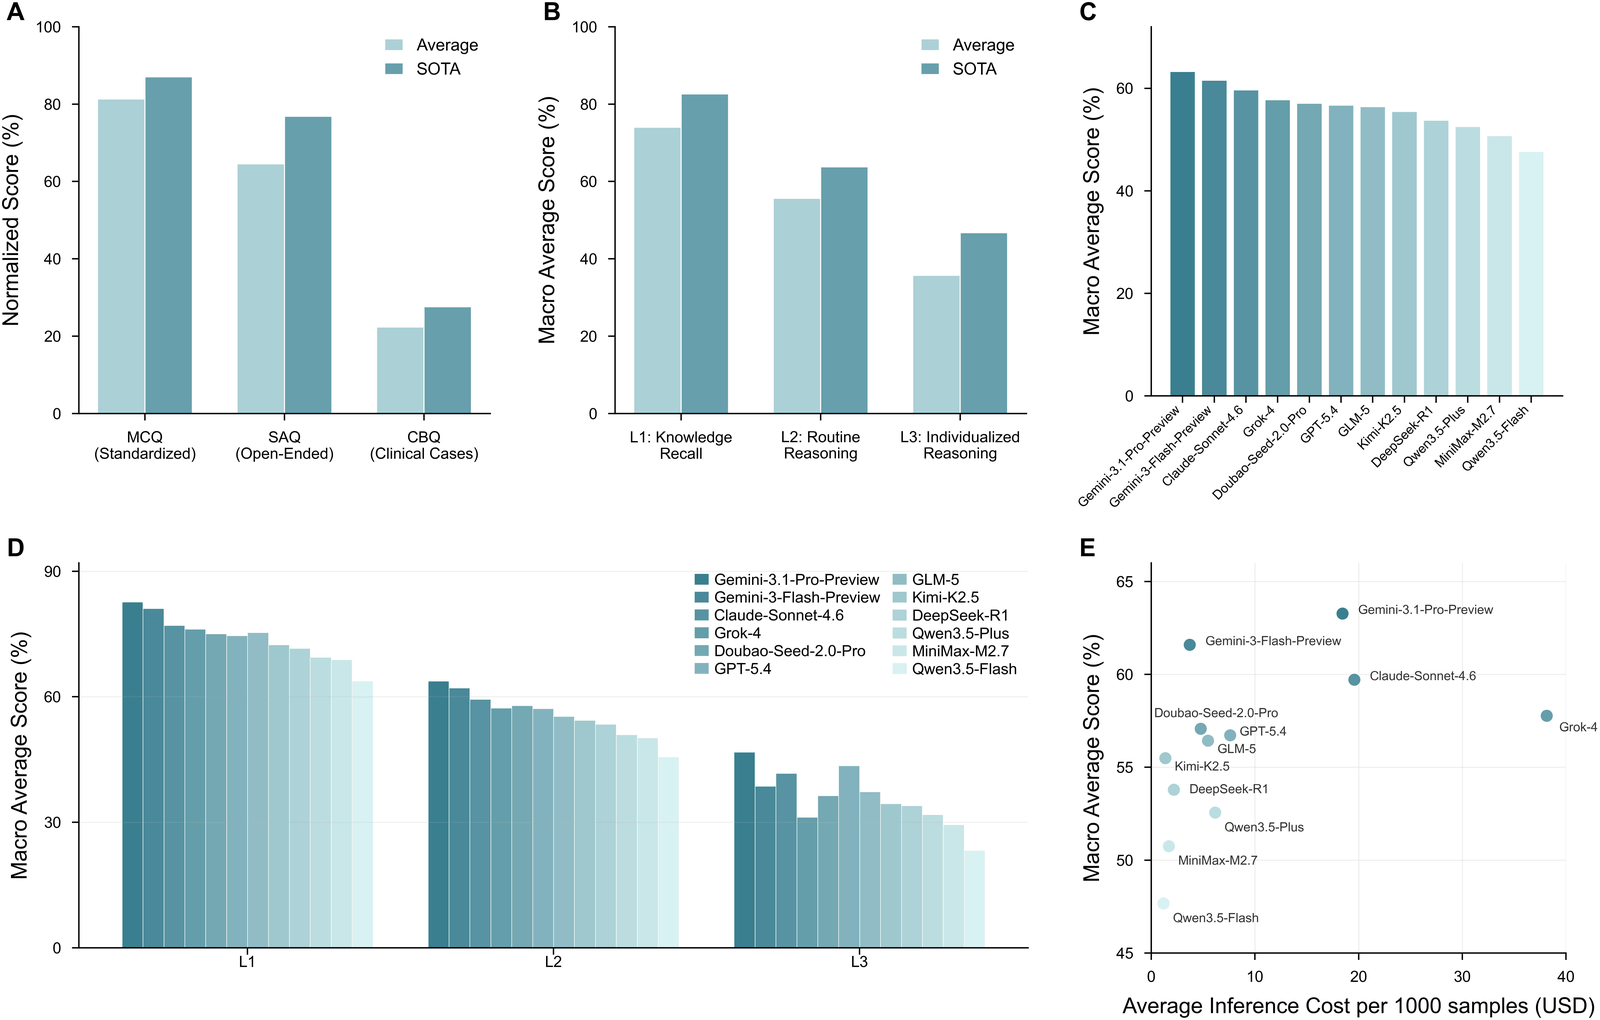
12 मॉडलों के औसत स्कोर: बहुविकल्पीय में 81.34%, लघु उत्तर में 64.53% और केस प्रश्नों में केवल 22.34%।
रोगी-विशेष तर्क सबकी साझा कमज़ोरी
औसत स्कोर L1 के 74.01% से L2 पर 55.64% और L3 पर 35.71% तक गिरता है; L3 पर सभी मॉडल 50% से नीचे हैं।
महँगा मॉडल ज़रूरी नहीं कि बेहतर हो
Gemini-3.1-Pro-Preview का कुल स्कोर सबसे अधिक (63.27%) है और ओपन-सोर्स मॉडलों में GLM-5 सबसे आगे (56.43%) है। इनफ़रेंस लागत का अंतर स्कोर के अंतर से कहीं बड़ा है—अधिक लागत से बेहतर प्रदर्शन तय नहीं होता।
विशेषज्ञताओं के बीच साफ़ अंतर
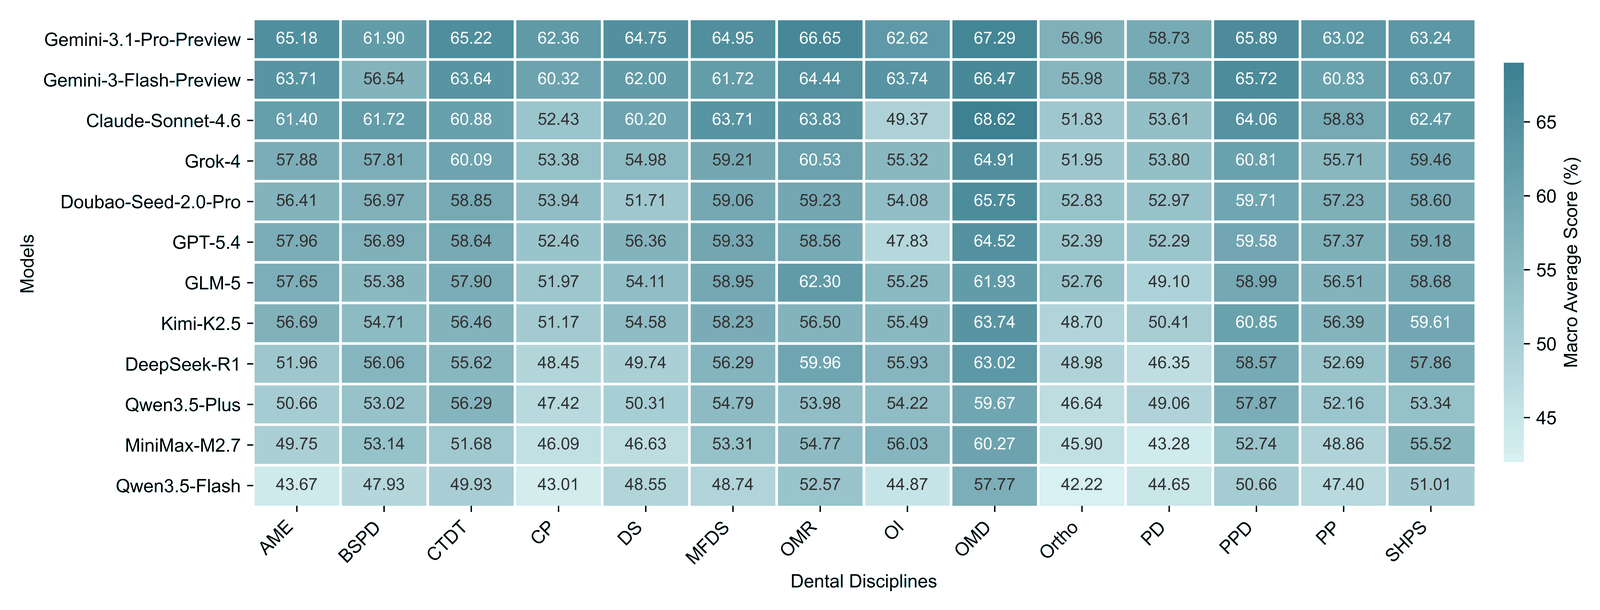
मुँह की श्लेष्मा के रोगों का औसत स्कोर सबसे अधिक (63.66%) है, जबकि ऑर्थोडॉन्टिक्स (50.59%), बाल दंत चिकित्सा (51.08%) और पारंपरिक प्रोस्थोडॉन्टिक्स (51.92%) सबसे कम हैं—सबसे अधिक और सबसे कम में 13.07 अंकों का अंतर।
लगभग हर तीसरे उत्तर में सुरक्षा जोखिम
1,590 केस प्रश्नों के 19,080 उत्तरों में से 31.01% असुरक्षित पाए गए, जिनमें 4.51% अपरिवर्तनीय नुकसान पहुँचा सकते थे; ऑर्थोडॉन्टिक्स में असुरक्षित उत्तरों का अनुपात सबसे अधिक 44.30% रहा।
गंभीर जोखिम संवेदनशील विशेषज्ञताओं में केंद्रित
अपरिवर्तनीय नुकसान पहुँचा सकने वाले उत्तर सबसे अधिक “संपूर्ण स्वास्थ्य, फ़ार्माकोलॉजी और सुरक्षा” में (मॉडलों का औसत 14.15%) थे, उसके बाद एनेस्थीसिया और चिकित्सा आपात स्थिति (8.93%) तथा बाल दंत चिकित्सा (6.33%)।
स्वचालित स्कोरिंग दंत चिकित्सकों के निर्णय से काफ़ी मेल खाती है
मूल्यांकक मॉडल Gemini-3-Flash-Preview के 98.15% परिणामों को दंत चिकित्सकों ने सही माना (दो दंत चिकित्सकों के बीच सहमति 96.67%)। बहुविकल्पीय और लघु उत्तर प्रश्नों की विशेषज्ञों ने पूरी समीक्षा की, जिनकी सटीकता 99.98% रही; 523 केस प्रश्नों के नमूने में सटीकता 96.78% रही।
प्रतिनिधि मॉडलों का कुल स्कोर और इनफ़रेंस लागत (मूल्यांकित 12 में से 6)
| मॉडल | प्रकार | कुल स्कोर (मैक्रो औसत) | प्रति 1,000 कॉल लागत (USD) | टिप्पणी |
|---|---|---|---|---|
| Gemini-3.1-Pro-Preview | क्लोज़्ड-सोर्स | 63.27% | 18.45 | सबसे अधिक कुल स्कोर |
| Gemini-3-Flash-Preview | क्लोज़्ड-सोर्स | 61.59% | 3.72 | क्लोज़्ड-सोर्स मॉडलों में सबसे किफ़ायती; इस अध्ययन का मूल्यांकक मॉडल |
| Claude-Sonnet-4.6 | क्लोज़्ड-सोर्स | 59.71% | 19.59 | शीर्ष के क़रीब, लेकिन अधिक लागत |
| Grok-4 | क्लोज़्ड-सोर्स | 57.77% | 38.14 | सबसे अधिक इनफ़रेंस लागत |
| GLM-5 | ओपन-सोर्स | 56.43% | 5.48 | ओपन-सोर्स मॉडलों में सबसे अधिक कुल स्कोर |
| Kimi-K2.5 | ओपन-सोर्स | 55.49% | 1.37 | ओपन-सोर्स मॉडलों में उत्कृष्ट किफ़ायत |
स्रोत: शोध-पत्र के खंड 2.3 का पाठ (चित्र 2C और 2E)। शोध-पत्र में डेटा तालिका नहीं है; बाकी 6 मॉडलों के स्कोर केवल चित्रों में दिए गए हैं।
25 लेखक
हांगकांग, चीनी मुख्यभूमि, अमेरिका और जर्मनी के दंत चिकित्सक तथा चिकित्सा व AI शोधकर्ता, जिनमें FreedomAI टीम के सदस्य भी शामिल हैं।
संबद्ध संस्थान
FreedomAI विशेषज्ञ नेटवर्क
प्रतिष्ठित दंत विशेषज्ञों के नेतृत्व में, चीन और विदेश के विशेषज्ञ चिकित्सक और संस्थान FreedomAI के दंत AI के सहयोगी एनोटेशन, पेशेवर मूल्यांकन और नैदानिक सत्यापन में भाग लेते हैं। यह कंपनी का साझेदार नेटवर्क है, शोध-पत्र के लेखकों की सूची नहीं; प्रोफ़ेसर Lijian Jin, Falk Schwendicke और Zuolin Jin GlobalDentBench के लेखक हैं।
Lijian Jin
दंत चिकित्सा संकाय, हांगकांग विश्वविद्यालय शोध-पत्र लेखक
- FDI वर्ल्ड डेंटल फ़ेडरेशन परिषद के सदस्य
- इंटरनेशनल एसोसिएशन फ़ॉर डेंटल रिसर्च (IADR) के बोर्ड सदस्य
- IADR एशिया-प्रशांत क्षेत्र के अध्यक्ष
- एशियन पैसिफ़िक सोसाइटी ऑफ़ पेरियोडॉन्टोलॉजी के अध्यक्ष
- चाइनीज़ स्टोमैटोलॉजिकल एसोसिएशन के मानद परिषद सदस्य
- ग्वांगडोंग–हांगकांग–मकाओ ग्रेटर बे एरिया मौखिक स्वास्थ्य गठबंधन के उपाध्यक्ष
Falk Schwendicke
LMU University Hospital Munich शोध-पत्र लेखक
- विश्व स्वास्थ्य संगठन (WHO) की स्वास्थ्य के लिए AI पहल में दंत विषय-समूह के प्रमुख
- अंतरराष्ट्रीय मानकीकरण संगठन (ISO) के दंत AI कार्य-समूह के संयोजक
- IADR डिस्टिंग्विश्ड साइंटिस्ट अवॉर्ड से सम्मानित
Zuolin Jin
Shenzhen Stomatology Hospital (Pingshan) of Southern Medical University शोध-पत्र लेखक
- चाइनीज़ स्टोमैटोलॉजिकल एसोसिएशन की ऑर्थोडॉन्टिक्स समिति (COS) के अध्यक्ष
- चाइनीज़ स्टोमैटोलॉजिकल एसोसिएशन के परिषद सदस्य
- एशियन पैसिफ़िक ऑर्थोडॉन्टिक सोसाइटी (APOS) की कार्यकारी समिति के सदस्य
- चाइनीज़ जर्नल ऑफ़ ऑर्थोडॉन्टिक्स के उप-प्रधान संपादक
- वर्ल्ड फ़ेडरेशन ऑफ़ ऑर्थोडॉन्टिस्ट्स के सदस्य
Ming Zhong
स्टोमैटोलॉजी स्कूल, चाइना मेडिकल यूनिवर्सिटी
- चाइना मेडिकल यूनिवर्सिटी के स्टोमैटोलॉजी स्कूल के मुख्य विशेषज्ञ
- राज्य परिषद के विशेष सरकारी भत्ते के प्राप्तकर्ता
- इंटरनेशनल कॉलेज ऑफ़ डेंटिस्ट्स के फ़ेलो
- चाइनीज़ स्टोमैटोलॉजिकल एसोसिएशन की ओरल पैथोलॉजी समिति के अध्यक्ष
- राष्ट्रीय दंत रेज़िडेंसी प्रशिक्षण पाठ्यपुस्तक “ओरल पैथोलॉजी” (पहला और दूसरा संस्करण) के प्रधान संपादक
साझेदार विशेषज्ञ चिकित्सक
 Bing Liu
 Daheng Li
 Dongfei Wang
 Fangjie Zhou
 Fen Liu
 Fujia Kang
 Hao Chunxiu
 Jiamin ZhaoJiaming Zhang
 Jinwen Liu
 Jinyan Chen
 Junting Wang
 Kuan Yang
 Lei Shi
 Lin Zhao
 MAO Yilin
 Menghong Li
 Mengmeng Song
 Min Huang
 Minghui Wei
 Mingxin Zhang
 Patricia Ho
 Peijuan Wang
 Peng Chen
 Rui Lu
 Shiduo Sun
 Shirong He
 Shixin Zhang
 Shuwei Huang
 Siqi Qiu
 Tai Pak Chuen Patrick
 Wu Songying
 XU Leyao
 Xiangjie Jin
 Xue Qiao
 Yang Jiang
 Yaqiu Zhang
 Yefeng Wu
 Yidan Guo
 Yifan Zheng
 Ying Wang
 Yujia Wu
 Zhenlai Zhu
 Zhiqiang Deng
 Zhuoying Li
साझेदार संस्थान
 द चाइनीज़ यूनिवर्सिटी ऑफ़ हांगकांग, शेनझेनचीन
 दंत चिकित्सा संकाय, हांगकांग विश्वविद्यालयहांगकांग (चीन)
 Peking Universityचीन
 National Biomedical Imaging Center, Peking Universityचीन
 Peking-Tsinghua Center for Life Sciencesचीन
 The Prince Philip Dental Hospitalहांगकांग (चीन)
 Mayo Clinicसंयुक्त राज्य
 LMU University Hospital Munichजर्मनी
 SEGi University & Collegesमलेशिया
 National Hospital Abujaनाइजीरिया
 College of Medicine, University of Lagosनाइजीरिया
 Bayero Universityनाइजीरिया
 Usmanu Danfodiyo University, Sokotoनाइजीरिया
 University of Maiduguriनाइजीरिया
 Madda Walabu Universityइथियोपिया
साझेदार देश और क्षेत्र
उद्धरण
@article{zhao2026globaldentbench,
  title={GlobalDentBench: A Multinational Benchmark for Evaluating LLM Clinical Reasoning in Dentistry with Expert Calibration},
  author={Junjie Zhao and Jingyi Liang and Zhenyang Cai and Jiaming Zhang and Zhenwei Wen and Shuzhi Deng and Wenjing Yi and Chunfeng Luo and Hexian Zhang and Junying Chen and Tianrui Liu and Zhuhui Bai and Zixu Zhang and Pradeep Singh and Xiang Liu and Jianquan Li and Nhan L Tran and Falk Schwendicke and Zuolin Jin and Lijian Jin and Liangyi Chen and Wei-fa Yang and Benyou Wang and Junwen Wang and Shan Jiang},
  journal={npj Digital Medicine},
  year={2026},
  note={Accepted},
  url={https://arxiv.org/abs/2605.24636}
}