FreedomAI मुख्य तकनीक · Findings of ACL 2026

DentalGPT

दंत बहु-मोडल बड़ा मॉडल

1,20,000 से अधिक दंत इमेज पर बहु-मोडल संरेखण, फिर जटिल तर्क के लिए रीइन्फ़ोर्समेंट लर्निंग: 7B पैरामीटर वाला DentalGPT पाँच दंत बेंचमार्क पर औसतन 67.1% सटीकता देता है, जबकि GPT-5 की 59.2% है।

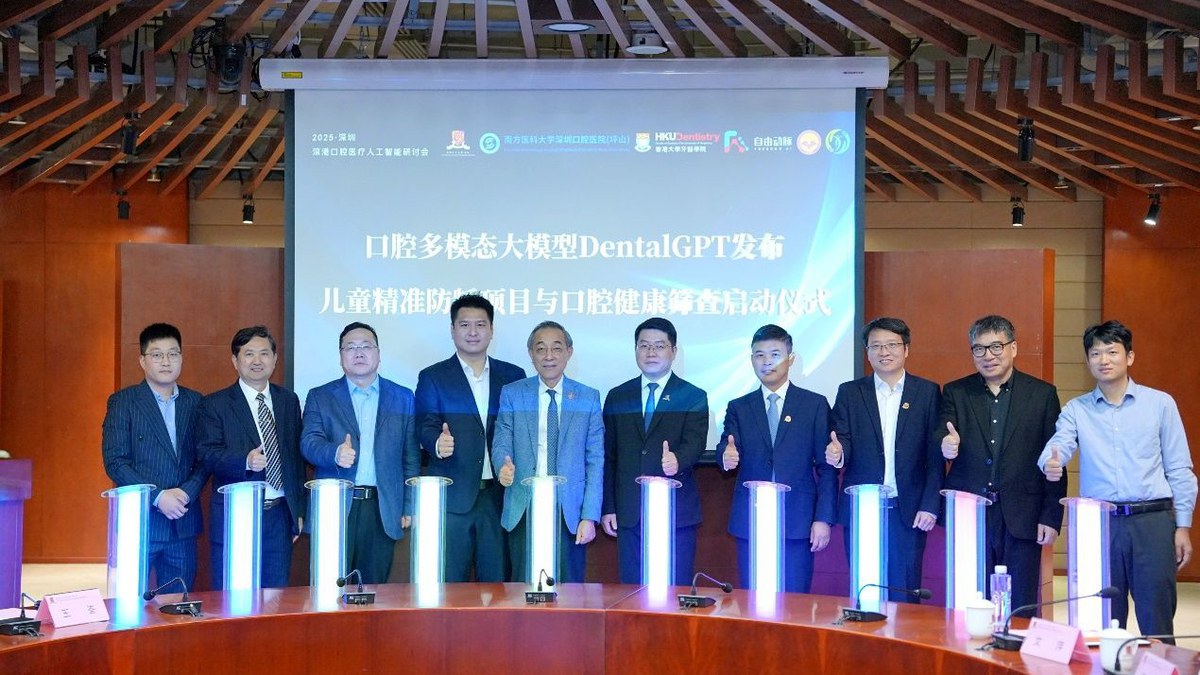
4 दिसंबर 2025 को दंत बहु-मोडल बड़ा मॉडल DentalGPT शेनझेन–हांगकांग दंत चिकित्सा AI संगोष्ठी (शेनझेन) में जारी किया गया
DentalGPT शोध-पत्र पर ACL 2026 का निर्णय: Findings
Findings of ACL 2026 में स्वीकृत
7Bपैरामीटर
1.2 लाख+एनोटेट की गई दंत इमेज
67.1%पाँच दंत बेंचमार्क पर औसत सटीकता
84.0%पैनोरमिक वर्गीकरण सटीकता
4लाइसेंसधारी दंत चिकित्सकों ने मूल्यांकन किया

मॉडल: पहले “देखना” सीखे, फिर “सोचना”

दंत AI के सामने चार बड़ी कठिनाइयाँ हैं, और DentalGPT हर एक का समाधान करता है। आगे पढ़ें: Benyou Wang, “हम दंत चिकित्सा के लिए अलग मॉडल क्यों प्रशिक्षित करते हैं” →

01

दंत डेटा की कमी

बड़े चिकित्सा इमेज–टेक्स्ट डेटासेट PubMedVision में दाँतों से जुड़ी इमेज केवल लगभग 0.3% हैं।

DentalGPT का तरीका1,20,000 से अधिक इंट्राओरल फ़ोटो और पैनोरमिक रेडियोग्राफ़ का विशेष डेटासेट; जिन विशेषज्ञ एनोटेशन की परस्पर सहमति 85% से कम हो, उन्हें हटा दिया जाता है।

02

इमेज के बारीक विवरण

फ़िलिंग, रूट कैनाल उपचार और पेरिएपिकल घाव अक्सर पैनोरमिक रेडियोग्राफ़ का छोटा-सा हिस्सा होते हैं; अग्रणी सामान्य मॉडल पैनोरमिक प्रश्नोत्तर बेंचमार्क पर 60% से नीचे रहते हैं।

DentalGPT का तरीकापहला चरण, बहु-मोडल संरेखण: केवल दिखाई देने वाली विशेषताओं का वर्णन करने वाले अवलोकनात्मक विवरण, ताकि मॉडल दृश्य विवरणों को दंत अवधारणाओं से जोड़ सके।

03

जटिल नैदानिक तर्क

प्रश्न जितने वास्तविक मामलों के करीब, उतने कठिन: रोगी-विशेष तर्क वाले प्रश्नों पर 12 अग्रणी मॉडलों का औसत केवल 35.71% है।

DentalGPT का तरीकादूसरा चरण, रीइन्फ़ोर्समेंट लर्निंग: लगभग 10,000 स्वतः जाँचे जाने वाले प्रश्नों पर GRPO प्रशिक्षण, ताकि बहु-चरणीय तर्क विकसित हो।

04

सुरक्षा की ऊँची अपेक्षाएँ

वास्तविक मामलों पर अग्रणी मॉडलों के उत्तरों में से 31.01% असुरक्षित पाए गए और 4.51% अपरिवर्तनीय नुकसान पहुँचा सकते थे।

DentalGPT का तरीकाबहुराष्ट्रीय, विशेषज्ञ-स्तरीय मूल्यांकन मॉडल को लगातार परखते हैं; DentalAgent सत्यापन-योग्य साक्ष्य देता है, और नैदानिक निर्णय हमेशा दंत चिकित्सक ही लेते हैं।

प्रशिक्षण डेटा: 1,20,000 से अधिक दंत इमेज

PMC-Dental-Caption-47k

PubMed Central के शोध-पत्रों से चुनी गई दंत इमेज और उनके मूल कैप्शन।

Opensource-Dental-Classification-49k

कई ओपन-सोर्स वर्गीकरण डेटासेट मिलाए गए, हर इमेज पर रोग का लेबल।

Opensource-Dental-Detection-31k

घाव-स्थान पहचान डेटासेट से, दाँतों और घावों के बाउंडिंग बॉक्स के साथ।

विशेषज्ञों द्वारा एनोटेट डेटा

इंटरनेट, अस्पतालों के इमेजिंग संग्रह और सार्वजनिक डेटासेट से, पेशेवर दंत चिकित्सकों द्वारा एनोटेट; जिन एनोटेशन की परस्पर सहमति 85% से कम हो, उन्हें हटा दिया जाता है।

दो चरणों में प्रशिक्षण

  1. 1
    पहला चरण: बहु-मोडल संरेखण

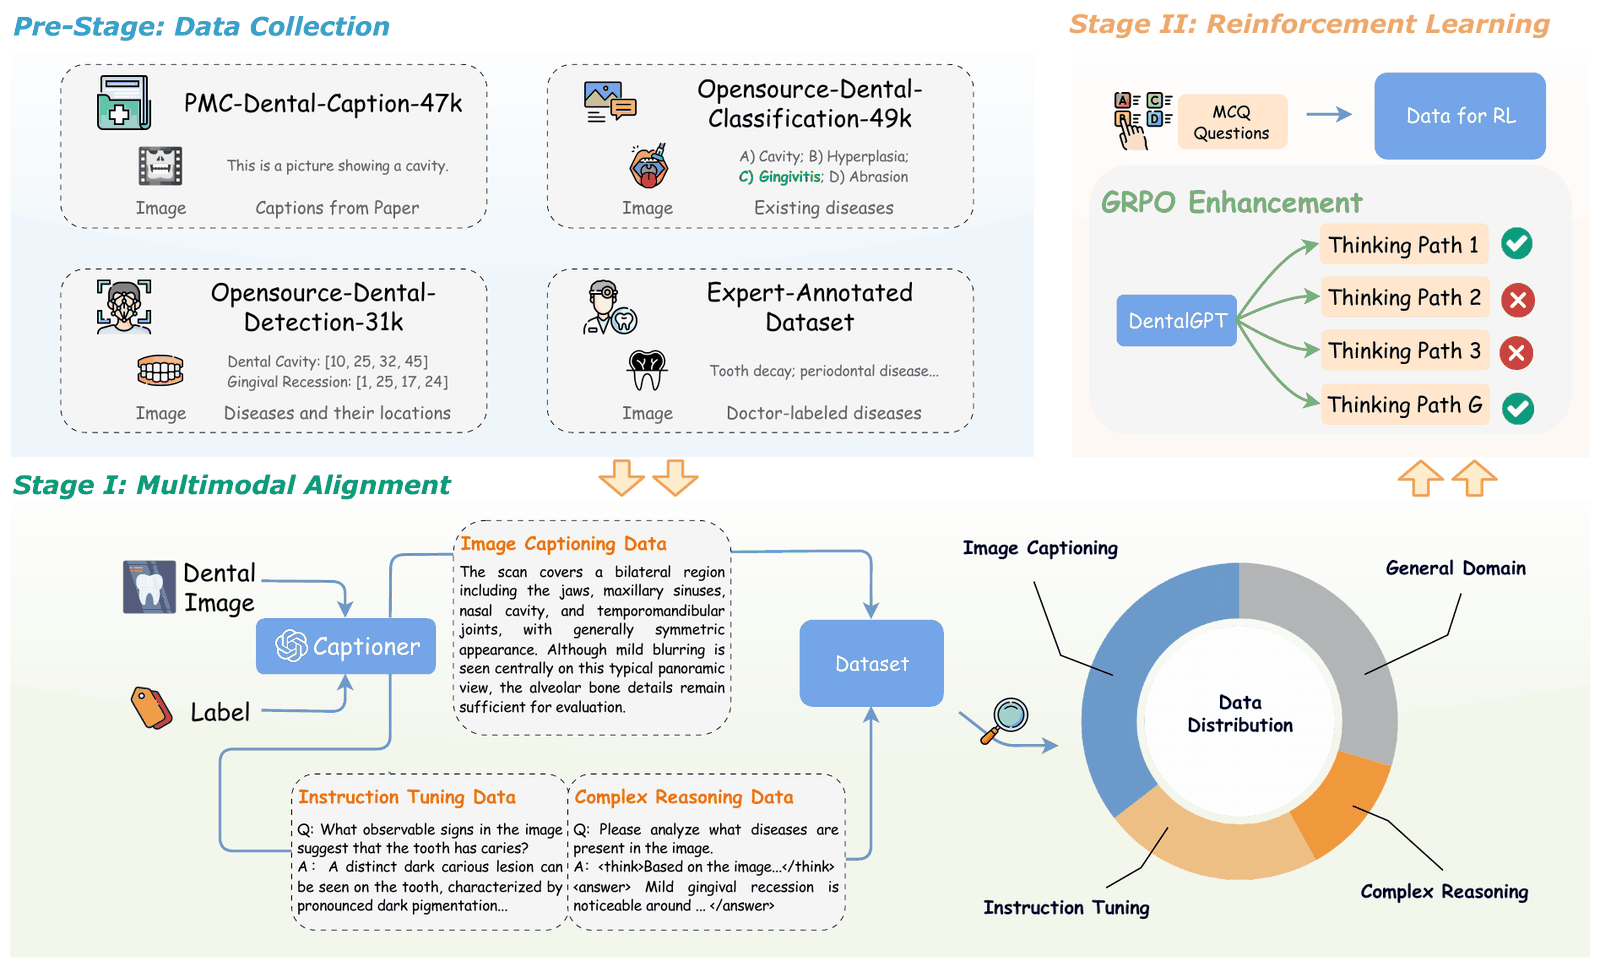
    मूल लेबल को संदर्भ मानकर GPT-5 ऐसे अवलोकनात्मक विवरण लिखता है जो केवल दिखाई देने वाली विशेषताएँ बताते हैं, बिना निदान संबंधी अनुमान के; साथ में निदान स्थितियों का अनुकरण करने वाले प्रश्नोत्तर और HuatuoGPT-o1 विधि से बना जटिल-तर्क डेटा जोड़ा जाता है, और सामान्य क्षमता बनाए रखने के लिए सामान्य डेटा मिलाया जाता है। सारे डेटा की GPT-5-mini से दोबारा जाँच होती है।

  2. 2
    दूसरा चरण: रीइन्फ़ोर्समेंट लर्निंग

    पहले चरण में न इस्तेमाल हुई दंत इमेज से, मूल लेबल के आधार पर लगभग 10,000 स्वतः जाँचे जाने वाले बहुविकल्पीय प्रश्न बनाकर GRPO प्रशिक्षण: हर प्रश्न पर 10 उत्तर लिए जाते हैं, पुरस्कार में उत्तर की शुद्धता (90%) और प्रारूप (10%) शामिल हैं, और उत्तर की अधिकतम लंबाई 8,192 टोकन है।

DentalGPT कैसे बना: डेटा संग्रह, पहले चरण का बहु-मोडल संरेखण और दूसरे चरण की रीइन्फ़ोर्समेंट लर्निंग (स्रोत: शोध-पत्र)

परिणाम: 7B मॉडल, औसत सटीकता GPT-5 से अधिक

पाँच दंत बेंचमार्क पर सटीकता (%), शोध-पत्र की तालिका 3 से

मॉडलMMOral-OPGमेडिकल VQA (दंत उपसमुच्चय)मुँह के अंदर की फ़ोटो Iमुँह के अंदर की फ़ोटो IIपैनोरमिक वर्गीकरणऔसत
Qwen2.5-VL-7B-Instruct (आधार मॉडल)27.046.148.861.850.046.7
HuatuoGPT-Vision36.338.555.251.253.847.0
MedGemma-27B-it50.641.852.656.261.052.4
Claude-Sonnet-4.5-Thinking50.353.955.266.755.856.4
Gemini-2.5-Pro-Thinking45.757.457.065.264.157.9
LLaMA-4-Maverick51.453.961.167.159.058.5
GPT-547.754.359.371.063.559.2
DentalGPT (7B)60.054.464.172.984.067.1

स्रोत: शोध-पत्र की तालिका 3; GPT-5, Thinking मॉडल और DentalGPT का मूल्यांकन जटिल तर्क मोड चालू रखकर किया गया

01

67.1% औसत सटीकता

GPT-5 (59.2%) से 7.9 अंक अधिक और आधार मॉडल (46.7%) से 20.4 अंक अधिक।

02

पैनोरमिक वर्गीकरण में 84.0%

दंत चिकित्सकों द्वारा एनोटेट और परस्पर जाँचे गए तीनों वर्गीकरण बेंचमार्क पर सर्वश्रेष्ठ; पैनोरमिक वर्गीकरण में आधार मॉडल और GPT-5 के 50.0% और 63.5% रहे।

03

दंत चिकित्सकों का मूल्यांकन

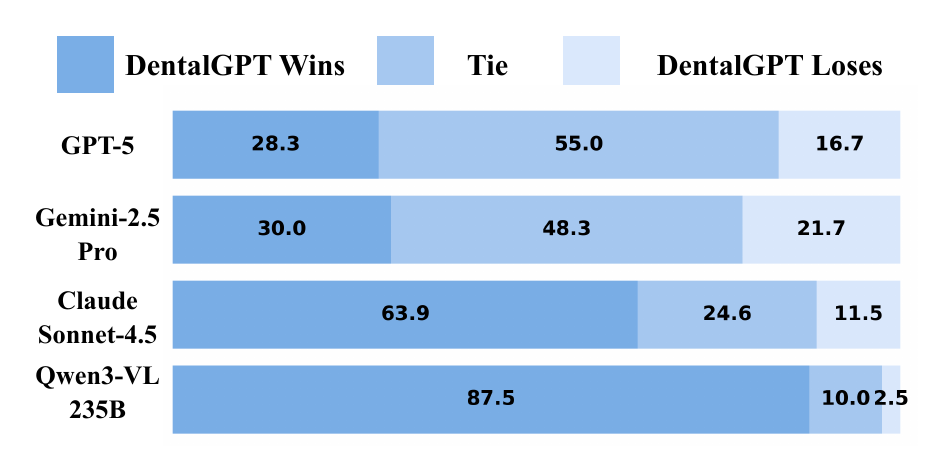
4 लाइसेंसधारी दंत चिकित्सकों ने 80 दंत इमेज पर उत्तरों की जोड़ीवार तुलना की: GPT-5 और Gemini-2.5-Pro के मुक़ाबले DentalGPT ने 28.3% और 30.0% बार जीत और 16.7% और 21.7% बार हार दर्ज की; Claude-Sonnet-4.5 और Qwen3-VL-235B के मुक़ाबले उसकी जीत 63.9% और 87.5% रही।

04

दोनों चरण अनिवार्य

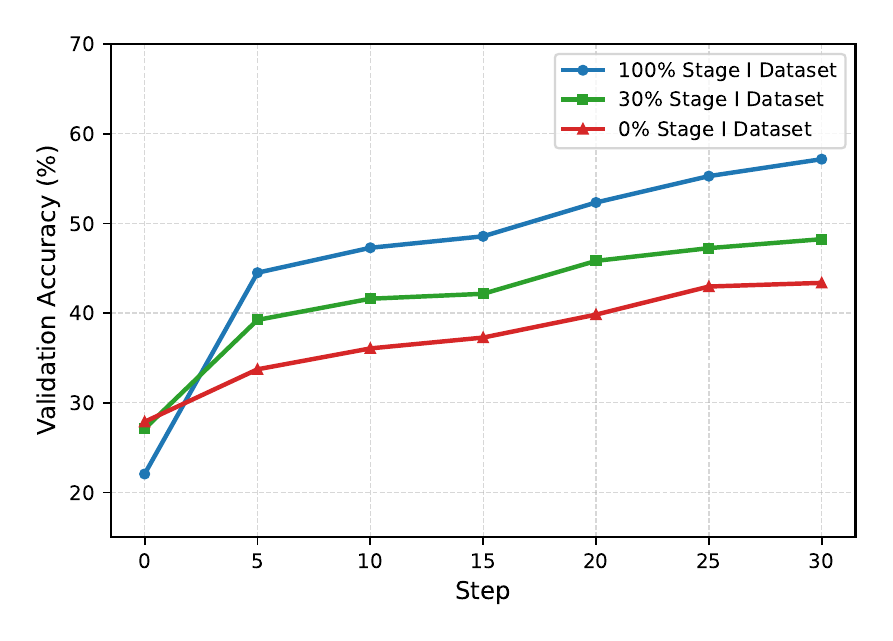
केवल पहले चरण के संरेखण से औसत सटीकता 46.7% से 63.2% हो जाती है; रीइन्फ़ोर्समेंट लर्निंग जोड़ने पर 67.1% तक पहुँचती है। संरेखण डेटा जितना अधिक, रीइन्फ़ोर्समेंट लर्निंग की सीमा उतनी ऊँची।

4 लाइसेंसधारी दंत चिकित्सकों की जोड़ीवार तुलना: DentalGPT की जीत, बराबरी और हार का अनुपात (%) (स्रोत: शोध-पत्र)
पहले चरण के डेटा के अलग-अलग अनुपात के साथ रीइन्फ़ोर्समेंट लर्निंग के दौरान सत्यापन सटीकता (स्रोत: शोध-पत्र)

DentalAgent: पेशेवर दंत कार्यों के लिए एजेंट

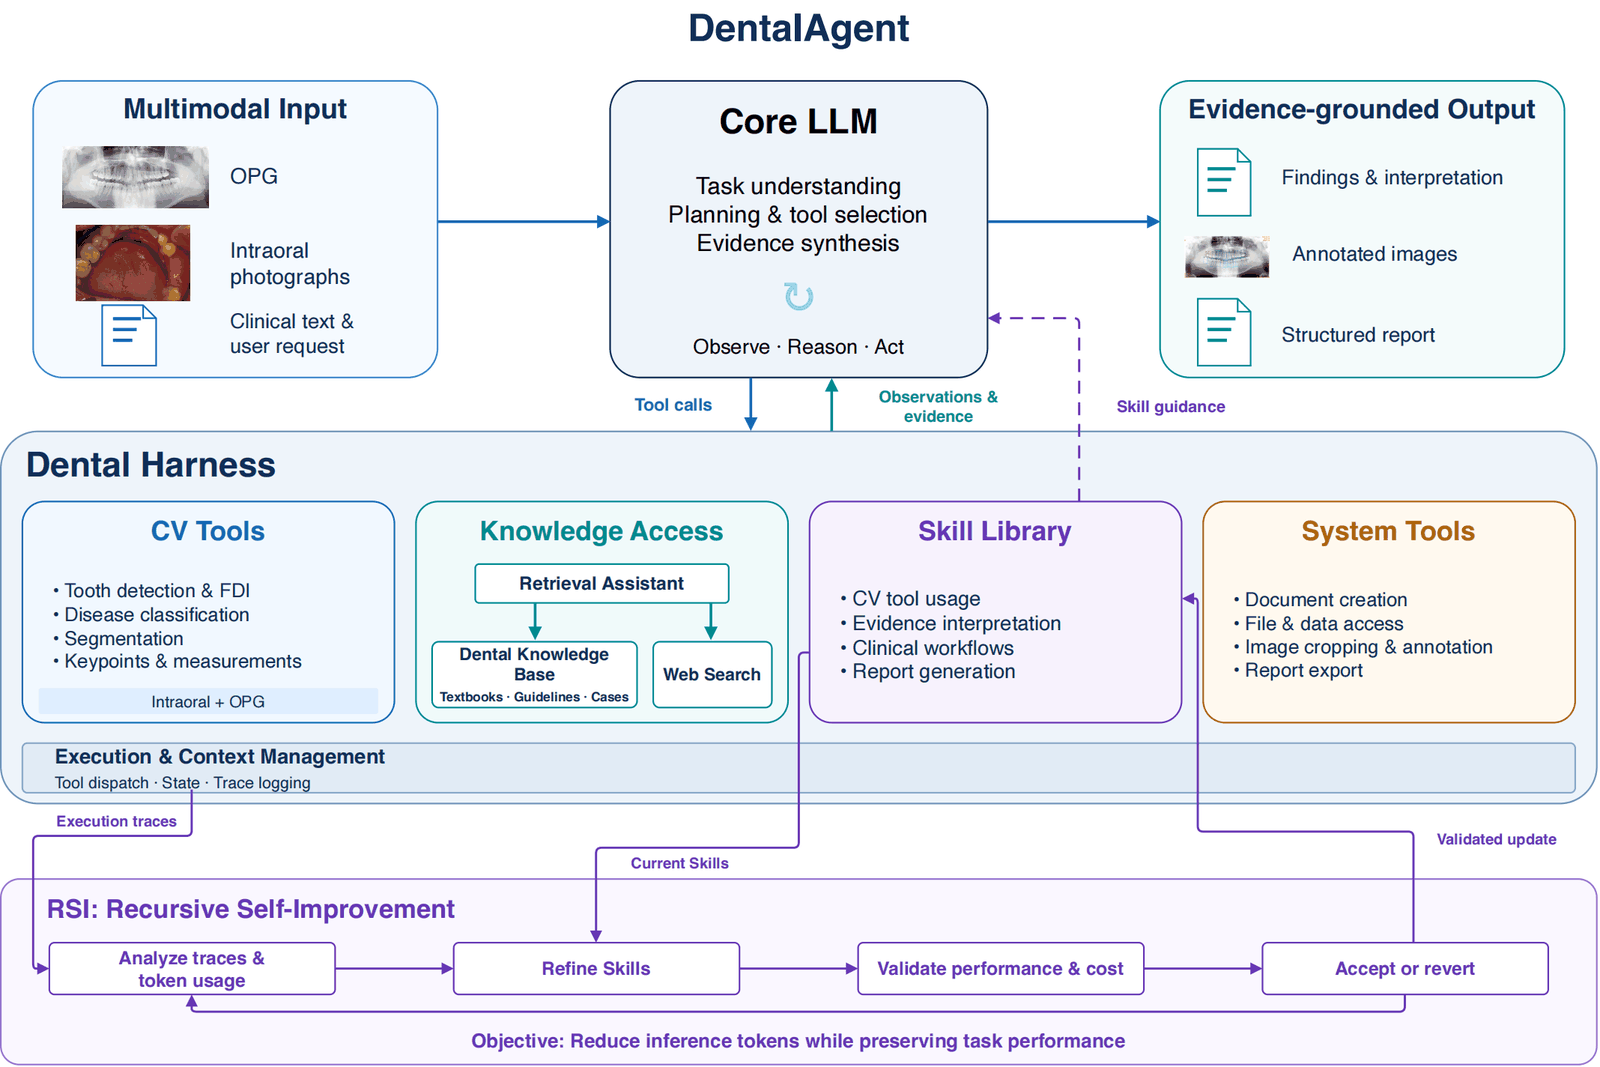
बड़ा मॉडल केंद्र में, जो बहु-मोडल इनपुट, पेशेवर टूल और चिकित्सा ज्ञान को मिलाकर प्रमाण-आधारित सहायक निर्णय देता है

DentalAgent ढाँचा: बहु-मोडल इनपुट, केंद्रीय बड़ा मॉडल, दंत कार्य निष्पादन परत और प्रमाण-समर्थित आउटपुट
01

पेशेवर टूल का उपयोग

FDI नंबरिंग सहित दाँत पहचान, रोग वर्गीकरण, सेगमेंटेशन, मुख्य बिंदु और माप जैसे विज़न टूल मुँह के अंदर की फ़ोटो और पैनोरमिक रेडियोग्राफ़ संसाधित करते हैं; बड़ा मॉडल टूल चलाने का क्रम तय करता है और परिणाम जोड़ता है।

02

चिकित्सा साक्ष्य का सहारा

पाठ्यपुस्तकों, दिशानिर्देशों और केसों से बने दंत ज्ञानकोश में खोजता है, और टूल के अवलोकन व खोजे गए ज्ञान को साक्ष्य बनाकर निष्कर्ष, चिह्नित इमेज और संरचित रिपोर्ट देता है।

03

निरंतर फ़ीडबैक से सुधार

एक पुनरावर्ती आत्म-सुधार चक्र निष्पादन-मार्ग और टोकन उपयोग का विश्लेषण करता है, कौशल सुधारता है और प्रदर्शन व लागत जाँचता है—प्रदर्शन बनाए रखते हुए इनफ़रेंस लागत घटाता है।

निर्णय में सहायक के रूप में: यह साक्ष्य सहित निष्कर्ष और रिपोर्ट देता है, जिन्हें दंत चिकित्सक जाँचते हैं। दंत पाठ और इमेजिंग कार्यों पर इसका प्रारंभिक मूल्यांकन जारी है।

DentalAgent की तकनीकी व्याख्या पढ़ें →

VR/AR और 3D विज़ुअलाइज़ेशन: दंत उपचार जो समझने में आसान और कम तनावपूर्ण हो

बड़े मॉडलों के अलावा, हम रोगियों के अनुभव और मौखिक स्वास्थ्य शिक्षा को बेहतर बनाने के लिए इमर्सिव और 3D विज़ुअलाइज़ेशन तकनीक का उपयोग करते हैं।

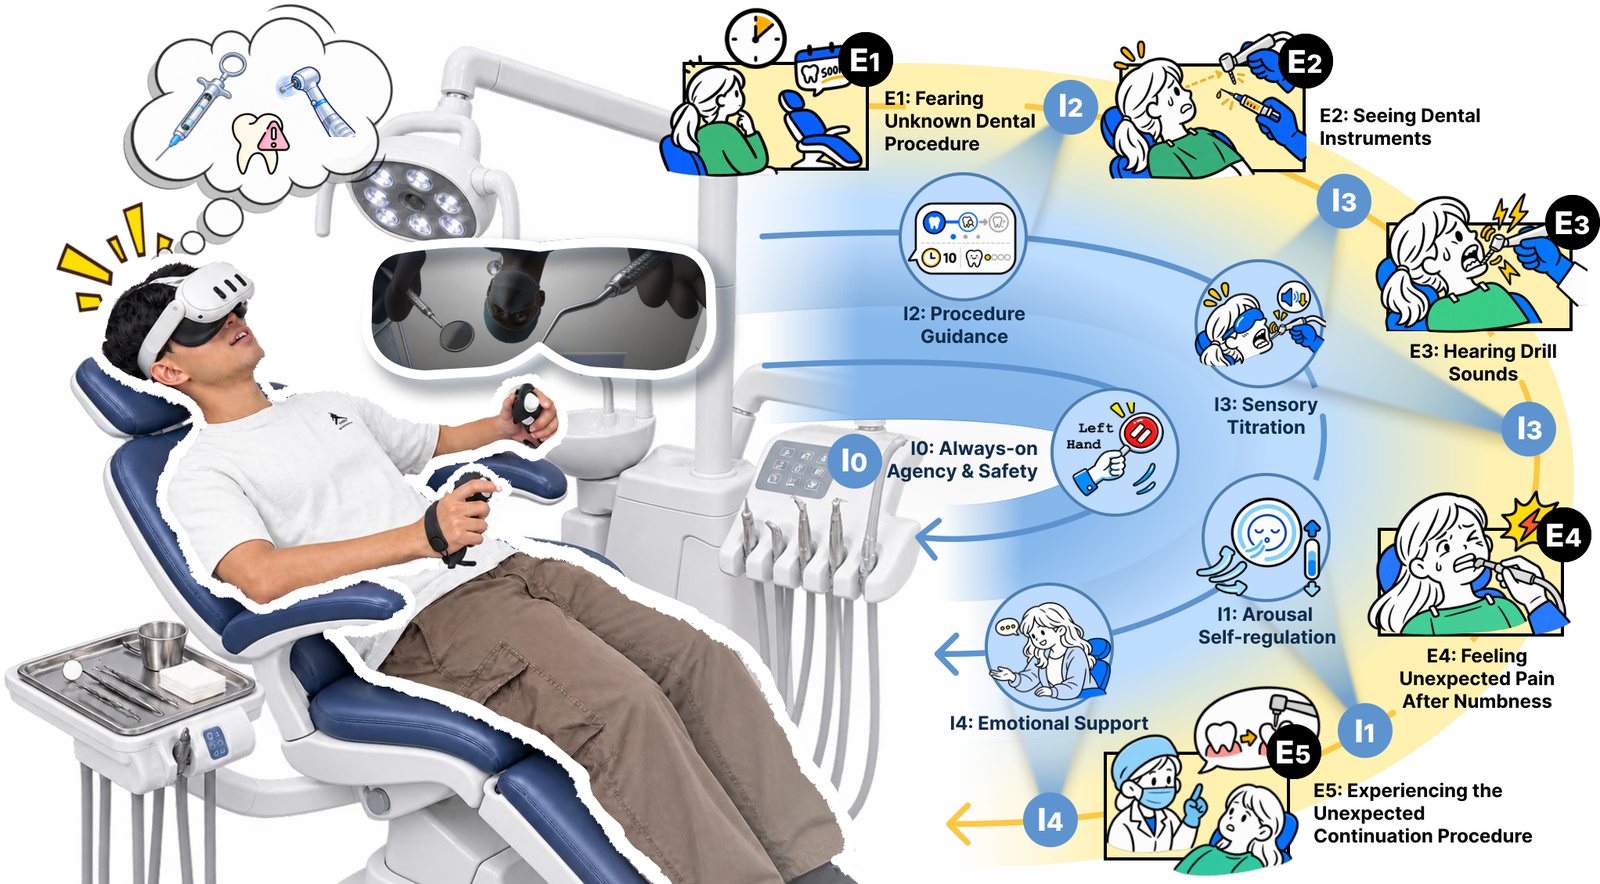
घटना-आधारित दंत चिंता VR सहायता प्रणाली का अवलोकन (स्रोत: शोध-पत्र)
arXiv 2026 · मानव–कंप्यूटर इंटरैक्शन

दंत चिंता के लिए VR सहायता

अक्ल दाढ़ निकालने की एक सिम्युलेटेड प्रक्रिया को चिंता के 5 क्षणों में बाँटा गया है, और हर क्षण के लिए उपयुक्त सहायता दी जाती है: प्रक्रिया की जानकारी, दृश्य और ध्वनि उत्तेजना को धीमा करना, साँस लेने का मार्गदर्शन और एक वर्चुअल साथी। रोगी किसी भी समय रोक सकता है या बाहर निकल सकता है। 24 लोगों के यादृच्छिक अध्ययन में हस्तक्षेप समूह का चिंता स्कोर नियंत्रण समूह से औसतन 12.8 अंक कम रहा (100 अंकों के पैमाने पर)।
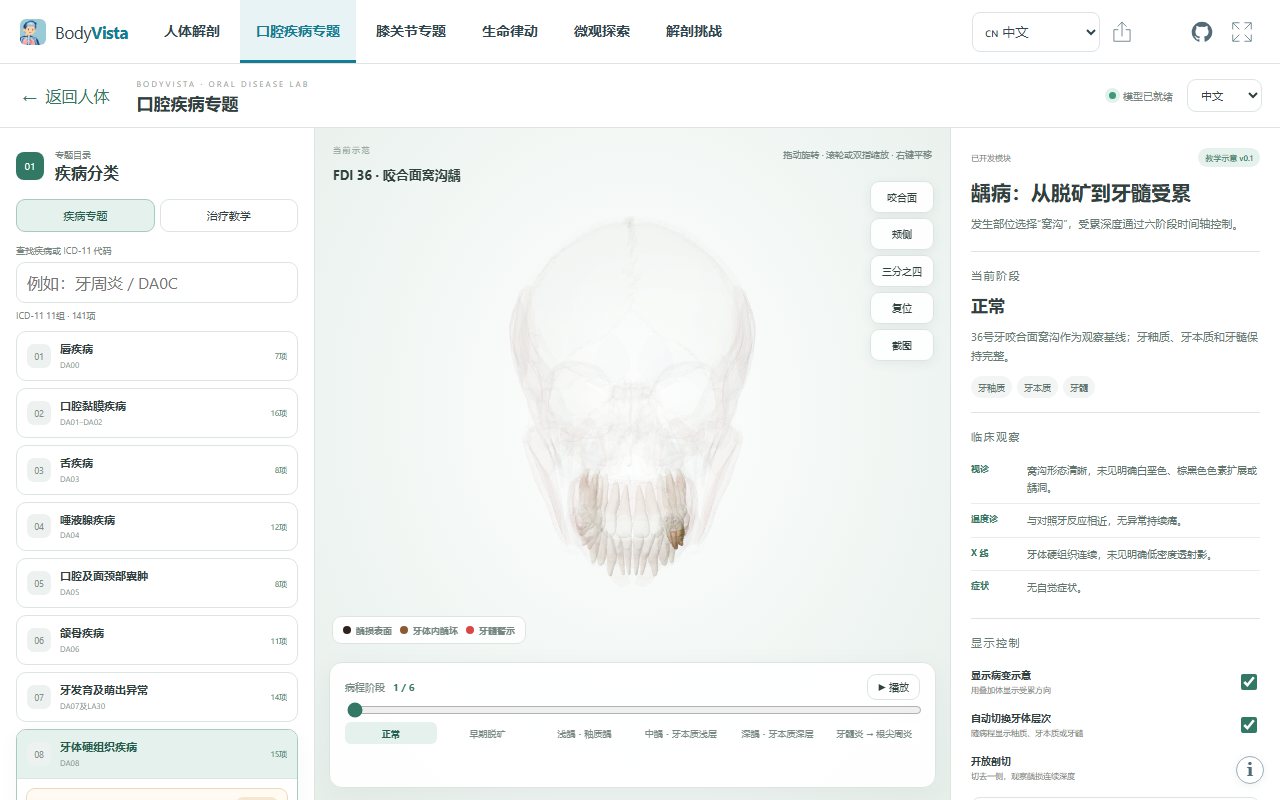
DentalVista का मौखिक रोग विषय: दंत क्षय का चरणबद्ध प्रदर्शन, खनिज क्षरण से लेकर पल्प तक पहुँचने तक
3D विज़ुअलाइज़ेशन · चिकित्सा शिक्षा

DentalVista: दाँतों और मानव शरीर की 3D शारीरिकी

ओपन-सोर्स प्रोजेक्ट BodyVista पर आधारित। ब्राउज़र में ही 3D मानव शारीरिकी और मौखिक रोगों के विषयों को देखें। मौखिक रोगों को ICD-11 के अनुसार 11 समूहों और 141 प्रविष्टियों में व्यवस्थित किया गया है, और दंत क्षय जैसे विषय चरणबद्ध एनिमेशन में रोग का विकास दिखाते हैं। सेक्शन, माप, एनोटेशन और शारीरिकी चुनौतियाँ उपलब्ध हैं; टच स्क्रीन पर एक उँगली से घुमाएँ और दो उँगलियों से ज़ूम करें।

बहु-मोडल डेटा और विशेष रोग डेटा प्रणाली

इमेज, टेक्स्ट, दीर्घकालिक फ़ॉलो-अप और विशेष रोग ज्ञान को कवर करने वाला दंत बहु-मोडल डेटा आधार

9 करोड़+चिकित्सा प्रशिक्षण और मूल्यांकन रिकॉर्ड
6.05 करोड़ जोड़ेचिकित्सा इमेज–टेक्स्ट डेटा, PubMedVision-Plus
2.6 करोड़चीनी चिकित्सा प्रश्नोत्तर, Huatuo-26M
1.2 लाख+एनोटेट की गई दंत इमेज, DentalGPT

डेटा संपदा

टीम ने टेक्स्ट, इमेज, वीडियो और कई भाषाओं में 9 करोड़ से अधिक चिकित्सा प्रशिक्षण और मूल्यांकन रिकॉर्ड तैयार किए हैं, जिनमें चिकित्सा प्री-ट्रेनिंग और फ़ाइन-ट्यूनिंग डेटा तथा विशेषज्ञों द्वारा एनोटेट डेटा शामिल हैं।

डेटा प्रकारस्रोतमात्रा
चिकित्सा इमेज–टेक्स्ट प्री-ट्रेनिंग डेटासेट
PubMedVision-Plus60,513,727 जोड़े इनमें लगभग 1.2 करोड़ उच्च गुणवत्ता वाले मुख्य जोड़े
बहु-मोडल चिकित्सा LLM संरेखण और संवाद डेटासेट
PubMedVision1,294,062
बहु-मोडल चिकित्सा संवाद डेटासेट
Med-MAT2,360,000
बहु-मोडल चिकित्सा वीडियो निर्माण डेटासेट
MedVideoCap-55K55,000
बहुभाषी चिकित्सा पाठ डेटासेट
ApolloMoEDataset292,914
बड़े पैमाने का चिकित्सा पाठ डेटासेट
Huatuo-26M26,000,000
जटिल-तर्क पाठ डेटासेट
medical-o1-reasoning-SFT50,000
दंत बहु-मोडल प्रशिक्षण सेट
DentalGPT240,000 इनमें 1,20,000 दंत इमेज

एनोटेशन प्लेटफ़ॉर्म

चिकित्सा इमेज प्रबंधन, सहयोगी एनोटेशन, समीक्षा और गुणवत्ता नियंत्रण तथा AI प्री-एनोटेशन वाला एकीकृत डेटा उत्पादन प्लेटफ़ॉर्म।

चिकित्सा इमेज डेटा प्रबंधन इंटरफ़ेसचिकित्सा इमेज सहयोगी एनोटेशन इंटरफ़ेस

दंत मूल्यांकन: GlobalDentBench और OmniDentBench

बहुराष्ट्रीय, विशेषज्ञ-स्तरीय मूल्यांकन मॉडल की तर्क-कमज़ोरियाँ उजागर करते हैं और DentalGPT के निरंतर सुधार की दिशा तय करते हैं

“क्या यह AI मॉडल वास्तविक नैदानिक परिस्थितियों में सुरक्षित, प्रभावी और उपयोगी है?”

DentalGPT का वैश्विक सत्यापन और बहु-केंद्रीय सहयोग

किसी दंत बड़े मॉडल का दुनिया का पहला सहयोगी सत्यापन, संस्थानों, क्षेत्रों और आबादियों में फैले AI सत्यापन नेटवर्क के साथ

अंतरराष्ट्रीय सहयोग समझौते

अंतरराष्ट्रीय सहयोग समझौते और भागीदार देश व क्षेत्र

बहु-केंद्रीय सहयोग

नैदानिक विशेषज्ञों से सहयोग

दंत विशेषज्ञ मॉडल सत्यापन और क्षमता आकलन में भाग लेते हैं।

संस्थानों के बीच डेटा सहयोग

संस्थानों में फैली बहु-केंद्रीय डेटा सत्यापन प्रणाली।

मिलकर बेंचमार्क निर्माण

दंत AI के लिए मानकीकृत मूल्यांकन प्रणाली मिलकर बनाना।

संयुक्त शोध

संयुक्त परियोजनाओं, बहु-केंद्रीय अध्ययनों और शोध के उपयोग में सहयोग।

आधारभूत तकनीक: HuatuoGPT-o1 से DentalGPT तक

DentalGPT चिकित्सा बड़े मॉडलों पर टीम के लंबे अनुभव पर आधारित है: इसका जटिल-तर्क डेटा HuatuoGPT-o1 की विधि से बना है, और इसकी बहु-मोडल क्षमता “समझने” से “बनाने” तक फैली है

जटिल चिकित्सा तर्क

HuatuoGPT-o1: धीमे तर्क और गहरी सोच वाला चिकित्सा बड़ा मॉडल

गणित के प्रश्नों के विपरीत, चिकित्सा तर्क की जाँच कठिन है। HuatuoGPT-o1 ने “सत्यापन-योग्य चिकित्सा प्रश्न” और चिकित्सा सत्यापक पेश किया: पहले सत्यापक के मार्गदर्शन में खोजे गए जटिल तर्क-पथों पर मॉडल को फ़ाइन-ट्यून किया जाता है, फिर सत्यापक-आधारित पुरस्कार वाली रीइन्फ़ोर्समेंट लर्निंग से उसे और बेहतर बनाया जाता है। केवल 40,000 सत्यापन-योग्य प्रश्नों से इसने सामान्य और चिकित्सा बेसलाइन मॉडलों को पीछे छोड़ा और व्यापक ध्यान खींचा।

DentalGPT के पहले चरण का जटिल-तर्क डेटा इसी विधि से बना है, और दूसरा चरण भी रीइन्फ़ोर्समेंट लर्निंग के लिए स्वतः जाँचे जाने वाले प्रश्नों का उपयोग करता है। FreedomAI के CTO Zhenyang Cai और मुख्य AI वैज्ञानिक Benyou Wang दोनों इस शोध-पत्र के लेखक हैं।

HuatuoGPT-o1 की दो-चरणीय विधि: सत्यापन-योग्य चिकित्सा प्रश्नों से जटिल तर्क-पथ खोजना, फिर रीइन्फ़ोर्समेंट लर्निंग से सुधारजटिल चिकित्सा तर्क मॉडल की बातचीत का उदाहरण
  1. Junying Chen, Zhenyang Cai, Ke Ji, Xidong Wang, Wanlong Liu, Rongsheng Wang, Jianye Hou, Benyou Wang. HuatuoGPT-o1, Towards Medical Complex Reasoning with LLMs. arXiv:2412.18925
  2. Junying Chen, Chi Gui, Anningzhe Gao, Ke Ji, Xidong Wang, Xiang Wan, Benyou Wang. CoD, Towards an Interpretable Medical Agent using Chain of Diagnosis. arXiv:2407.13301
चिकित्सा वीडियो निर्माण

MedGen: चिकित्सा वीडियो बनाने वाला मॉडल

नैदानिक प्रशिक्षण, शिक्षण और सिमुलेशन के लिए चिकित्सा वीडियो अहम हैं, लेकिन सामान्य वीडियो-निर्माण मॉडल चिकित्सा निर्देशों पर अक्सर अवास्तविक या ग़लत सामग्री बनाते हैं। द चाइनीज़ यूनिवर्सिटी ऑफ़ हांगकांग, शेनझेन की FreedomAI टीम और FreedomAI ने MedVideoCap-55K जारी किया (वास्तविक चिकित्सा स्थितियों के 55,000 से अधिक क्लिप; शोध-पत्र के अनुसार चिकित्सा वीडियो निर्माण के लिए पहला बड़े पैमाने का, विविध और विस्तृत विवरण वाला डेटासेट) और उस पर MedGen को प्रशिक्षित किया। कई बेंचमार्क पर इसकी दृश्य गुणवत्ता और चिकित्सा सटीकता ओपन-सोर्स मॉडलों में सबसे आगे है और व्यावसायिक प्रणालियों के बराबर है।

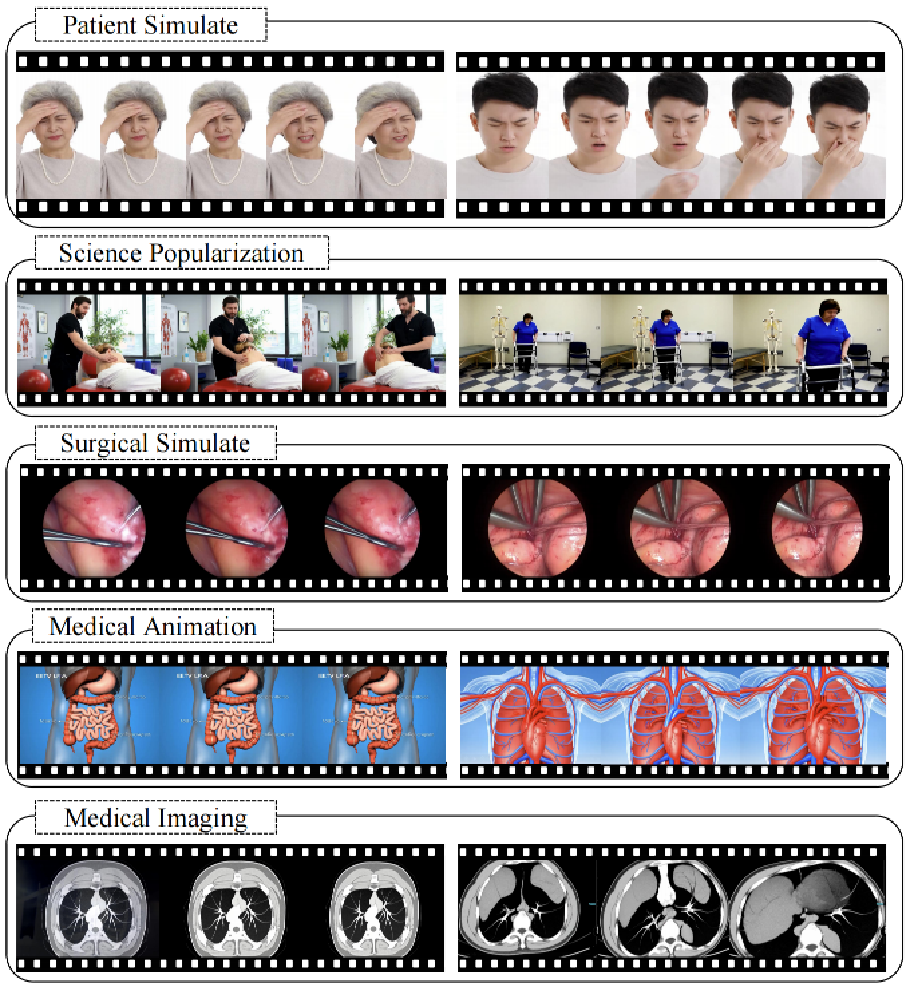
MedGen के उपयोग

MedGen चिकित्सा सामग्री की सटीकता बनाए रखते हुए उच्च गुणवत्ता के वीडियो बनाता है—सर्जरी सिमुलेशन, चिकित्सा शिक्षा, विज्ञान एनिमेशन और टेलीमेडिसिन के लिए।

आगे के कार्यों के लिए डेटा संवर्धन

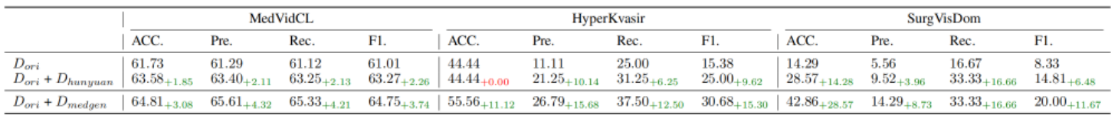
सर्जिकल प्रक्रिया पहचान, घाव का पता लगाने और निदान सहायता जैसे चिकित्सा वीडियो कार्यों में अक्सर लेबल की कमी, असंतुलित नमूने और गोपनीयता की बाधाएँ होती हैं। MedGen से बने वीडियो को मूल प्रशिक्षण डेटा के साथ मिलाकर हमने कई चिकित्सा वीडियो वर्गीकरण कार्यों में डेटा संवर्धन टूल के रूप में इसकी उपयोगिता परखी।

MedGen से डेटा संवर्धन की तुलना

तीन पर्यवेक्षित चिकित्सा वीडियो कार्यों में डेटा संवर्धन के रूप में MedGen और HunyuanVideo की तुलना

MedGen के उपयोग
रोगी सिमुलेशन, स्वास्थ्य शिक्षा, सर्जिकल प्रशिक्षण, चिकित्सा एनिमेशन और चिकित्सा इमेजिंग में MedGen के उपयोग

टीम और साझेदार संस्थान

लेखकों के संस्थान

Shenzhen Stomatology Hospital (Pingshan) of Southern Medical Universityद चाइनीज़ यूनिवर्सिटी ऑफ़ हांगकांग, शेनझेनPeking UniversityFreedomAIदंत चिकित्सा संकाय, हांगकांग विश्वविद्यालयBeijing Institute of Collaborative Innovationनेशनल इंस्टीट्यूट ऑफ़ हेल्थ डेटा साइंस (शेनझेन)Shenzhen Loop Area Instituteशेनझेन रिसर्च इंस्टीट्यूट ऑफ़ बिग डेटा