
Évaluation dentaire
Avec des experts dentaires du monde entier, nous évaluons comment les grands modèles raisonnent en pratique dentaire réelle, et quels risques ils présentent.
Où le raisonnement dentaire de niveau expert échoue-t-il, et quelle supervision faut-il pour le corriger ?
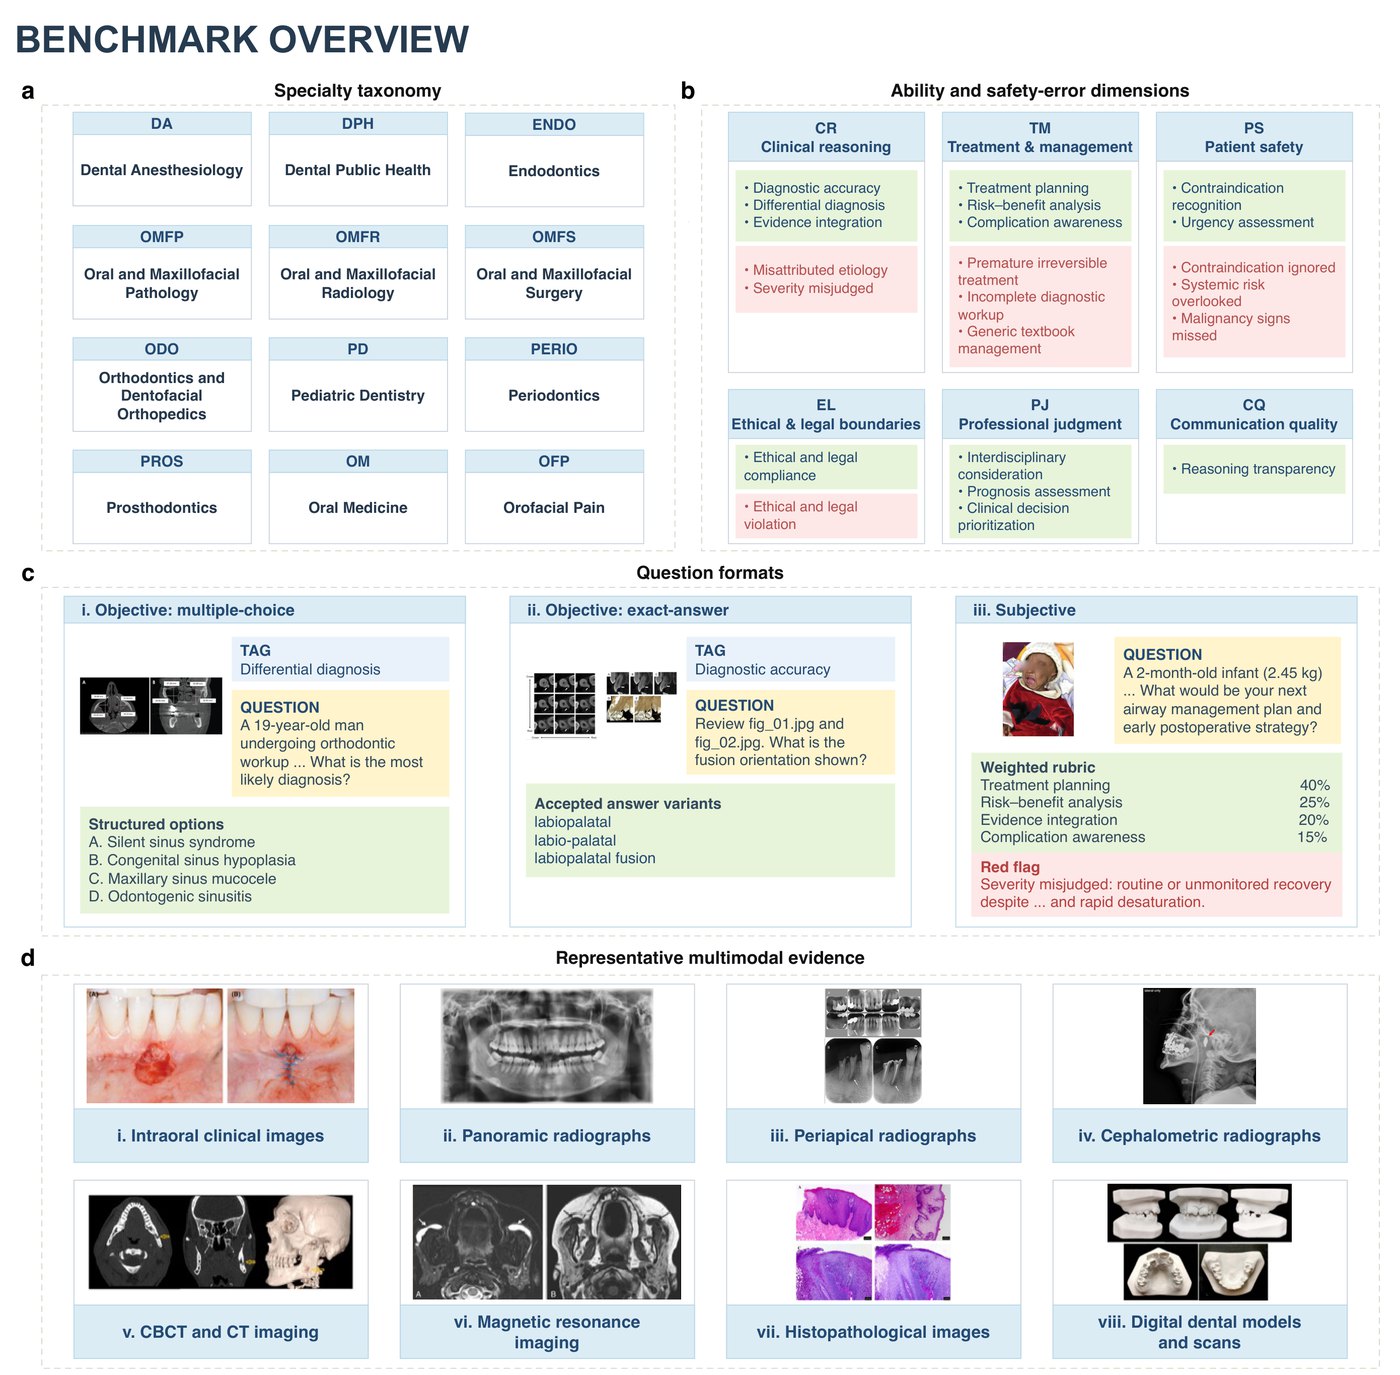
Après GlobalDentBench, l'équipe construit OmniDentBench, plus exigeant. Les questions proviennent de rapports de cas et d'articles en libre accès de PubMed Central ; elles sont rédigées par des agents, filtrées par difficulté par des modèles de pointe et relues une à une par des experts dentaires de Chine et de l'étranger, afin d'évaluer les grands modèles sur des décisions cliniques de niveau expert et de déterminer de quelle supervision professionnelle ils ont le plus besoin.
Dimensions de compétence et de sécurité
Types de questions
- Questions objectives à choix unique
- Questions objectives à réponse exacte (formes équivalentes acceptées)
- Questions ouvertes (grilles pondérées + lignes rouges de sécurité)
Données d'imagerie
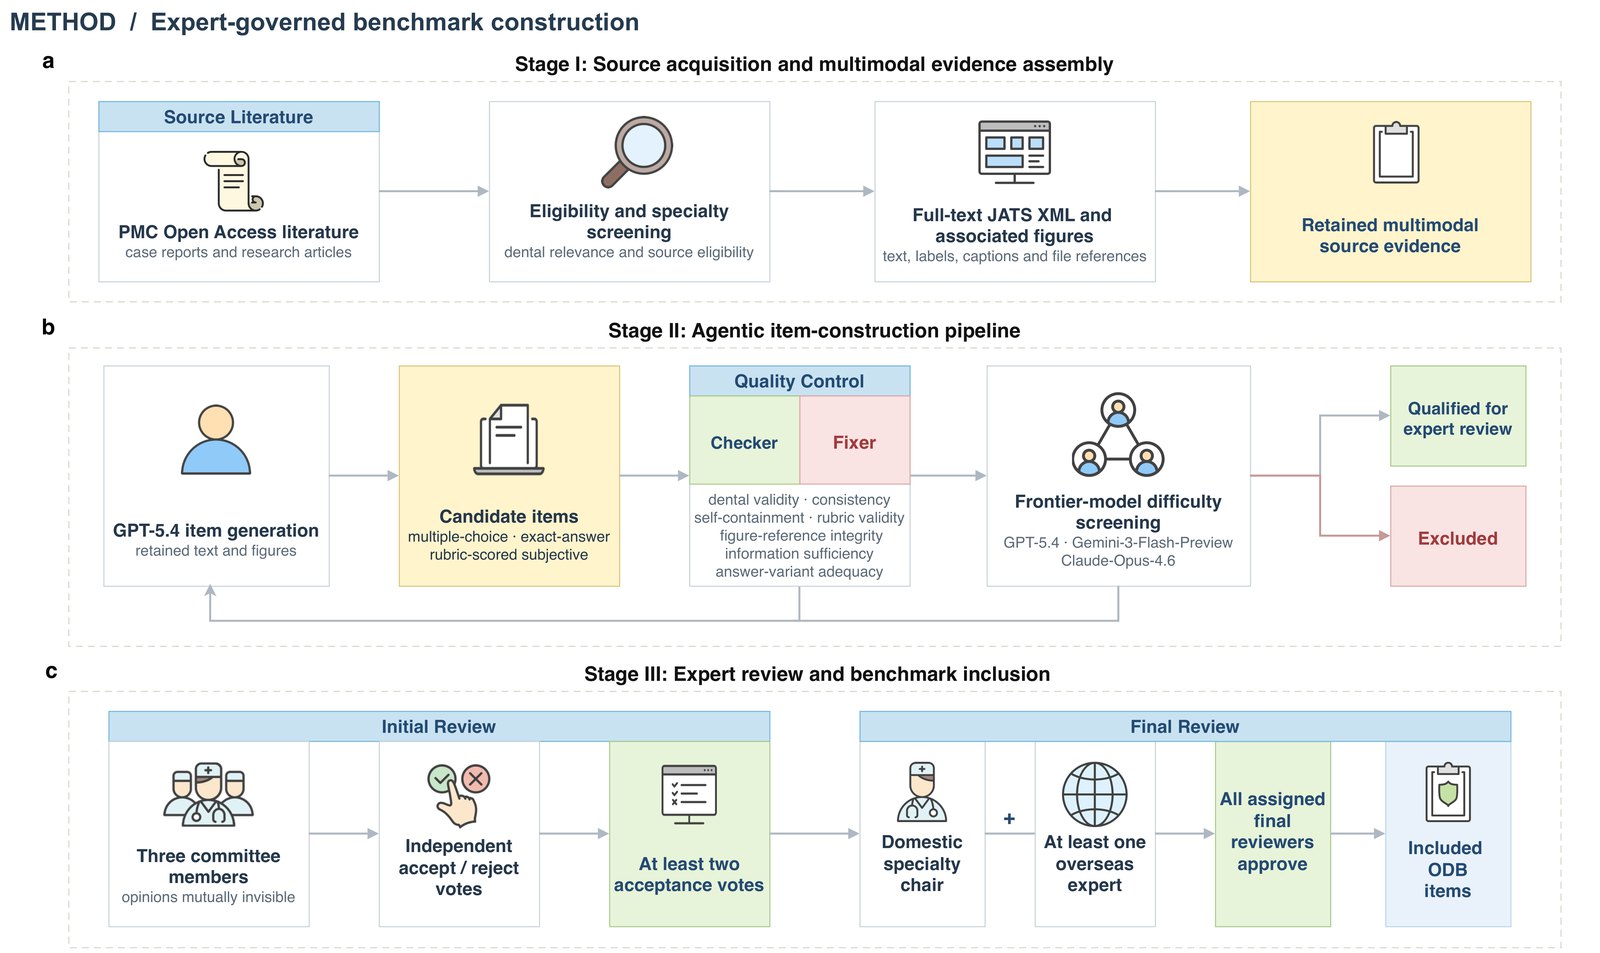
- 1Traçabilité des sources et assemblage des preuves multimodales
Les rapports de cas et articles en libre accès de PubMed Central sont sélectionnés selon leur pertinence dentaire et l'éligibilité de la source ; le texte intégral et les images associées sont extraits, en conservant des preuves multimodales traçables.
- 2Questions rédigées par des agents et filtrage par difficulté
GPT-5.4 rédige des questions candidates à partir des textes et images retenus ; après un contrôle qualité avec vérification et correction, GPT-5.4, Gemini-3-Flash-Preview et Claude-Opus-4.6 les filtrent par difficulté, et seules les questions retenues passent à la relecture experte.
- 3Relecture experte et intégration
Trois membres du comité votent de façon indépendante, sans voir les votes des autres, et au moins deux doivent approuver ; la relecture finale associe un président de comité de spécialité chinois et au moins un expert étranger, et une question n'est retenue que si tous les relecteurs finaux sont d'accord.
Les premiers résultats montrent que les modèles de pointe présentent encore des faiblesses nettes en raisonnement dentaire de niveau expert, et que certaines réponses franchissent des lignes rouges de sécurité. Les résultats complets seront publiés avec l'article.
ContributeursJunjie Zhao, Ziying Sheng, Jiajun You, Zuolin Jin, Junwen Wang, Benyou Wang, ainsi que des experts dentaires de Chine et de l'étranger de l'OmniDentBench Consortium
InstitutionsUniversité de Hong Kong, Institut d'innovation collaborative de Pékin, Université chinoise de Hong Kong (Shenzhen), Shenzhen Loop Area Institute, Hôpital stomatologique de Shenzhen (Pingshan) de l'Université médicale du Sud