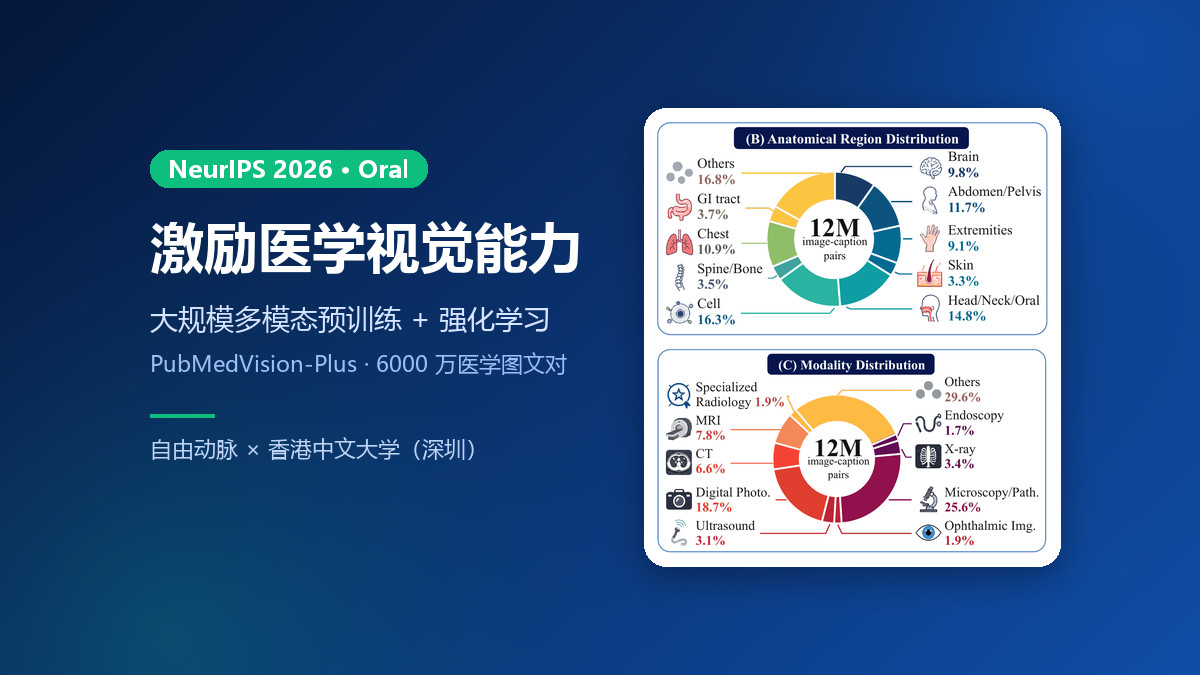
NeurIPS 2026 Oral | FreedomAI et l'Université chinoise de Hong Kong (Shenzhen) présentent un grand modèle multimodal médical qui s'appuie sur l'apprentissage par renforcement pour libérer ses capacités de vision médicale
HuatuoGPT-Vision-2 est un grand modèle multimodal médical entraîné par « pré-entraînement + apprentissage par renforcement ». Sa version 32B obtient en moyenne 74,0 sur huit benchmarks médicaux, devant GPT-5.4-mini.
Lire la suite →