NeurIPS 2026 Oral|自由动脉携手香港中文大学(深圳)推出医疗多模态大模型,用强化学习激发医学视觉能力
让多模态大模型读懂医学影像,难点不只是数据少。即便模型在预训练阶段“见过”海量医学图像,这些知识也未必能在回答问题时被调用出来。一项新研究发现,常规的监督微调很难把这部分知识激发出来。
香港中文大学(深圳)研究团队与自由动脉团队成员合作完成的论文《Incentivizing Medical Vision Capabilities from Large-Scale Multimodal Pre-training》入选 NeurIPS 2026 Oral。研究给出了一条简洁的医疗视觉语言模型训练路线:先用从 PubMed 文献中挖掘的医学图文数据做大规模多模态预训练,再用直接从预训练数据中合成的题目做强化学习,“激励”模型调用学到的医学视觉知识。在八项医学多模态基准上,32B 版本的 HuatuoGPT-Vision-2 平均得分 74.0,超过闭源的 GPT-5.4-mini(71.1)以及同规模的开源通用模型和医疗模型,显著缩小了与领先闭源模型的差距。
自由动脉 CTO 蔡镇阳为论文第二作者,医疗产品副总裁冯相义为论文作者之一,自由动脉首席 AI 科学家、香港中文大学(深圳)助理教授王本友为论文通讯作者。论文将于 12 月 8 日在 NeurIPS 2026 悉尼会场作口头报告(Oral)。
论文标题:Incentivizing Medical Vision Capabilities from Large-Scale Multimodal Pre-training
会议:NeurIPS 2026(Oral)
论文链接:https://openreview.net/forum?id=0BXKsjKlFJ
代码:https://github.com/FreedomIntelligence/HuatuoGPT-Vision-2
数据:https://huggingface.co/datasets/FreedomIntelligence/PubMedVision-Plus
作者:Junying Chen、Zhenyang Cai(蔡镇阳)、Yunjin Yang、Kunyuan Cai、Rongsheng Wang、Xidong Wang、Geyang Yu、Xiangyi Feng(冯相义)、Benyou Wang(王本友,通讯作者)
作者单位:香港中文大学(深圳)、深圳河套学院、深圳市大数据研究院、国家健康医疗大数据研究院(深圳)
背景:医学知识“学进去了”,却“用不出来”
构建好用的医疗视觉语言模型(VLM,Vision-Language Model)有两道坎:一是高质量的医学领域数据稀缺,二是模型在预训练中学到的医学视觉知识很难被激发出来。
此前,课题组在 HuatuoGPT-Vision(EMNLP 2024)中基于 PubMed 文献构建了 130 万条医学视觉问答数据 PubMedVision。新工作沿着这条路线继续放大数据规模,并聚焦一个更关键的问题:预训练学到的知识,怎样才能真正用起来?
论文给出的答案是:在大规模医学预训练之后,传统的监督微调(SFT,Supervised Fine-Tuning)难以激发预训练知识;改用强化学习(RL,Reinforcement Learning),并让训练题目直接来自预训练数据本身,模型就能被“激励”去调用这些知识。
方法:两阶段配方
论文提出的医疗视觉语言模型名为 HuatuoGPT-Vision-2,是 HuatuoGPT 系列的第二代医疗视觉语言模型,以 Qwen3-VL-8B-Instruct 和 Qwen3-VL-32B-Instruct 为基座,训练分为两个阶段。
第一阶段:把医学多模态预训练做大
团队从 2013–2026 年间的 1520 万篇 PubMed 论文中抽取插图及其图注,得到 6051 万对医学图文数据,命名为 PubMedVision-Plus。论文称,这是目前规模最大的医学图文数据集。
随后,数据经过三轮清洗:先做医学影像检测,剔除图表、表格、示意图等非医学影像内容(剩余 1842 万对);再用大语言模型按图注的信息量和临床价值过滤(剩余 1370 万对);最后用视觉语言模型检查图文一致性与图像质量,得到约 1200 万对高质量核心数据 PubMedVision-Plus-Core。整个过程保留原始插图和作者撰写的图注,不做生成式改写,以避免合成图注带来的幻觉。
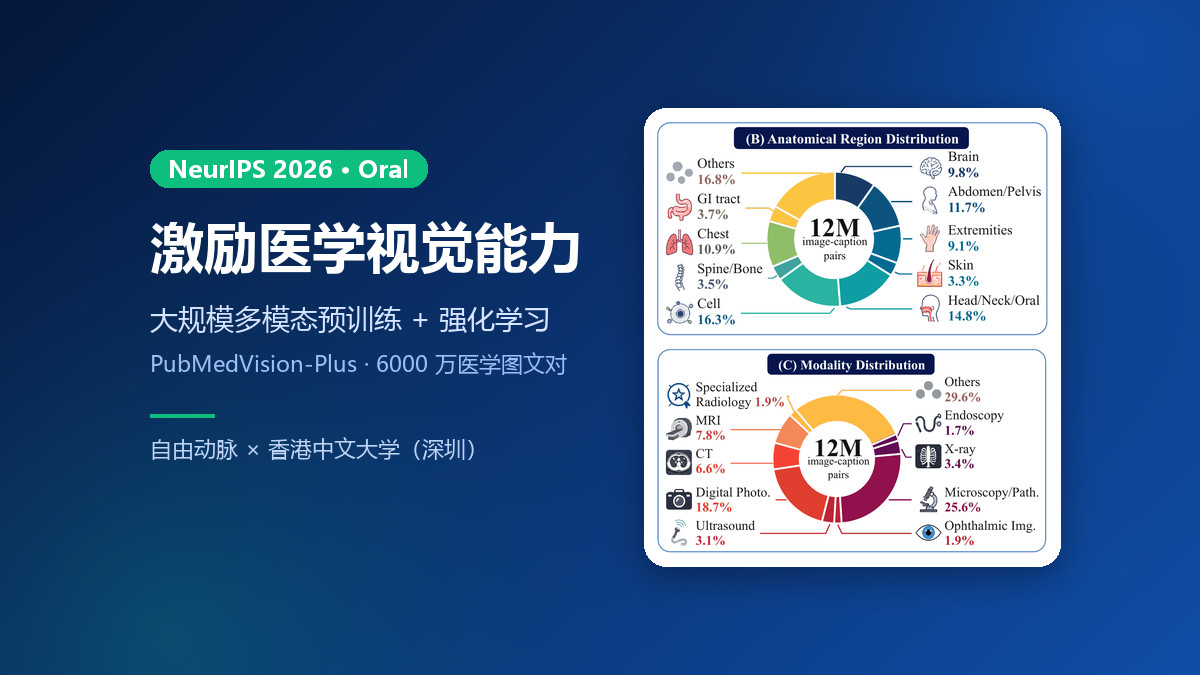
从分布看,核心数据覆盖显微/病理(25.6%)、数码照片(18.7%)、MRI(7.8%)、CT(6.6%)、X 光(3.4%)、超声(3.1%)、眼科影像(1.9%)、内镜(1.7%)等成像模态;按解剖部位划分,细胞层面占 16.3%,头颈及口腔占 14.8%,腹部/盆腔占 11.7%,胸部占 10.9%。团队在这批数据上对 Qwen3-VL 做继续预训练,得到医学预训练模型。
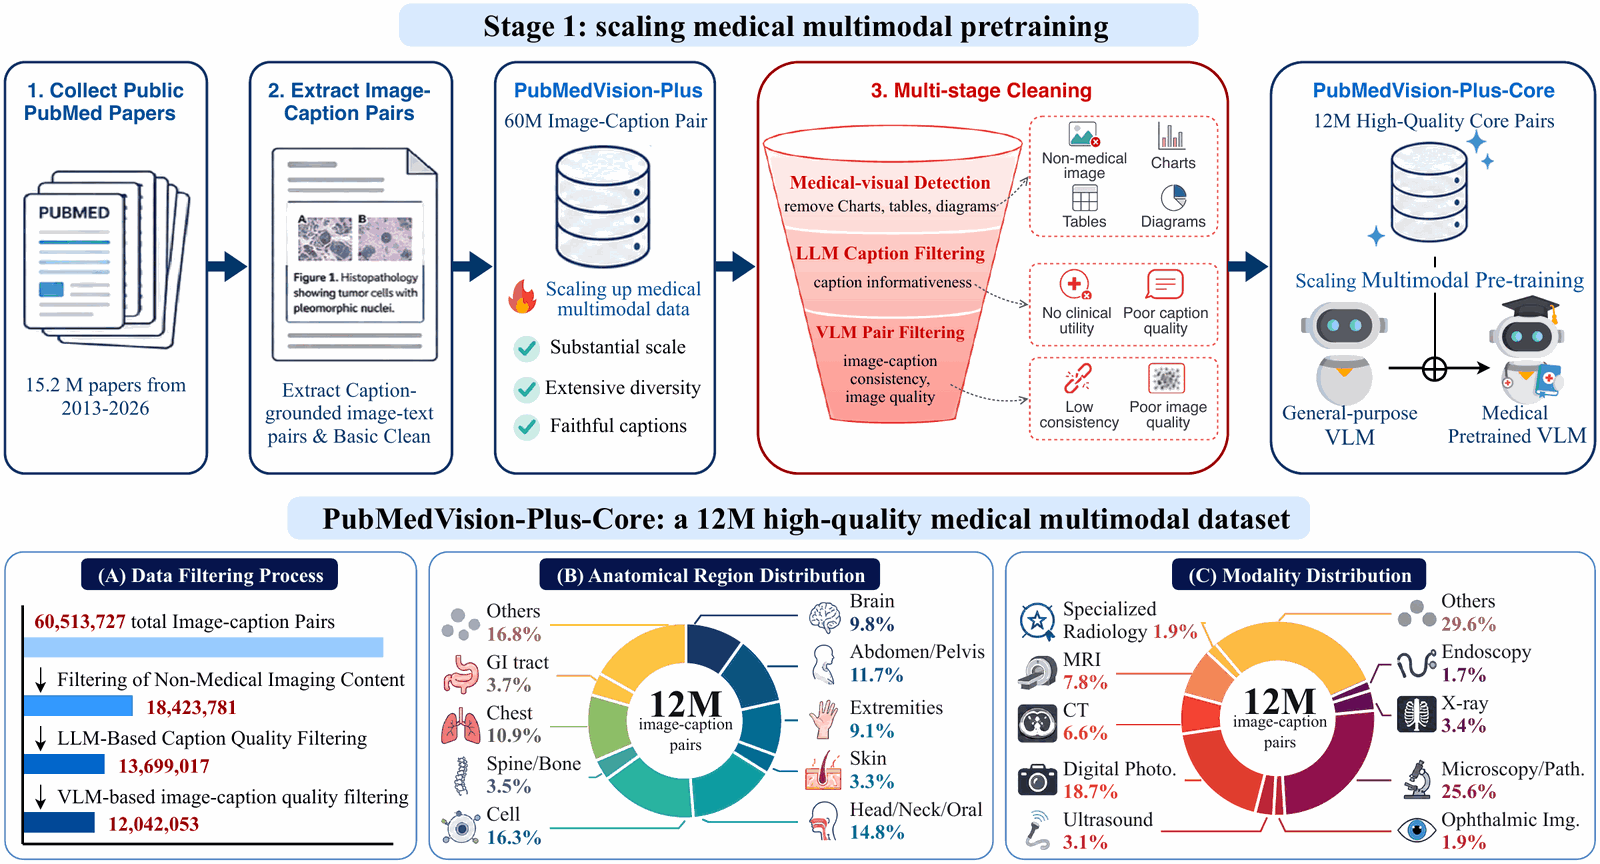 图 1:第一阶段,从 1520 万篇 PubMed 论文中抽取 6000 万对医学图文数据,经多轮清洗得到约 1200 万对高质量核心数据并用于继续预训练;下方为数据筛选过程及解剖部位、成像模态分布(图源:论文)
第二阶段:用强化学习“激励”医学视觉能力
团队以 PubMedVision-Plus 中真实的图片和专家撰写的图注为依据,合成了 7 万道强化学习训练题 PubMedVision-RL,分为两类:
- 可验证奖励:35,331 道单选题,答案有明确标签,按规则比对,答对得 1 分、答错得 0 分。这类奖励稀疏但精确,噪声低、容易判定。
- 评分细则奖励:35,154 道开放式问答,每道题配有带权重的评分细则。正向条目奖励关键发现,比如“提到胸腔积液 +5 分”;负向条目惩罚错误,比如“幻觉出气胸 −6 分”。评分模型逐条判断回答是否满足细则,奖励等于满足条目的分值之和除以全部正向分值。这类奖励更稠密,能给“部分正确”的回答部分分。
为保证质量,团队用 GPT-5.4 对每道题和每条细则做二次校验,剔除含糊不清或超出图注信息的题目;同时去掉 Qwen3-VL-8B-Instruct 已经能答对的题,让每个样本都能提供有效的训练信号。
为保持通用文本能力,训练时还混入了 1.5 万条来自 RubricHub 的通用领域细则题,共 8.5 万条强化学习数据。训练使用 GRPO(组相对策略优化)算法和 DAPO 训练配方(包括 clip-higher、token 级损失、动态采样和超长回答的奖励整形)。开放题的奖励由团队训练的多模态评分模型 HuatuoGPT-Vision-2-Grader 给出:它基于 Qwen3-VL-8B-Instruct,用 100 万条 GPT-4.1 的细则判定作为训练标签,能同时看到医学图像和回答,一次生成即可判定全部细则。这个评分模型只用于训练时计算奖励,论文报告的细则评测结果都由 GPT-4.1 打分。
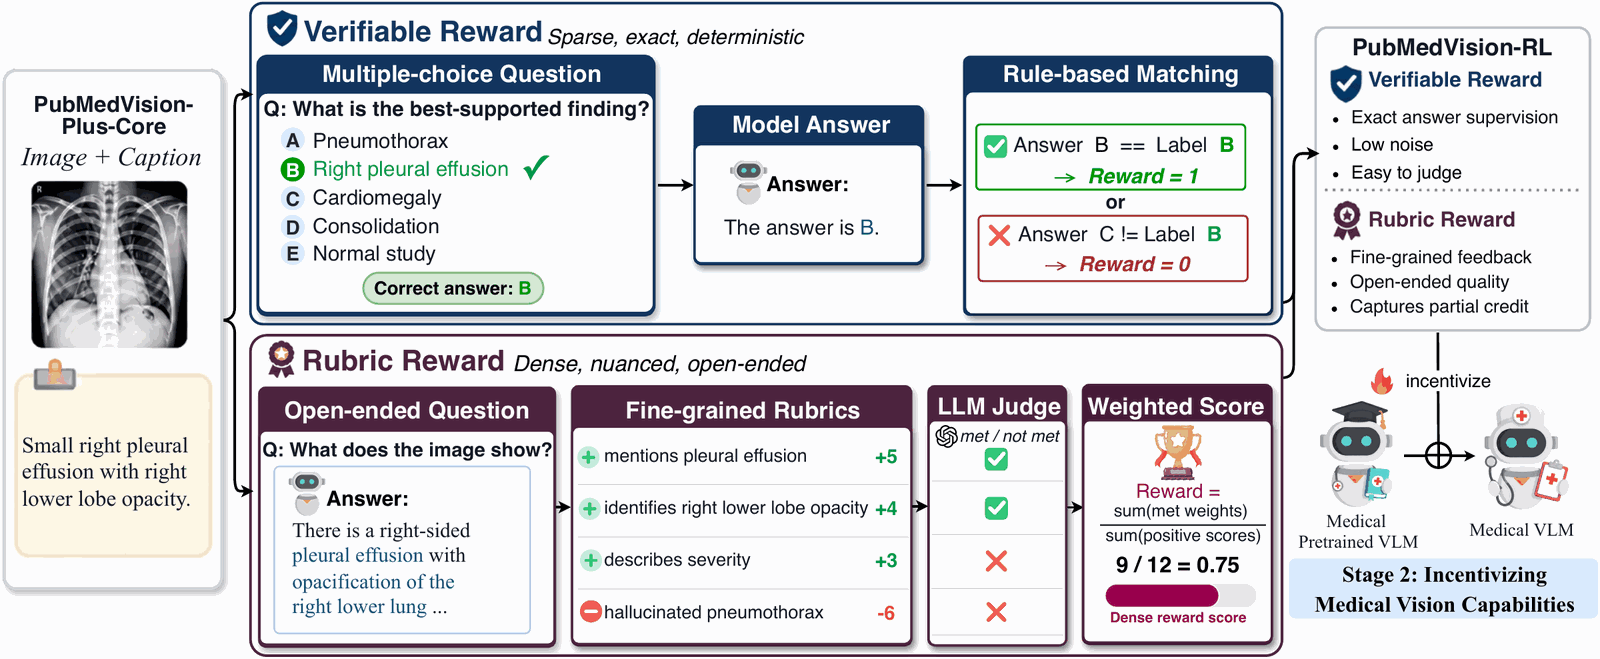 图 2:第二阶段,从核心数据合成单选题(可验证奖励)和开放题(评分细则奖励),用强化学习激励医学预训练模型调用视觉知识(图源:论文)
实验结果
八项医学基准:32B 平均 74.0,超过 GPT-5.4-mini
论文在 GMAI-MMBench、MMMU-Pro 医学子集、MedXpertQA-MM、OmniMedVQA、PMC-VQA、PathVQA、SLAKE 和 VQA-RAD 八个医学多模态基准上评测,与闭源模型、开源通用模型和医疗专用模型对比。
表 1:八项医学基准平均准确率(%),按平均分排序(节选自论文表 2)
| 模型 | 类型 | 八项平均 |
|---|---|---|
| Gemini-3-Pro | 闭源 | 81.1 |
| Gemini-3-Flash | 闭源 | 78.4 |
| GPT-5.4(High) | 闭源 | 75.0 |
| HuatuoGPT-Vision-2-32B | 本文 | 74.0 |
| GPT-5.4-mini(High) | 闭源 | 71.1 |
| HuatuoGPT-Vision-2-8B | 本文 | 68.5 |
| Gemma-4-31B-IT | 开源通用 | 67.3 |
| Lingshu-32B | 开源医疗 | 65.8 |
| Qwen3-VL-32B-Instruct | 开源通用(32B 基座) | 63.9 |
| Qwen3.5-27B | 开源通用 | 63.3 |
| GPT-4.1 | 闭源 | 63.1 |
| Qwen3-VL-8B-Instruct | 开源通用(8B 基座) | 58.6 |
| InternVL3.5-8B | 开源通用 | 57.9 |
| GPT-5.4-nano(High) | 闭源 | 57.0 |
| HuatuoGPT-Vision-7B | 开源医疗(上一代) | 53.9 |
| MedGemma-27B-IT | 开源医疗 | 50.7 |
从结果看:
- 32B 版本平均 74.0 分,明显高于同规模的开源通用模型 Gemma-4-31B-IT(67.3)和医疗模型 Lingshu-32B(65.8),也超过闭源的 GPT-5.4-mini(71.1);与 GPT-5.4(75.0)、Gemini-3-Pro(81.1)等最强闭源模型相比仍有差距。
- 8B 版本平均 68.5 分,比基座 Qwen3-VL-8B-Instruct 提高 9.9 分,超过多个参数量更大的开源模型。
- 在 OmniMedVQA 上,32B 版本得分 88.4,是所有对比模型中最高的。
- 医学训练没有以牺牲通用能力为代价:在 MMLU-Pro、IFEval、GPQA 等六项通用基准上,8B 版本的平均分略有提升,32B 版本基本持平。
消融实验:为什么是强化学习
同样的 8.5 万条训练提示,不同的训练配方效果差别很大(表 2 中的数字为八项平均分相对基座的变化):
| 训练配方 | 8B | 32B |
|---|---|---|
| 直接强化学习(不做医学预训练) | +1.9 | +4.7 |
| 医学预训练 + 监督微调 | +1.1 | −1.7 |
| 医学预训练 + 强化学习(本文) | +9.9 | +10.1 |
表 2:不同训练配方的效果(论文表 2;监督微调的答案由 Qwen3-VL-32B-Instruct 生成)
即便把监督微调的“老师”换成 GPT-5.4 或 Gemini-3-Pro,8B 模型的平均分也只有 60.8 和 60.0,远低于“预训练 + 强化学习”的 68.5。论文据此认为,在相同提示和数据量下,强化学习更能把预训练学到的医学视觉知识激发出来;而先做医学预训练、注入领域知识,是强化学习发挥作用的前提。
专家评测:细则打分与医生盲评
为了评估开放式回答,团队构建了评测集 MedMM-ExpertRubric:500 道问题、538 张图像、11,088 条评分细则,平均每题约 22 条加权细则,每条细则都经过执业医师筛选,只保留核心的读图要点。题目覆盖放射、病理、超声、内镜等领域,其中 32 道为多图题,且都没有用于模型训练。在这个评测集上,8B 版本得分从基座的 22.1 提高到 35.7,32B 版本从 30.9 提高到 40.8。
团队还请两位主治医师对 100 道开放题做两两盲评:两个模型的回答匿名、随机排列,医生选出更好的一个或判为平局。HuatuoGPT-Vision-2-32B 的结果如下:
| 对比模型 | 胜 / 平 / 负(%) | 结论 |
|---|---|---|
| GPT-5.4(High) | 33 / 19 / 48 | 略逊 |
| GPT-5.4-mini(High) | 41 / 21 / 38 | 相当 |
| Qwen3-VL-32B-Instruct | 55 / 18 / 27 | 明显占优 |
| Lingshu-32B | 65 / 14 / 21 | 明显占优 |
| GPT-5.4-nano(High) | 68 / 16 / 16 | 明显占优 |
表 3:医生两两盲评结果(论文表 13)
论文指出,医生的偏好与 MedMM-ExpertRubric 的排名一致,说明这个评测集可以作为专家评测的低成本替代。
评分模型是否可靠
强化学习中,开放题的奖励来自评分模型,它的判断是否可靠直接影响训练效果。在留出数据上,8B 评分模型与 GPT-4.1 的判定一致率为 91.5%。团队又抽取 300 条细则判定,与医生的标注对照:8B 评分模型的一致率为 88.7%,GPT-4.1 为 90.3%。
开源资源
截至 2026 年 11 月 16 日,项目已在 GitHub 和 Hugging Face 公开以下资源:
| 资源 | 内容 | 状态 |
|---|---|---|
| PubMedVision-Plus | 约 1200 万对高质量医学图文数据(Core) | 已开源 |
| PubMedVision-RL | 7 万道强化学习训练题(单选题 + 开放题) | 已开源 |
| MedMM-ExpertRubric | 500 道开放式医学视觉问答评测题,附医师校验的评分细则 | 已开源 |
| HuatuoGPT-Vision-2-Grader | 多模态评分模型 | 已开源 |
| 训练代码 | 预训练与强化学习两阶段代码,支持 Qwen3-VL 与 Qwen3.8 系列 | 已开源 |
| HuatuoGPT-Vision-2-8B / 32B | 医疗视觉语言模型 | 即将发布 |
需要说明的是,按照项目说明,HuatuoGPT-Vision-2 仅用于学术研究,不能用于诊断、治疗、分诊等医疗决策。
意义与展望
这项工作给医疗多模态模型提供了一条可复用的路线:用公开医学文献把预训练规模做上去,再从同一批数据中合成可验证题和细则题,用强化学习把预训练知识“激励”出来。论文作者希望,这些数据、模型和发现能加速医疗视觉语言模型的开放研究。下一步,HuatuoGPT-Vision-2 的 8B 与 32B 模型权重将陆续发布。
对自由动脉而言,HuatuoGPT 系列在数据建设、模型训练和专业评测上的方法积累,是 DentalGPT 与口腔场景应用的方法基础。值得一提的是,PubMedVision-Plus 核心数据中,头颈及口腔部位的图像占比达到 14.8%。
团队介绍
论文第一作者为 Junying Chen。自由动脉团队成员蔡镇阳、冯相义、王本友参与了这项研究。
蔡镇阳|自由动脉 CTO,论文第二作者
香港中文大学(深圳)博士研究生,在自由动脉负责多模态医疗模型研发。他参与了 HuatuoGPT-o1、DentalGPT 等模型的研发,并以第一作者身份在 NeurIPS、ACL 发表论文。
冯相义|自由动脉医疗产品副总裁,论文作者
外科主治医师,拥有 4000 余台手术经验,在自由动脉负责临床需求与产品落地。他参与医疗模型的数据建设与应用优化,兼具 AI 产品设计与项目管理经验,临床一线经验与 AI 产品经验兼备。
王本友|自由动脉首席 AI 科学家,论文通讯作者
香港中文大学(深圳)数据科学学院助理教授、博士生导师。