NeurIPS 2026|自由动脉 CTO 蔡镇阳合著:卷积病理基础模型只训 700 万参数,细胞分割超越 ViT 病理大模型
在计算病理中,细胞核分割、炎症细胞检测、组织微环境分析都离不开“细胞级密集预测”,也就是对图像做逐像素的精细判断。难点在于:病理结构往往很小、形态多样、边界模糊,染色、扫描仪、组织类型和机构之间的差异又很大,而逐像素的密集标注成本高昂。
当下的病理基础模型大多基于 ViT(Vision Transformer,视觉 Transformer)。ViT 先把图像切成固定大小的图块(patch)再编码,用于识别组织类别等高层任务很有效,却可能打断连续的组织结构,丢失图块内部的形态、纹理和边界细节,而这些恰恰是细胞级预测最需要的信息。
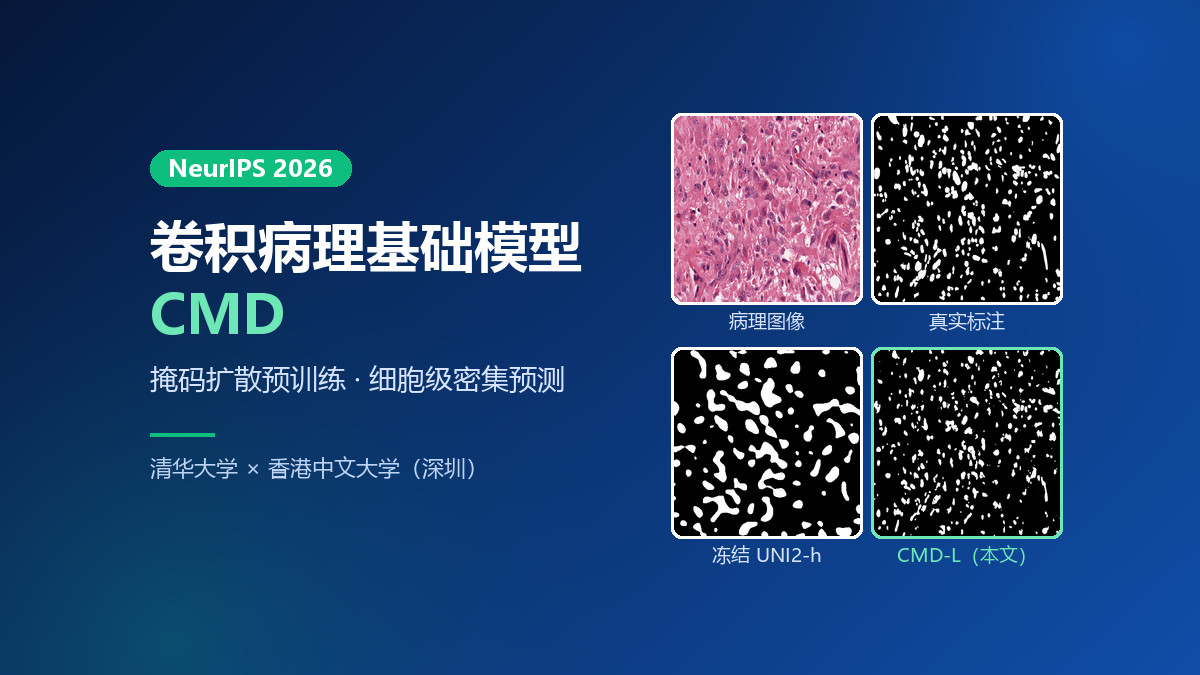
针对这一问题,来自清华大学深圳国际研究生院、香港中文大学(深圳)等机构的研究者提出 CMD(ConvNeXt Masked-Diffusion,ConvNeXt 掩码扩散):用全卷积网络做骨干,在像素空间做掩码扩散预训练,并把冻结的病理基础模型特征作为条件注入。冻结骨干、只训练一个轻量分割头,CMD 的细胞级分割表现就整体超过了主流 ViT 病理基础模型,在标注稀缺时优势尤其明显。论文已被 NeurIPS 2026 接收,将于 12 月 10 日在悉尼会场的海报环节展示。自由动脉 CTO 蔡镇阳为论文第三作者,自由动脉首席 AI 科学家王本友为论文共同通讯作者。
论文标题:Beyond ViT Tokens: Masked-Diffusion Pretrained Convolutional Pathology Foundation Model for Cell-Level Dense Prediction
会议:NeurIPS 2026(Poster)
论文链接:https://openreview.net/forum?id=u0riwBjIls
arXiv:https://arxiv.org/abs/2605.08276
代码:https://github.com/M4A1TasteGood/ConvNeXt-Masked-Diffusion
模型权重:https://huggingface.co/M4A1TasteGood/ConvNeXt_Masked_Diffusion
作者:Weiming Chen*、Xitong Ling*、Zhenyang Cai(蔡镇阳)、Xidong Wang、Jiawen Li、Tian Guan、Benyou Wang(王本友)†、Yonghong He†(* 共同第一作者,† 通讯作者)
作者单位:清华大学深圳国际研究生院、香港中文大学(深圳)、清华珠三角研究院
背景:ViT 的“切块”难题
现有病理基础模型,如 UNI/UNI2、Virchow/Virchow2、Prov-GigaPath、Phikon 等,大多以 ViT 为骨干,通过 DINOv2、iBOT 或掩码图像建模等自监督目标在病理图像上预训练;CONCH、MUSK 等则进一步引入图文对齐。它们擅长图像级、切片级的全局语义,但图块化的输入难以保留细粒度的局部连续性。
卷积网络天然具有局部性和空间连续性的归纳偏置,更契合细粒度的病理表征学习,问题在于它一直缺少像掩码图像建模之于 ViT 那样可扩展的预训练范式。受生成模型的启发,作者提出:生成式建模能否成为卷积病理基础模型的自监督预训练方案?
方法:把扩散模型当作表征学习器
CMD 的思路可以概括为“生成式预训练,冻结后复用”。预训练时,模型接收被部分遮挡的病理图块,通过扩散去噪目标还原原图,在没有任何密集标注的情况下学习细胞形态、纹理连续性和细胞边界。预训练完成后,扩散采样过程被丢弃,网络作为冻结的密集特征提取器:从解码器中间层取出多尺度特征,下游每个任务只训练一个轻量的预测头。
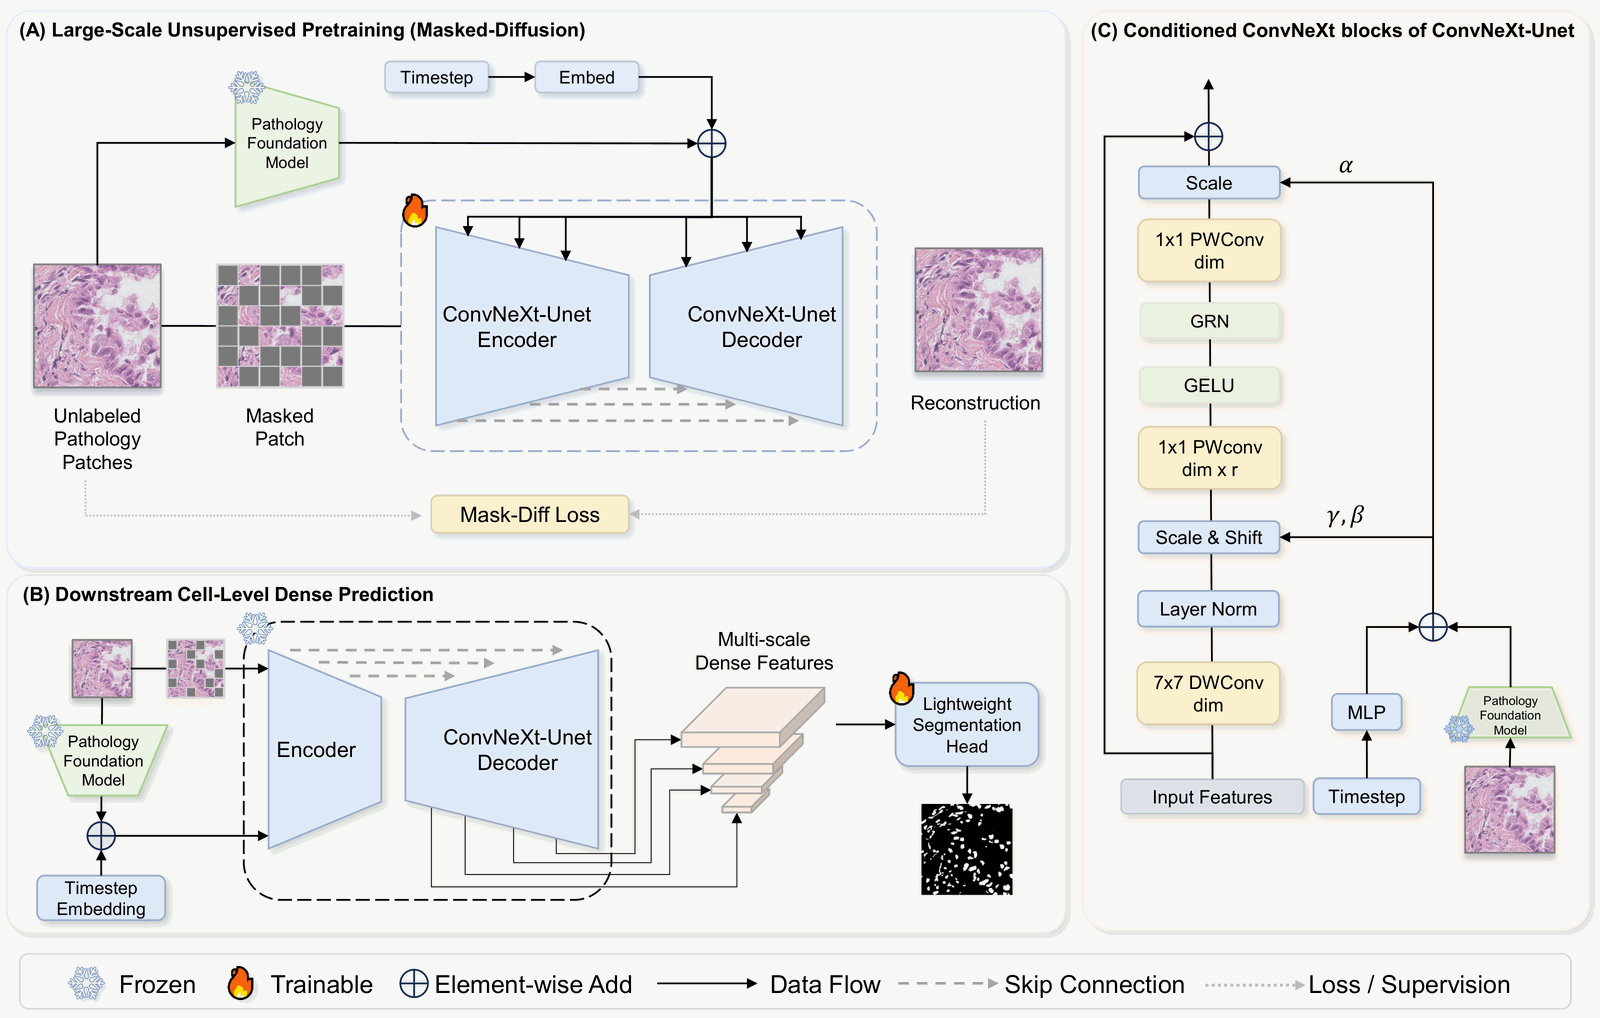 图 1:CMD 框架。(A)在大规模无标注病理图块上做掩码扩散预训练,时间步嵌入与病理基础模型特征共同调制 ConvNeXt-UNet;(B)预训练后骨干冻结,抽取多尺度解码器特征接轻量分割头;(C)条件化 ConvNeXt 模块通过自适应归一化(adaLN)注入融合特征(图源:论文)
围绕这个框架,论文逐一回答了四个设计问题。以下消融实验均在 5.5 万张无标注病理图上预训练,并用线性探针评估冻结特征:
- 为什么选 ConvNeXt-UNet 做骨干? 在相同扩散设置下对比 DiT、Attention U-Net 和 ConvNeXt-UNet,ConvNeXt-UNet 学到的表征对边界更敏感。例如在 CPM-15 上,衡量边界吻合度的 BF1 达到 33.66,DiT 和 Attention U-Net 分别只有 19.65 和 19.31。
- 为什么用掩码扩散而不是标准 DDPM? 作者借鉴掩码扩散的思路,把扩散时间步从“控制高斯噪声强度”改为“控制结构遮挡比例”,让模型从可见区域恢复被遮住的组织结构,从而学到贴合形态的表征。
- 像素空间还是 VAE 隐空间? VAE 压缩虽然高效,却可能丢掉细胞核边界、染色质纹理、细胞间小间隙等高频细节。实验中,像素空间预训练明显更好,例如 CPM-17 的 Dice 从 VAE 隐空间的 55.20 提升到 76.74。
- 要不要引入病理基础模型作为条件? 以冻结的 UNI 特征作为语义引导后,CPM-15 的 Dice 从 55.17 提升到 63.25。作者认为,基础模型特征提供的是互补的语义先验,密集表征仍由掩码扩散骨干学习。
正式实验中,CMD 在约 105 万张 512×512 的无标注病理图块(来自公开的 HistAI 数据集合)上预训练 8 万步,条件编码器换成冻结的 H0-mini。CMD-L 版本的冻结骨干约 6 亿参数(602M),下游输入统一为 256×256。
实验结果
以下数据来自论文 arXiv 版本。Dice 越高,表示分割结果与真实标注越吻合。
冻结骨干,对比 16 个 ViT 病理基础模型
在 CPM-15、CPM-17、TNBC 三个细胞级分割数据集上,作者把 CMD-L 与 16 个冻结的 ViT 病理基础模型,以及 nnUNet、TransUNet、ViT-Adapter 三个端到端分割模型做了对比。
表 1:细胞级分割 Dice 对比(节选自论文表 4;ViT 病理基础模型选取 4 个代表,含各数据集上 Dice 最高者;CMD-L 输入为 256×256,其余模型为 384–512)
| 方法 | 类型 | 可训练参数 | CPM-15 | CPM-17 | TNBC |
|---|---|---|---|---|---|
| Hibou | 冻结 ViT 病理基础模型 | 7.06M | 0.794 | 0.875 | 0.841 |
| H-Optimus-0 | 冻结 ViT 病理基础模型 | 9.42M | 0.781 | 0.881 | 0.843 |
| Kaiko | 冻结 ViT 病理基础模型 | 7.06M | 0.758 | 0.882 | 0.838 |
| UNI2-h | 冻结 ViT 病理基础模型 | 9.42M | 0.767 | 0.873 | 0.833 |
| nnUNet | 端到端分割 | 12.19M | 0.791 | 0.875 | 0.803 |
| TransUNet | 端到端分割 | 105.28M | 0.809 | 0.897 | 0.843 |
| ViT-Adapter | 端到端分割 | 133.52M | 0.876 | 0.872 | 0.854 |
| CMD-L + 轻量分割头 | 冻结卷积骨干 | 7.15M | 0.864 | 0.865 | 0.854 |
| CMD-L + 增强分割头 | 冻结卷积骨干 | 21.21M | 0.889 | 0.880 | 0.854 |
从结果看:
- 同样只训练分割头,CMD-L 在多数指标上胜过 16 个 ViT 病理基础模型。 搭配 7.15M 参数的轻量分割头时,CMD-L 在 CPM-15 和 TNBC 上的 Dice 与 Precision(精确率)都高于全部 16 个冻结 ViT 病理基础模型,CPM-15 的 Dice 比其中最好的 Hibou 高出约 0.07(0.864 对 0.794)。在 CPM-17 上,轻量分割头版本的 Precision 为全表最高(0.901),但 Dice(0.865)低于多个 ViT 模型;换用增强分割头后 Dice 为 0.880,与最好的 Kaiko(0.882)基本持平。
- 与端到端分割网络相比也有竞争力。 换上 21.21M 参数的增强分割头后,CMD-L 在 CPM-15 上取得全表最高的 Dice(0.889),超过需要训练 133.52M 参数的 ViT-Adapter(0.876);在 TNBC 上与 ViT-Adapter 持平;在 CPM-17 上则低于 TransUNet(0.897)。
- 对输入分辨率依赖更小。 CMD 统一使用 256×256 输入,而 ViT 类模型和端到端模型需要 384–512 的数据集专属分辨率。作者认为,这说明卷积掩码扩散表征能更高效地捕捉局部形态。
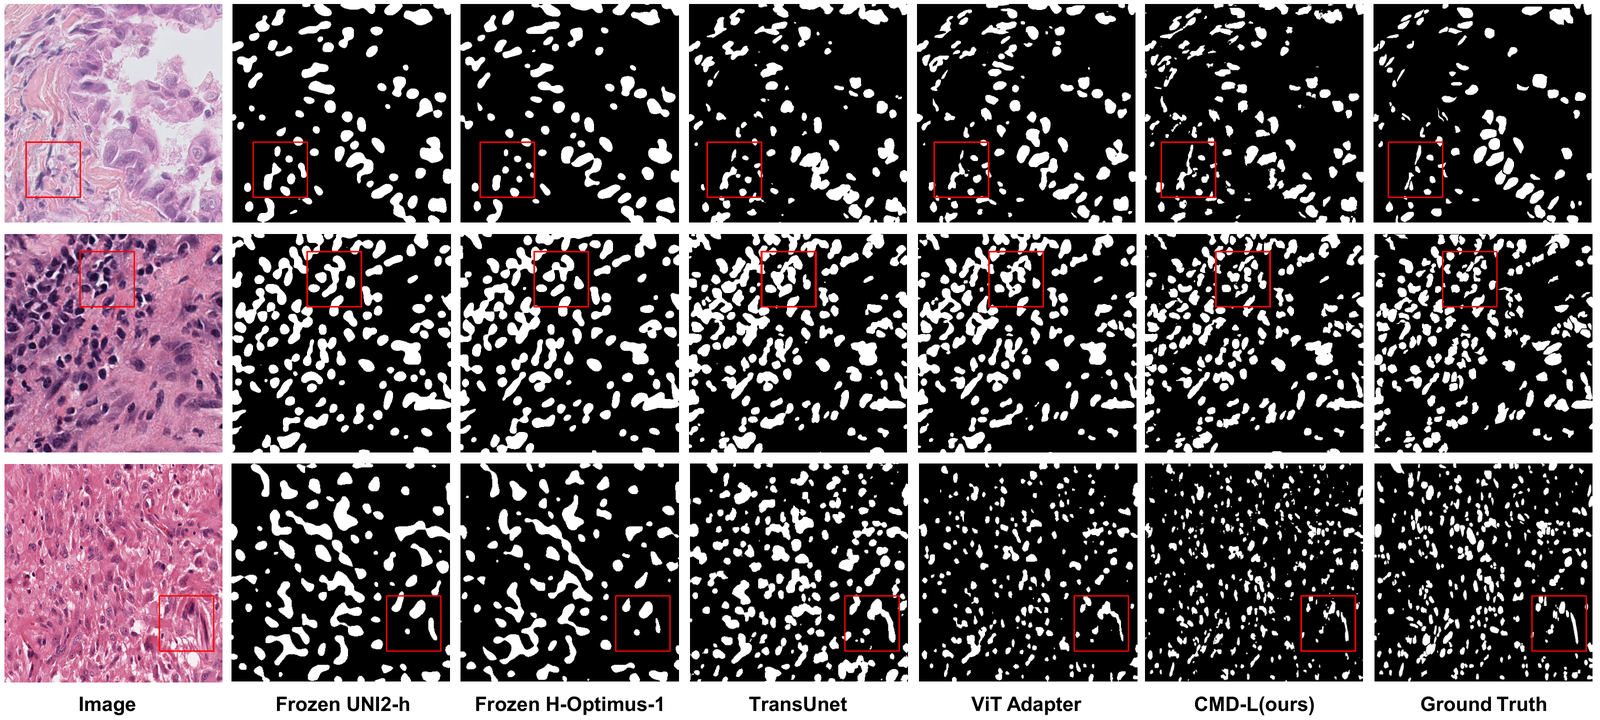 图 2:冻结骨干设置下的分割效果对比,从上到下依次为 TNBC、CPM-17、CPM-15 数据集;红框标出细胞拥挤或边界模糊的区域,CMD-L 的细胞掩码更完整、边界更一致(图源:论文)
少样本:只有 1 张标注图时优势最大
在 CPM-17 和 TNBC 的 1-shot、5-shot、10-shot 设置中,CMD-L 骨干保持冻结,只训练约 7M 参数的分割头;作为对照,ViT-Adapter 需要端到端训练 364M 参数。
表 2:少样本分割 Dice(论文表 5;TransUNet 使用冻结的 UNI2-h 特征)
| 设置 | 冻结 UNI2-h | 冻结 H-Optimus-1 | TransUNet | ViT-Adapter | 冻结 CMD-L |
|---|---|---|---|---|---|
| 可训练 / 总参数 | 9M / 690M | 8M / 1144M | 23M / 704M | 364M / 364M | 7M / 609M |
| CPM-17 · 1-shot | 0.463 | 0.468 | 0.479 | 0.714 | 0.769 |
| CPM-17 · 5-shot | 0.468 | 0.467 | 0.477 | 0.812 | 0.811 |
| CPM-17 · 10-shot | 0.464 | 0.472 | 0.476 | 0.819 | 0.820 |
| TNBC · 1-shot | 0.497 | 0.486 | 0.478 | 0.498 | 0.714 |
| TNBC · 5-shot | 0.493 | 0.490 | 0.477 | 0.800 | 0.792 |
| TNBC · 10-shot | 0.497 | 0.492 | 0.476 | 0.828 | 0.819 |
只有 1 张标注图时,CMD-L 在 CPM-17 和 TNBC 上的 Dice 分别达到 0.769 和 0.714,ViT-Adapter 为 0.714 和 0.498,两个冻结的 ViT 病理基础模型都在 0.5 以下。标注增加到 5 张、10 张后,ViT-Adapter 逐渐追上,两者 Dice 互有高低,但 CMD-L 的 Precision 在所有少样本设置中都更高(例如 CPM-17 10-shot 为 0.896 对 0.832),而可训练参数只有 ViT-Adapter 的约五十分之一。
规模扩展与可视化
更大的骨干带来更好的表现:在 7 万步预训练、用全量训练集训练分割头的设置下,从 CMD-B(217M 参数)换成 CMD-L(602M),CPM-15、CPM-17、TNBC 的 Dice 分别从 0.852、0.829、0.836 提升到 0.865、0.863、0.850。更长的预训练总体也有帮助,例如 TNBC 的 Dice 从 1 万步时的 0.820 逐步升至 8 万步时的 0.854。作者也指出,这还不是完整的规模定律(scaling law)分析。
可视化进一步说明了差异:对 ViT 病理基础模型,作者在细胞核上选一个锚点图块,计算它与其余图块的余弦相似度,激活往往铺满大片组织区域;CMD 不使用图块 token,作者直接对其密集卷积特征做 K-means 聚类(K=4),得到的聚类更贴合单个细胞核和精细边界。
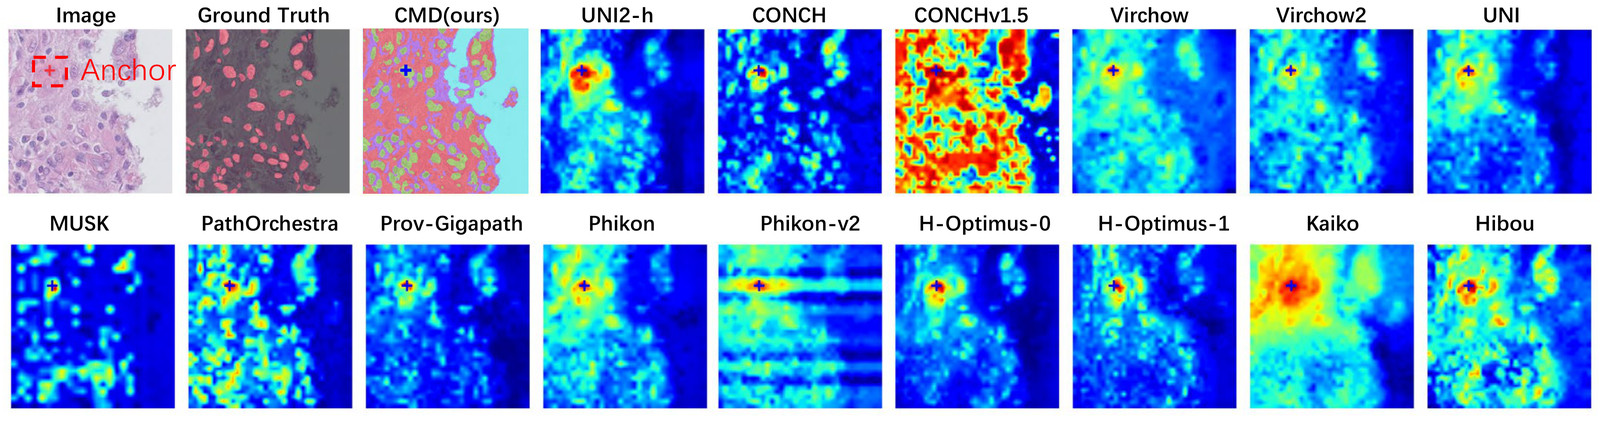 图 3:密集表征可视化,ViT 类病理基础模型显示锚点图块与其余图块的余弦相似度,CMD 显示密集卷积特征的 K-means 聚类结果(图源:论文)
意义与展望
这项研究表明,在 ViT 主导的病理基础模型格局中,全卷积骨干配合掩码扩散预训练,同样可以成为有竞争力的细胞级密集预测基础模型,并更好地保留组织学结构先验。“一次预训练、冻结复用、少量标注适配”的模式,在标注和可训练参数上都更节省,适合密集标注昂贵的病理任务。
作者表示,下一步将探索更大规模的数据与骨干、多模态或病理报告引导的条件机制,以及把细胞级预测与切片级诊断、肿瘤微环境分析联系起来的全切片(WSI)工作流。目前,CMD 的代码以及 CMD-L 预训练权重、TNBC 分割头已在 GitHub 和 Hugging Face 公开。
团队介绍
论文共同第一作者为 Weiming Chen 与 Xitong Ling(清华大学深圳国际研究生院),通讯作者为王本友(香港中文大学(深圳))与 Yonghong He(清华大学深圳国际研究生院、清华珠三角研究院)。自由动脉团队成员蔡镇阳、王本友参与了这项研究。
蔡镇阳|自由动脉 CTO,论文第三作者
香港中文大学(深圳)博士研究生,在自由动脉负责多模态医疗模型研发。他参与了 HuatuoGPT-o1、DentalGPT 等模型的研发,并以第一作者身份在 NeurIPS、ACL 发表论文。本文中,他以香港中文大学(深圳)为署名单位。
王本友|自由动脉首席 AI 科学家,论文共同通讯作者
香港中文大学(深圳)数据科学学院助理教授、博士生导师。