ACL 2026|自由动脉联合港中深、武汉大学推出 EasyMED:AI 标准化病人教学效果与真人相当,单次练习成本约为 1/73
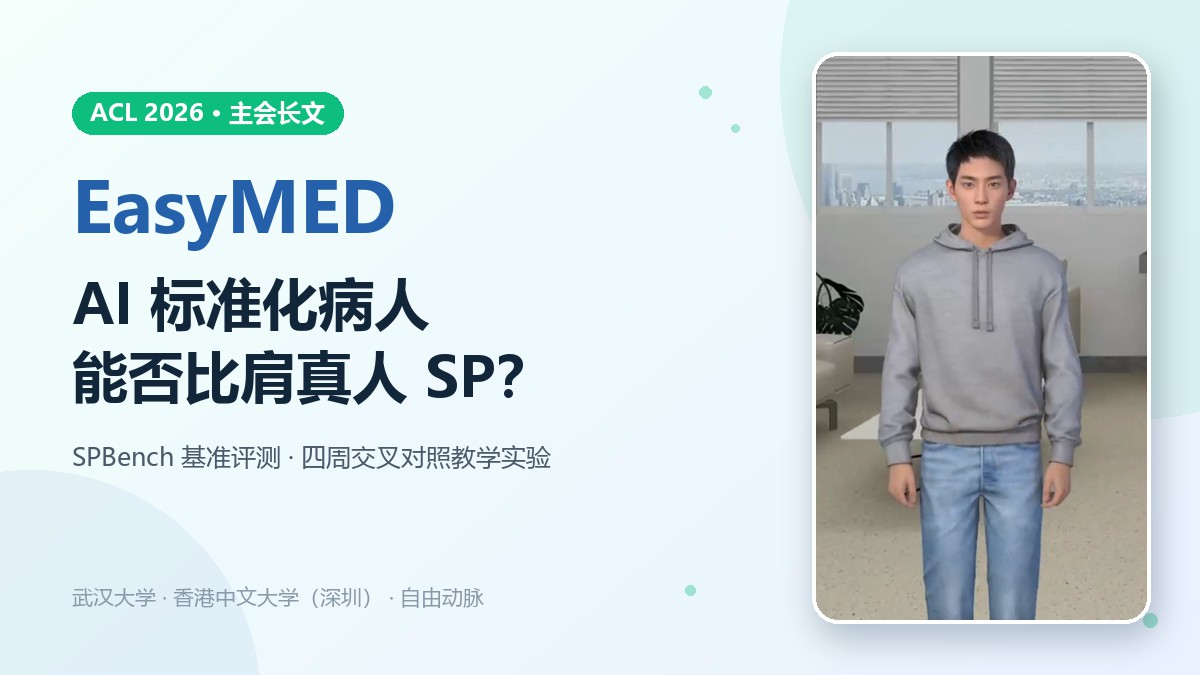
医学生第一次面对“病人”,往往不在病房,而在模拟诊室:对面坐着的是经过专门培训、能稳定扮演某个病例的真人演员,也就是标准化病人(Standardized Patient,SP)。SP 被视为问诊、沟通和临床推理教学的“金标准”,在客观结构化临床考试(OSCE)中尤其重要。但真人 SP 要招募、培训、排班,成本高、难扩展,学生能练的次数十分有限。
让大语言模型(LLM)来扮演病人,看上去顺理成章。可现有的虚拟病人常常“太热情”:学生还没问到,关键病史就和盘托出;聊得久了,前后说法对不上;练完之后,也说不清学生漏问了什么。更关键的是,AI 病人能否达到真人 SP 的训练效果,一直缺少同等条件下的严格对比。
针对这些问题,武汉大学人工智能学院、香港中文大学(深圳)与自由动脉(Freedom AI)的研究者提出多智能体虚拟标准化病人框架 EasyMED 和评测基准 SPBench,并与真人 SP 开展了为期四周的对照教学实验。论文已被第 64 届国际计算语言学协会年会 ACL 2026 主会(长文)收录。自由动脉全职员工周磊是论文第四作者,在项目中负责部分系统的开发、用户对接和上线部署;自由动脉实习生张兵权是共同第一作者。
论文标题:Human or LLM as Standardized Patients? A Comparative Study in Medical Education
论文链接:https://aclanthology.org/2026.acl-long.1243/
arXiv:https://arxiv.org/abs/2511.14783
代码 / 数据:https://github.com/FreedomIntelligence/EasyMED
作者:Bingquan Zhang(张兵权)*、Xiaoxiao Liu*、Yuchi Wang、Lei Zhou(周磊)、Qianqian Xie†、Benyou Wang(王本友)†(* 共同第一作者,† 通讯作者)
作者单位:武汉大学人工智能学院、香港中文大学(深圳)、自由动脉(Freedom AI)
背景:真人 SP 难扩展,AI 病人“不够像”
论文梳理了虚拟标准化病人(VSP)真正用于教学需要满足的三条要求:
- 病人保真度(Patient Fidelity):行为和回答方式要与真人 SP 可比;
- 交互一致性(Interaction Coherence):多轮对话中病情设定保持一致,信息“问到才说”;
- 教学感知(Pedagogical Awareness):了解学生的学习目标和问诊过程,能给出细粒度的教学反馈。
对照这三条,论文比较了 SimPatient、EvoPatient、CureFun、Adaptive-VP、MedSimAI 等已有系统:它们大多由同一个模型“端到端”地理解提问并生成回答,容易过早透露信息、前后矛盾;评估也多依赖访谈和问卷,缺少与真人 SP 的定量对比和长期对照。
方法:把“听懂问题”和“怎么回答”拆开
EasyMED 把一次模拟问诊交给分工明确的几个智能体(Agent),分为“问诊”和“评估”两个阶段。
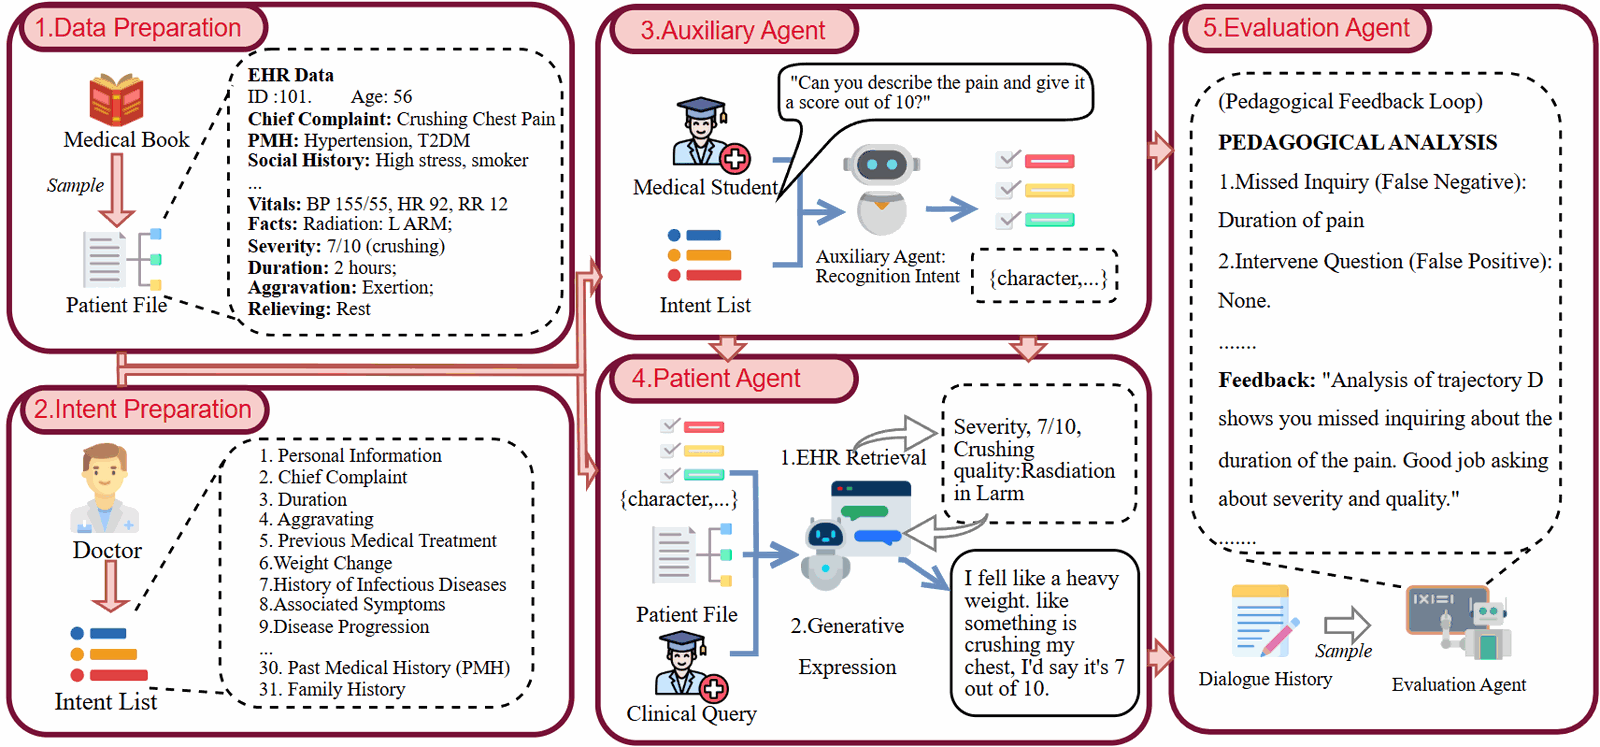 图 1:EasyMED 的多智能体框架:问诊阶段由辅助智能体(意图识别)与病人智能体协作,结束后由评估智能体给出教学反馈(图源:论文)
辅助智能体(Auxiliary Agent):先听懂学生在问什么。 学生每提一个问题,它先把问题归入预先定义的临床问诊意图,比如“主诉”“起病时间”,而不纠结具体措辞。论文整理了 7 大类、31 项问诊意图。为挑选意图识别模型,团队构建了包含 4,631 个临床问题的测试集,Gemini 2.5 Flash 以 96.3% 的准确率和 95.0% 的宏平均 F1 在六个候选模型中表现最好,被选为 EasyMED 的意图识别模型。
病人智能体(Patient Agent):再决定说什么、怎么说。 拿到意图后,它先从结构化病历中取出对应的那条事实,再结合预设的性格设定(如焦虑、犹豫)用口语作答。“说什么”和“怎么说”分开处理,既能做到问到才说、不提前“剧透”,又保留自然的对话感。
评估智能体(Evaluation Agent):练完再复盘。 它不打断问诊,而是在结束后回看完整对话,把识别出的意图和问到的信息与专家制定的病例清单逐项比对,指出漏问和多余的提问,生成结构化反馈。在两位临床专家对 60 次练习反馈的盲评中,87% 的反馈被两位专家都评为恰当(5 分制中 4 分及以上),专家间一致性系数 Cohen's κ 为 0.76。
实验中,病人智能体和评估智能体以 Gemini 2.5 Pro 为基座,辅助智能体使用 Gemini 2.5 Flash。教学实验所用系统另有体格检查、辅助检查、诊断和评估等界面。
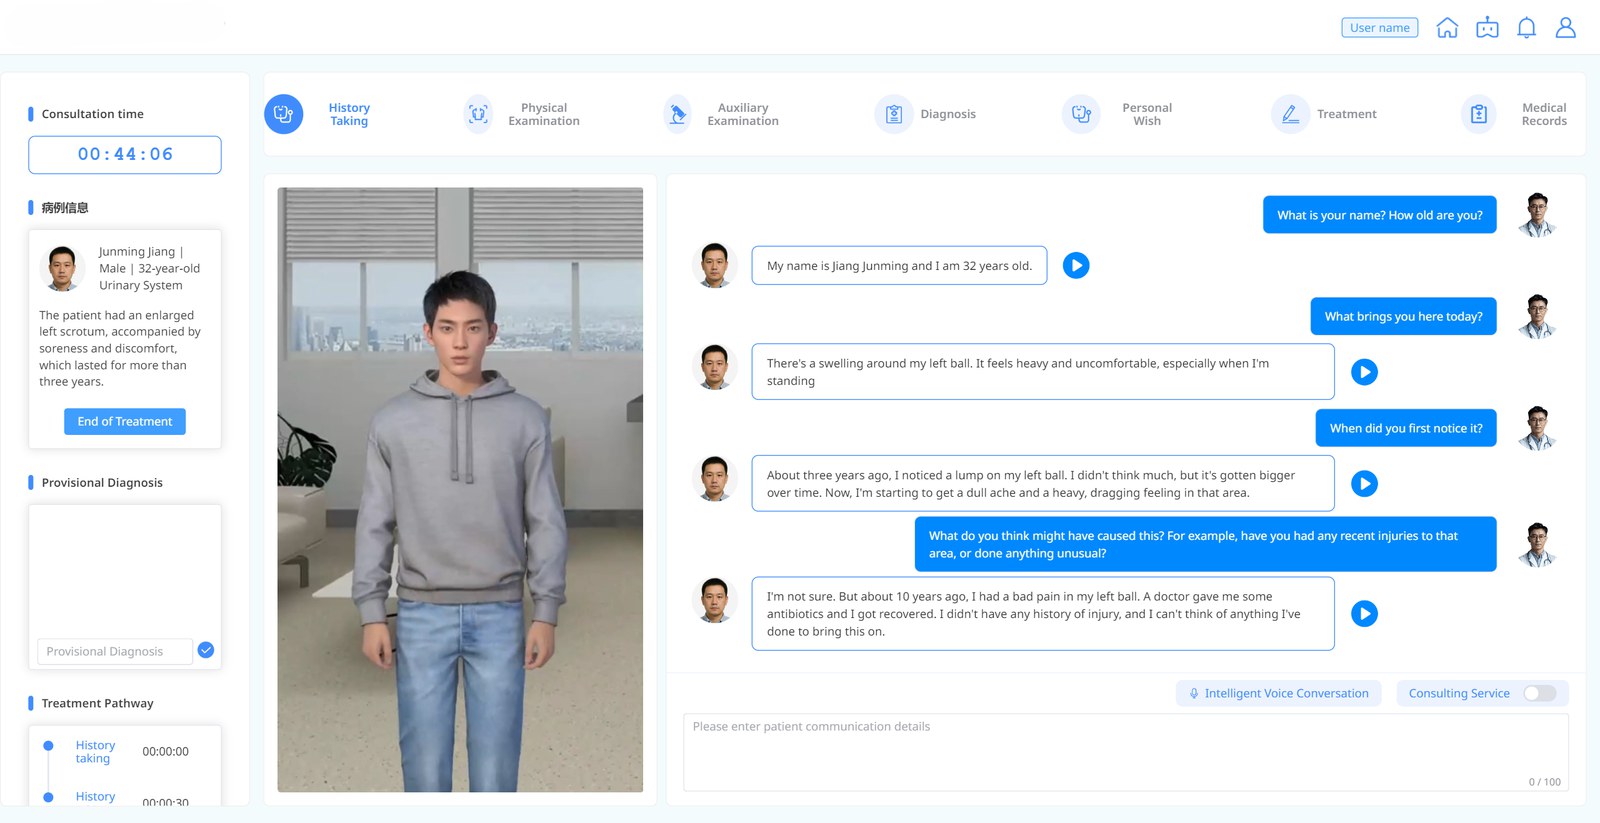 图 2:EasyMED 的问诊界面,左侧为病例信息与控制面板,中间为 3D 虚拟病人形象,右侧为对话区(图源:论文附录)
SPBench:以真人 SP 的对话为参照
要判断 AI 病人像不像真人,先得有一把以真人为参照的尺子。SPBench 基于两本常用的标准化病人培训教材构建,收集了 3,208 组真实医患问诊中的问答,整理成 58 个病例,覆盖 14 个医学专科。每个病例包含病人档案和真人 SP 的逐轮对话记录,并经两位临床专家审核。
评测时,真人医生在每个病例中提出的问题序列被原样输入给所有系统,保证各个虚拟病人面对完全相同的提问。打分维度共 8 个,由研究者与三位临床专家共同制定:问题理解(QC)、病例一致性(CC)、受控披露(CD)、回答完整性(RC)、逻辑连贯性(LC)、语言自然度(LN)、对话一致性(CS)和病人举止(PD)。每个维度按 5 分制评分后换算为百分制,由 GPT-4o 担任自动评审;在随机抽取的 86 个样本上,自动评分与两位临床专家盲评结果的 Pearson 相关系数为 0.81。
实验一:在 SPBench 上,EasyMED 最接近真人
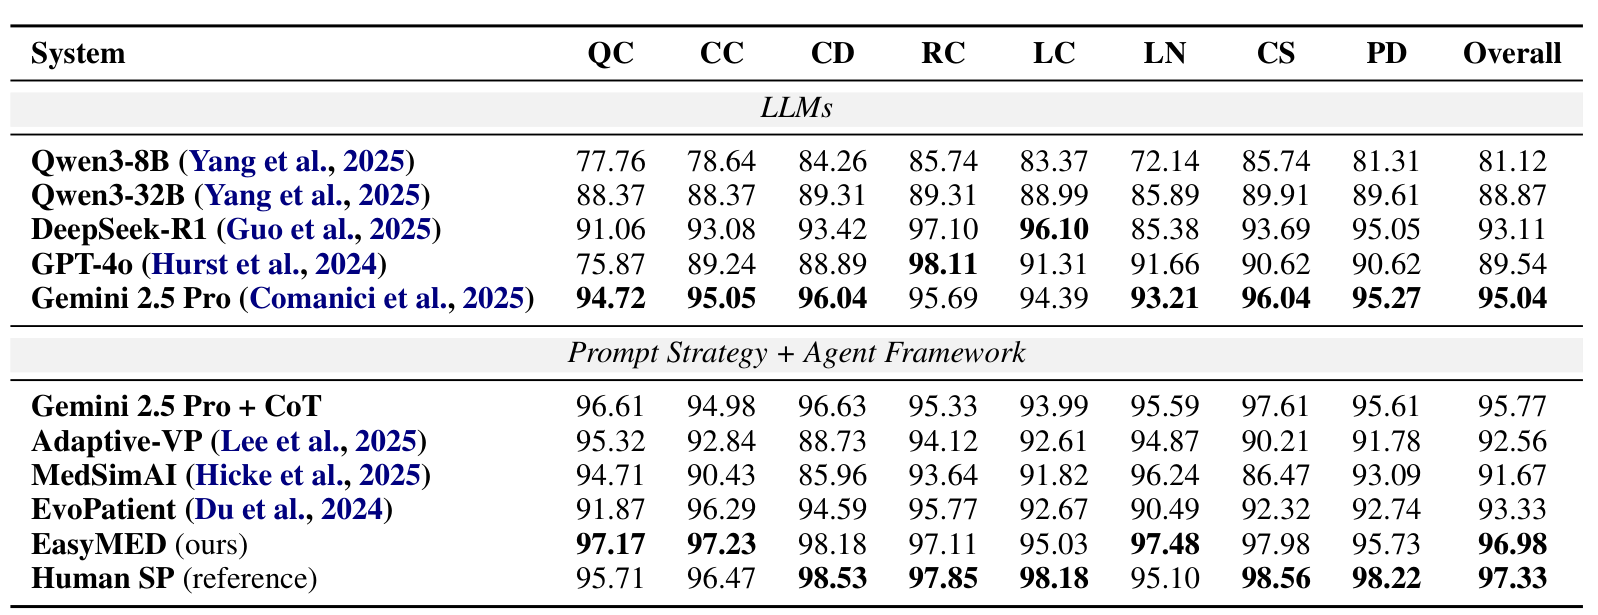 图 3:SPBench 分维度与总分结果,最后一行为真人标准化病人的参考值(图源:论文表 3,ACL 2026 正式版)
真人 SP 的总分为 97.33,EasyMED 以 96.98 紧随其后,在所有基于大模型的系统中最高。同样面向虚拟病人设计的 EvoPatient、Adaptive-VP 和 MedSimAI 分别为 93.33、92.56 和 91.67;直接使用通用大模型时,表现最好的 Gemini 2.5 Pro 为 95.04,加上思维链(CoT)提示后为 95.77。
分维度看,EasyMED 的受控披露得分为 98.18,与真人 SP 的 98.53 十分接近;在问题理解、病例一致性和语言自然度三项上,EasyMED 的得分还略高于真人 SP 参考值。论文同时观察到,Adaptive-VP 的受控披露偏低(88.73),MedSimAI 语言自然(96.24)但对话一致性偏弱(86.47)。作者认为,提示词主要影响的是“怎么说”,稳定的病人行为更依赖架构层面的信息控制。
实验二:四周对照教学,学习效果与真人 SP 相当
SPBench 衡量的是“像不像”,教学最终要看“有没有用”。研究团队在香港中文大学(深圳)招募了 20 名四、五年级医学本科生,分组前按预设标准排除 6 人(4 人因时间冲突无法参加线下训练,2 人前测成绩过高),最终 14 人(男女各 7 人)进入实验。
实验采用交叉设计:A 组前两周用 EasyMED、后两周换成真人 SP,B 组顺序相反,三位有经验的专业人员担任真人 SP。学生在前测、中测、后测各参加一次 OSCE,三次考试使用难度一致的不同病例,由两位不知道分组情况的考官独立评分。
| 组别(训练顺序) | 前测 | 中测 | 后测 | 四周总提升 |
|---|---|---|---|---|
| A 组(EasyMED → 真人 SP) | 70.56 | 86.07 | 87.44 | +16.89 |
| B 组(真人 SP → EasyMED) | 69.84 | 82.01 | 85.20 | +15.36 |
两组起点没有显著差异(t(12) = 0.16,p = 0.88)。四周后,A 组平均提升 16.89 分,B 组提升 15.36 分(上表数据来自论文表 5,每组 7 人),论文据此认为 EasyMED 对临床技能习得的支持与真人 SP 训练相当。提升主要发生在前两周:第一阶段用 EasyMED 的 A 组提高 15.51 分,用真人 SP 的 B 组提高 12.17 分;交换训练方式后,两组增幅都明显放缓(分别为 1.37 分和 3.19 分)。
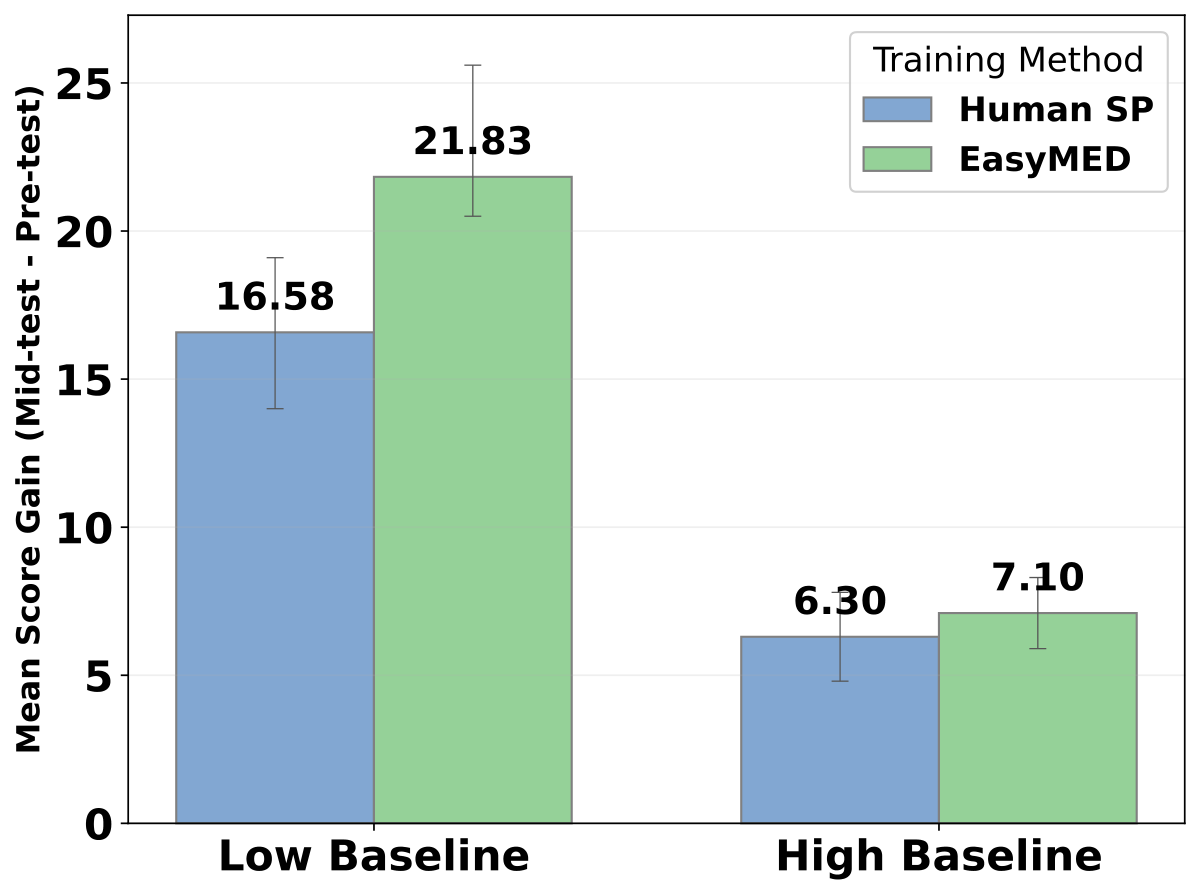 图 4:第一阶段(前两周)不同基础学生的平均提分,蓝色为真人 SP,绿色为 EasyMED(图源:论文)
按前测成绩把学生分为基础较好(前 3 名)和基础较弱(后 4 名)两层后,差异更明显:基础较弱的学生使用 EasyMED 平均提高 21.83 分,使用真人 SP 为 16.58 分;基础较好的学生提升都较小(7.10 分对 6.30 分)。论文认为,EasyMED 对训练早期的新手尤其有效。
更敢问、随时练、成本更低
学生对 EasyMED 对话真实感的平均评分为 4.6 分(5 分制);对学习帮助的评分为 4.5 分,与真人 SP 的 4.7 分相近。学生在 EasyMED 上的学习焦虑评分显著低于真人 SP(0.5 对 3.2,分数越低越好,p < .01),他们反馈更不担心犯错,也更愿意尝试探索性或重复性的提问。
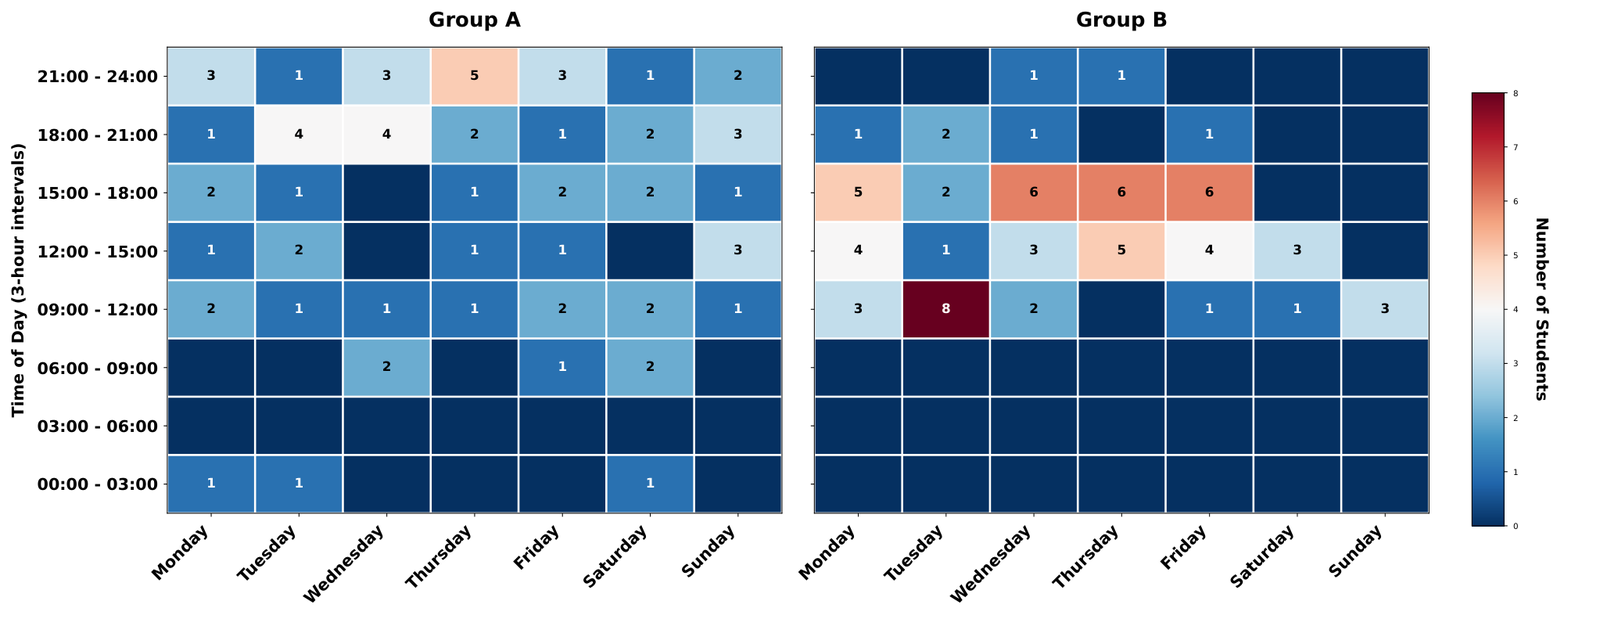 图 5:每周练习时段分布,左为 EasyMED 组,右为真人 SP 组,格中数字为该时段练习的学生人数(图源:论文)
系统日志显示,EasyMED 的练习分散在一天中的各个时段,包括晚间和周末,而真人 SP 练习基本集中在工作日的工作时间。EasyMED 单次练习平均 54 轮对话、时长 28 分 49 秒,真人 SP 为 47 轮、15 分 17 秒。论文提示,文字交互本身可能拉长时长,但更多的对话轮数说明学生追问得更充分。
成本差距更直观:按一次完整练习的 token(词元)用量计算,EasyMED 单次成本约 0.725 美元;按真人 SP 的标准时薪折算,单次约 52.95 美元,相差约 73 倍。
意义与局限
论文的结论并不是“AI 取代真人 SP”,而是:基于大模型的多智能体虚拟标准化病人,可以成为传统 SP 项目实用、可扩展的补充,让学生随时、低压力、反复地练习问诊。
作者也列出了局限:实验只在一所学校进行,样本少且背景相近;EasyMED 目前只支持文字交互,缺少表情、语气等非语言和多模态线索;自动评分虽与专家评分高度相关,仍可能遗漏对话质量和学习行为中的细微之处。后续计划开展更大规模的多中心、长期研究,引入多模态交互,并继续完善评价指标。
同一方向上,王本友与合作者的另一项研究“It Talks Like a Patient, But Feels Different”(CHI 2026 海报论文,张兵权为作者之一)访谈了 12 名临床阶段医学生并组织三场共创工作坊,发现决定学习者信任与投入的不只是对话是否逼真,更在于教学上是否好用。
EasyMED 的智能体模块与 SPBench 的评测脚本、病例数据均已在 GitHub 开源。
团队介绍
本文由武汉大学人工智能学院、香港中文大学(深圳)与自由动脉合作完成。
周磊|自由动脉全职员工,论文第四作者
周磊在 EasyMED 项目中负责部分系统的开发、与用户的对接,以及系统的上线部署。他在论文中的署名单位为自由动脉(Freedom AI)。
其他作者
- 张兵权(Bingquan Zhang):论文共同第一作者,自由动脉实习生,署名单位为武汉大学人工智能学院、香港中文大学(深圳)和自由动脉;也是上述 CHI 2026 共创设计研究的作者之一。
- 王本友:论文通讯作者之一,自由动脉首席 AI 科学家,香港中文大学(深圳)数据科学学院助理教授、博士生导师。
- 其他作者:Xiaoxiao Liu(共同第一作者)和 Yuchi Wang 来自香港中文大学(深圳),Qianqian Xie(通讯作者之一)来自武汉大学人工智能学院。