
Zhenyang Cai
FreedomAI CTO
I+D de modelos médicos multimodales
- Doctorando, Universidad China de Hong Kong (Shenzhen)
- Participó en HuatuoGPT-o1, DentalGPT y otros modelos
- Artículos como primer autor en NeurIPS y ACL
Biografía
Zhenyang Cai es el CTO de FreedomAI y dirige la I+D de modelos médicos multimodales mientras cursa el doctorado en la Universidad China de Hong Kong (Shenzhen).
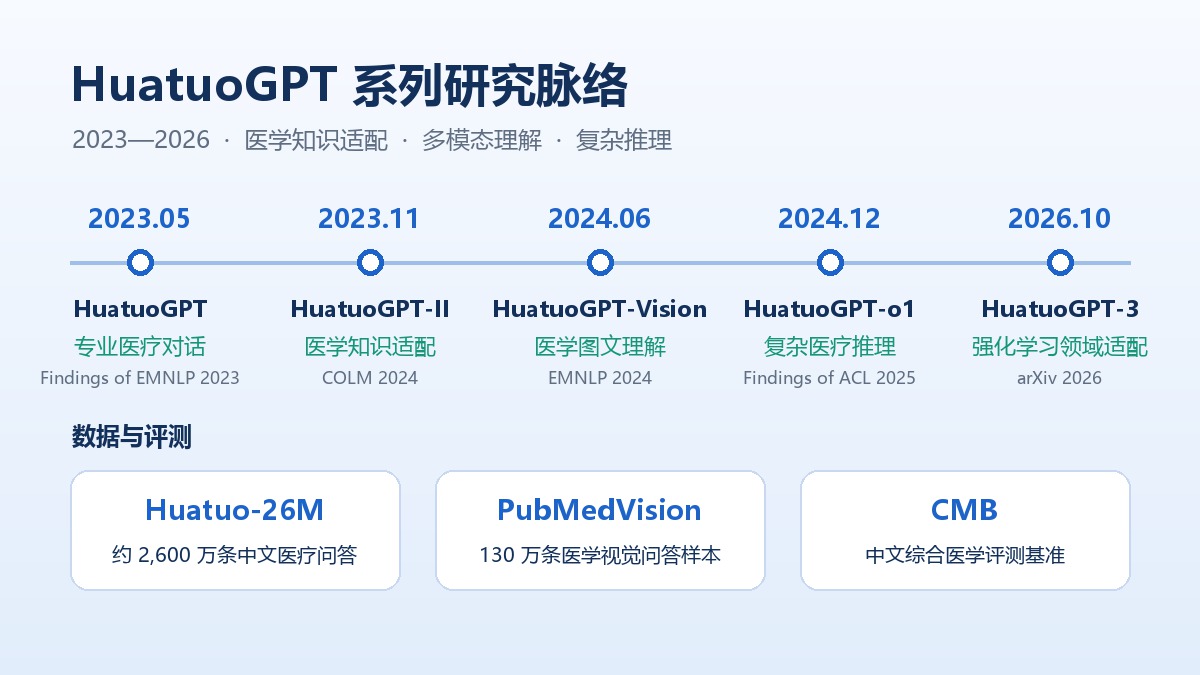
Participó en grandes modelos médicos como HuatuoGPT-Vision y HuatuoGPT-o1 (segundo autor), y es primer autor o coprimer autor del gran modelo multimodal dental DentalGPT (Findings of ACL 2026), de la evaluación dental multinacional GlobalDentBench, de un estudio sobre generalización composicional en imagen médica (ACL 2025), de la alineación nativa en el preentrenamiento de LLM en árabe (NeurIPS 2024) y del modelo multimodal de medicina tradicional china ShizhenGPT (Findings of EMNLP 2026).
En 2026, el artículo de HuatuoGPT-Vision-2 en el que participó fue seleccionado como NeurIPS 2026 Oral, y el modelo fundacional de patología CMD y la evaluación del mundo microscópico MicroVerse se publicaron en NeurIPS 2026 e ICLR 2026. A noviembre de 2026, sus artículos suman 1168 citas en Google Scholar, con un índice h de 9.
Publicaciones destacadas 21
Publicaciones destacadas; la lista completa está en Google Scholar.
2026
- Incentivizing Medical Vision Capabilities from Large-Scale Multimodal Pre-training
- MedIGen: Reliable Medical Illustration Generation via Interleaved Introspective Reasoning
- Beyond ViT Tokens: Masked-Diffusion Pretrained Convolutional Pathology Foundation Model for Cell-Level Dense Prediction
- MicroVerse: A Preliminary Exploration Toward a Micro-World Simulation
- DentalGPT: Incentivizing Multimodal Reasoning in Dentistry
- GlobalDentBench: A Multinational Benchmark for Evaluating LLM Clinical Reasoning in Dentistry with Expert Calibration
- Agentifying Patient Dynamics within LLMs through Interacting with Clinical World Model
- ShizhenGPT: Towards Multimodal LLMs for Traditional Chinese Medicine
- Towards a Radiologist Imitation Framework for 3D CT Diagnosis with Multimodal LLMs
- To What Extent Do Token-Level Representations from Pathology Foundation Models Improve Dense Prediction?
- DeCo-MIL: Debiased Counterfactual Reasoning for Long-Tailed Whole Slide Image Analysis
2025
- Exploring Compositional Generalization of Multimodal LLMs for Medical Imaging
- Towards Medical Complex Reasoning with LLMs through Medical Verifiable Problems
- LongLLaVA: Scaling Multi-modal LLMs to 1000 Images Efficiently via a Hybrid Architecture
- ShareGPT-4o-Image: Aligning Multimodal Models with GPT-4o-Level Image Generation
- WaveMind: Towards a Conversational EEG Foundation Model Aligned to Textual and Visual Modalities
- MedGen: Unlocking Medical Video Generation by Scaling Granularly-annotated Medical Videos
- Can Multimodal LLMs See Materials Clearly? A Multimodal Benchmark on Materials Characterization
Noticias relacionadas
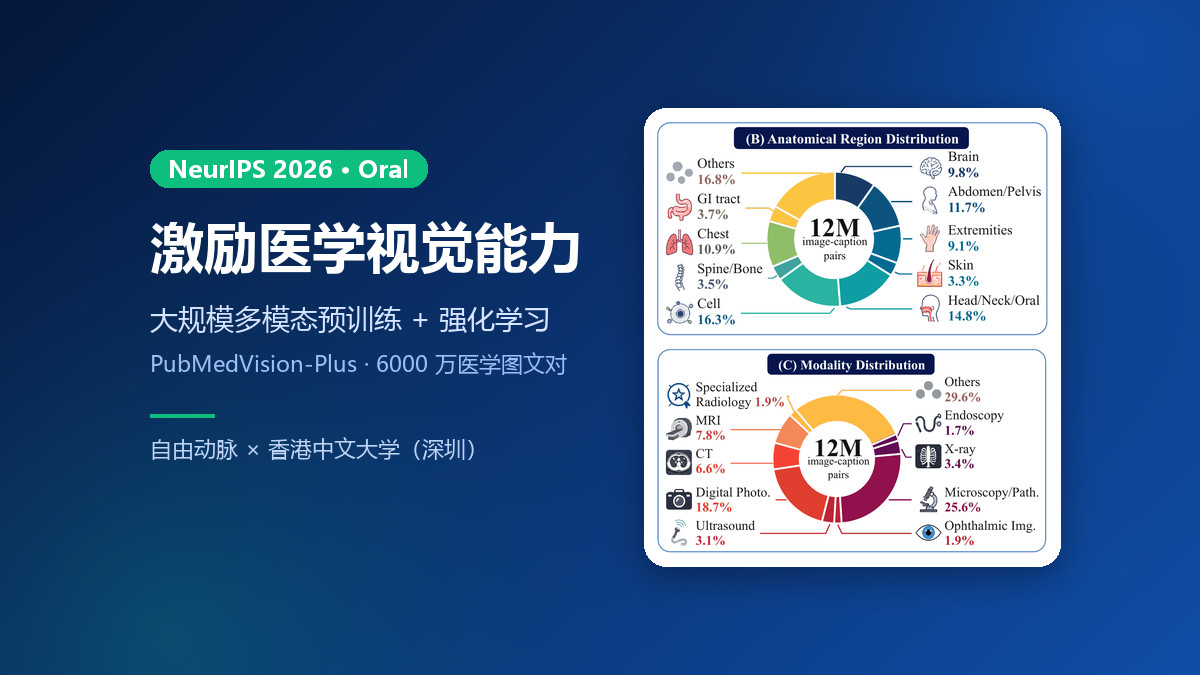
NeurIPS 2026 Oral | FreedomAI y la Universidad China de Hong Kong (Shenzhen) presentan un gran modelo multimodal médico que usa aprendizaje por refuerzo para potenciar la visión médica
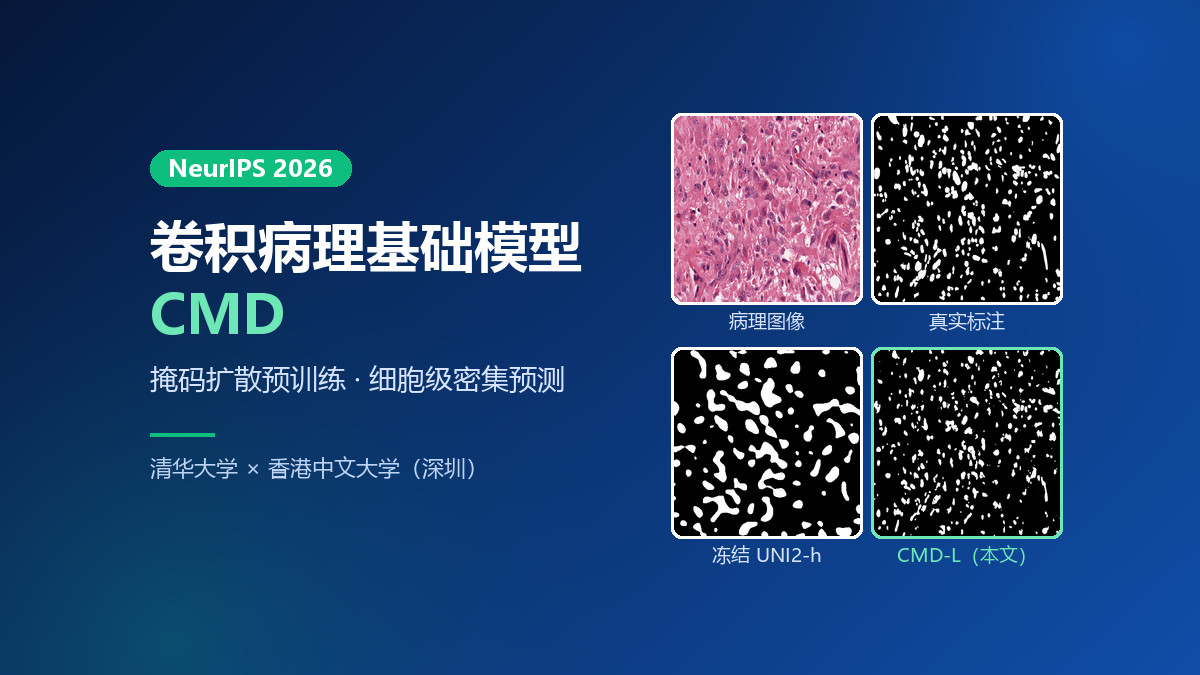
NeurIPS 2026 | Coescrito por Zhenyang Cai, CTO de FreedomAI: un modelo fundacional convolucional de patología que entrena solo 7 millones de parámetros supera a los grandes modelos ViT de patología en segmentación celular
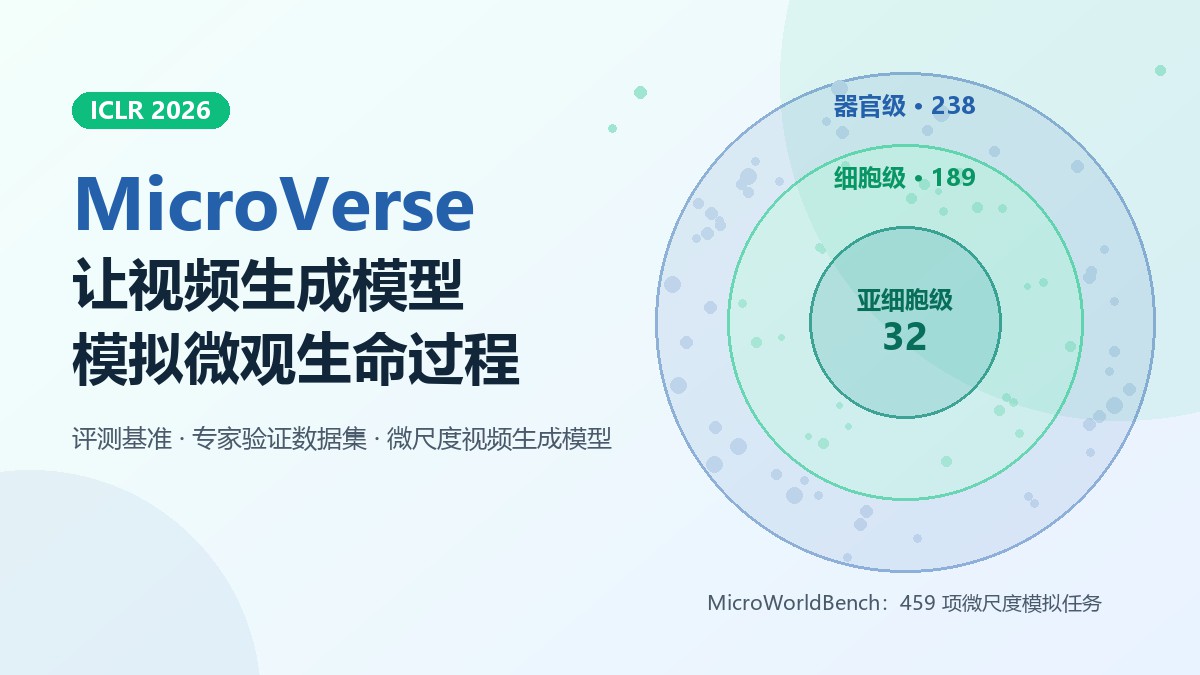
ICLR 2026 | Coescrito por Zhenyang Cai, CTO de FreedomAI: MicroVerse usa 459 tareas para revelar los «puntos ciegos microscópicos» de los modelos de vídeo
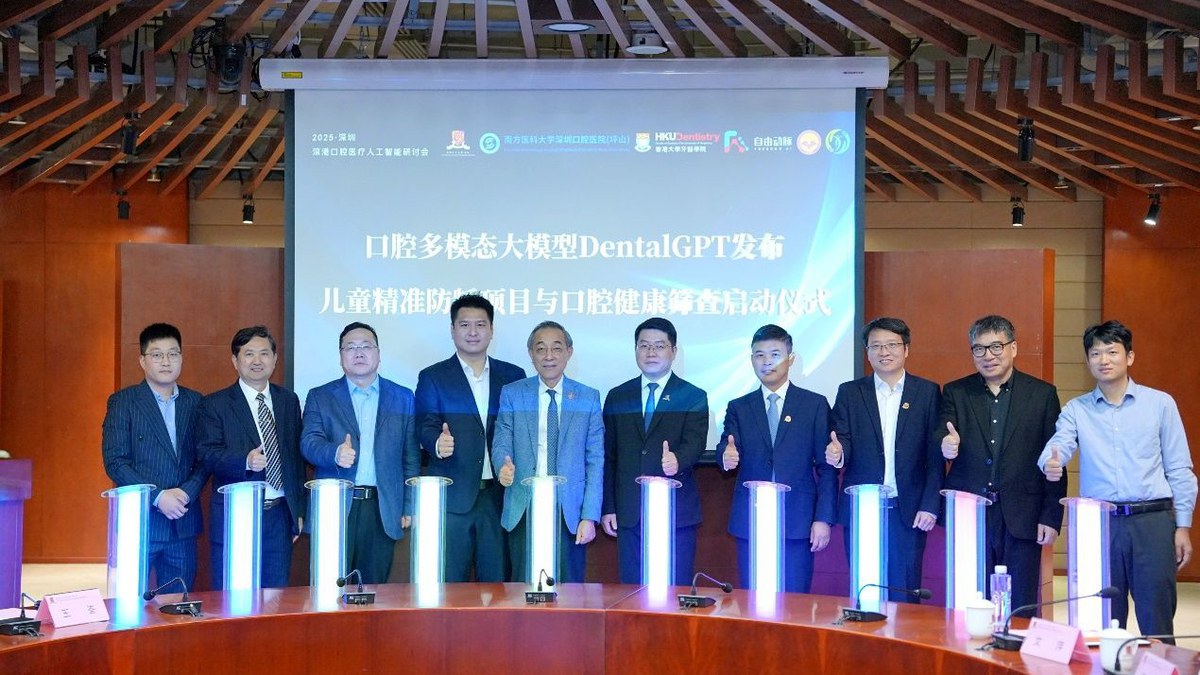
ACL 2026 Findings | FreedomAI, la CUHK-Shenzhen y otros socios presentan DentalGPT, un gran modelo multimodal de salud bucodental: 7B de parámetros y una precisión media superior a GPT-5 en cinco benchmarks dentales
 Jianquan Li
 Junjie Zhao
 Xiangyi Feng
 Zhiyi Zhang
 Junwen Wang
 Benyou Wang