
Zhenyang Cai
FreedomAI CTO
R&D de modèles médicaux multimodaux
- Doctorant, Université chinoise de Hong Kong (Shenzhen)
- A contribué à HuatuoGPT-o1, DentalGPT et d'autres modèles
- Articles en premier auteur à NeurIPS et ACL
Biographie
Zhenyang Cai est le CTO de FreedomAI. Il dirige la R&D des modèles médicaux multimodaux tout en préparant un doctorat à l'Université chinoise de Hong Kong (Shenzhen).
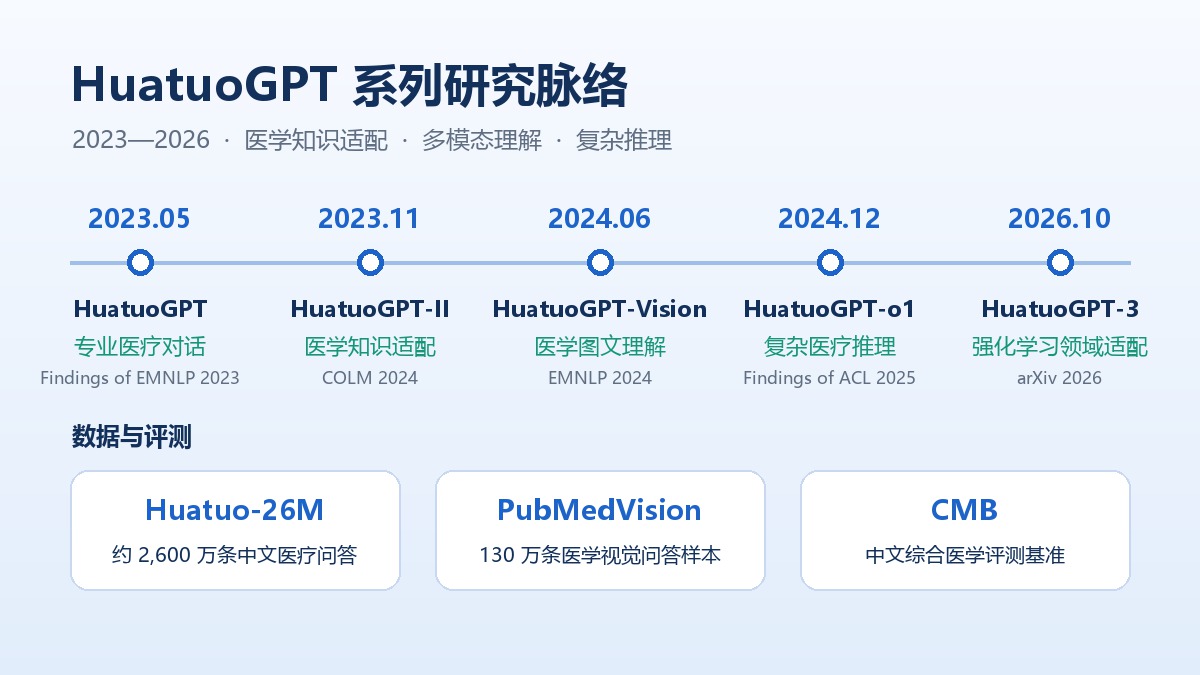
Il a contribué à des grands modèles médicaux comme HuatuoGPT-Vision et HuatuoGPT-o1 (deuxième auteur), et il est premier ou co-premier auteur du grand modèle multimodal dentaire DentalGPT (Findings of ACL 2026), de l'évaluation dentaire multinationale GlobalDentBench, d'une étude sur la généralisation compositionnelle en imagerie médicale (ACL 2025), de l'alignement natif dans le pré-entraînement de LLM en arabe (NeurIPS 2024) et du modèle multimodal de médecine traditionnelle chinoise ShizhenGPT (Findings of EMNLP 2026).
En 2026, l'article HuatuoGPT-Vision-2 auquel il a contribué a été retenu en Oral à NeurIPS 2026, et le modèle de fondation en pathologie CMD ainsi que le benchmark du monde microscopique MicroVerse ont été publiés à NeurIPS 2026 et ICLR 2026. En novembre 2026, ses articles comptent 1 168 citations sur Google Scholar, avec un indice h de 9.
Publications choisies 21
Publications choisies ; la liste complète est sur Google Scholar.
2026
- Incentivizing Medical Vision Capabilities from Large-Scale Multimodal Pre-training
- MedIGen: Reliable Medical Illustration Generation via Interleaved Introspective Reasoning
- Beyond ViT Tokens: Masked-Diffusion Pretrained Convolutional Pathology Foundation Model for Cell-Level Dense Prediction
- MicroVerse: A Preliminary Exploration Toward a Micro-World Simulation
- DentalGPT: Incentivizing Multimodal Reasoning in Dentistry
- GlobalDentBench: A Multinational Benchmark for Evaluating LLM Clinical Reasoning in Dentistry with Expert Calibration
- Agentifying Patient Dynamics within LLMs through Interacting with Clinical World Model
- ShizhenGPT: Towards Multimodal LLMs for Traditional Chinese Medicine
- Towards a Radiologist Imitation Framework for 3D CT Diagnosis with Multimodal LLMs
- To What Extent Do Token-Level Representations from Pathology Foundation Models Improve Dense Prediction?
- DeCo-MIL: Debiased Counterfactual Reasoning for Long-Tailed Whole Slide Image Analysis
2025
- Exploring Compositional Generalization of Multimodal LLMs for Medical Imaging
- Towards Medical Complex Reasoning with LLMs through Medical Verifiable Problems
- LongLLaVA: Scaling Multi-modal LLMs to 1000 Images Efficiently via a Hybrid Architecture
- ShareGPT-4o-Image: Aligning Multimodal Models with GPT-4o-Level Image Generation
- WaveMind: Towards a Conversational EEG Foundation Model Aligned to Textual and Visual Modalities
- MedGen: Unlocking Medical Video Generation by Scaling Granularly-annotated Medical Videos
- Can Multimodal LLMs See Materials Clearly? A Multimodal Benchmark on Materials Characterization
Actualités associées
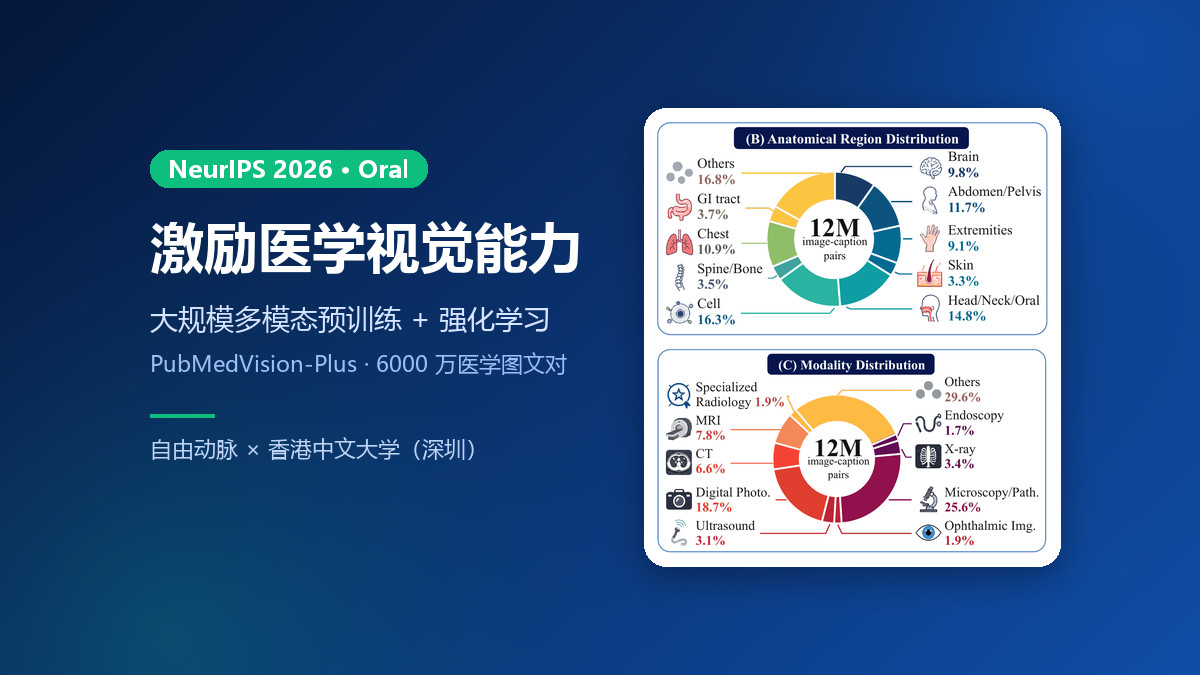
NeurIPS 2026 Oral | FreedomAI et l'Université chinoise de Hong Kong (Shenzhen) présentent un grand modèle multimodal médical qui s'appuie sur l'apprentissage par renforcement pour libérer ses capacités de vision médicale
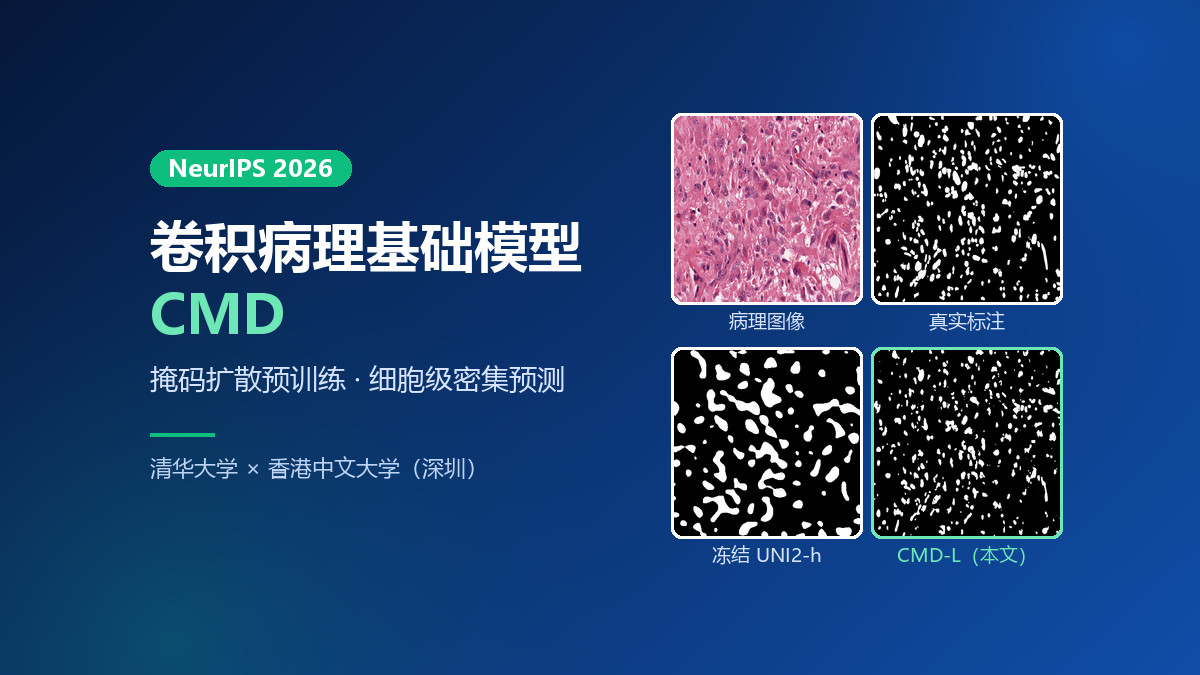
NeurIPS 2026 | Coécrit par Zhenyang Cai, CTO de FreedomAI : un modèle de fondation convolutif en pathologie qui n'entraîne que 7 millions de paramètres surpasse les grands modèles ViT en segmentation cellulaire
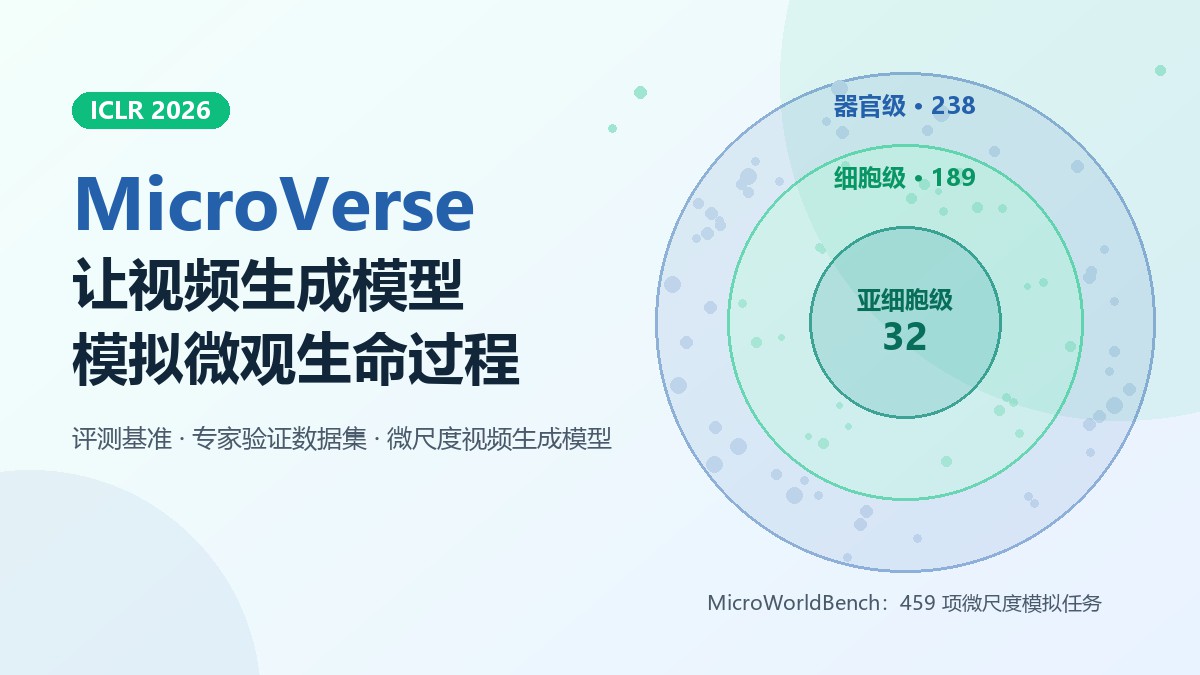
ICLR 2026 | Coécrit par Zhenyang Cai, CTO de FreedomAI : MicroVerse s'appuie sur 459 tâches pour révéler les « angles morts microscopiques » des modèles vidéo
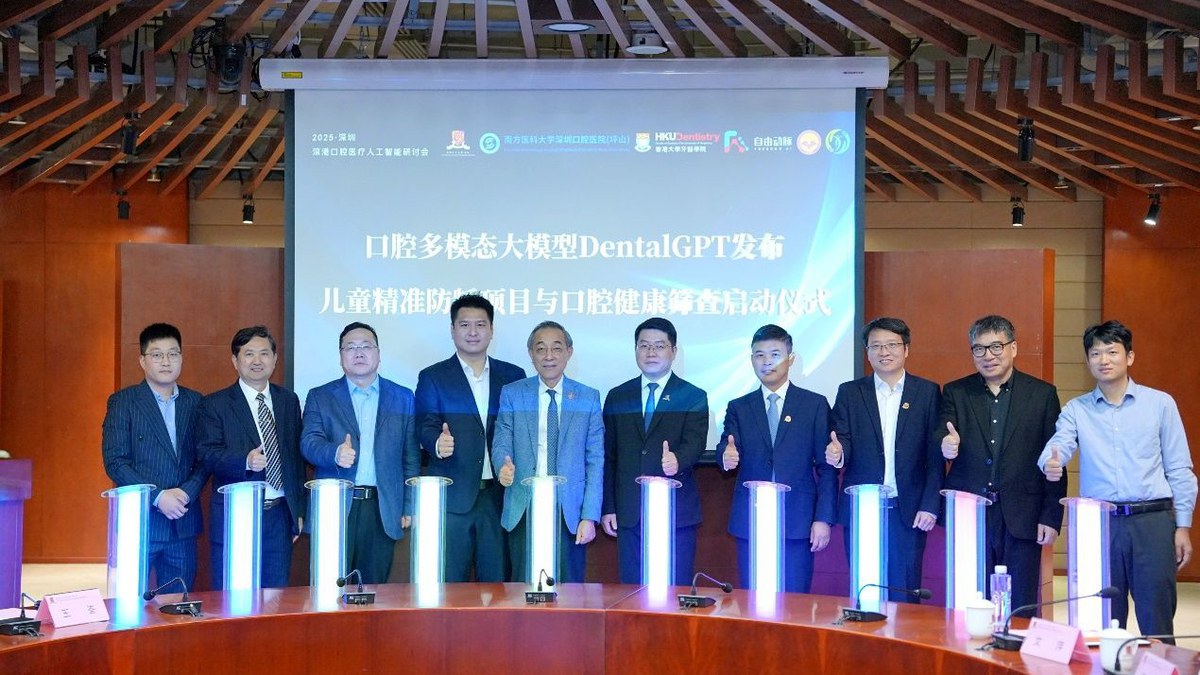
ACL 2026 Findings | FreedomAI, la CUHK-Shenzhen et leurs partenaires présentent DentalGPT, un grand modèle multimodal de santé bucco-dentaire : 7B paramètres et une précision moyenne supérieure à GPT-5 sur cinq benchmarks dentaires
 Jianquan Li
 Junjie Zhao
 Xiangyi Feng
 Zhiyi Zhang
 Junwen Wang
 Benyou Wang