
蔡镇阳 Zhenyang Cai
自由动脉 CTO
多模态医疗模型研发
- 香港中文大学(深圳)博士研究生
- 参与 HuatuoGPT-o1、DentalGPT 等模型研发
- 以第一作者发表 NeurIPS、ACL 论文
1,168Google Scholar 引用(2026.11)
9h 指数
NeurIPS · ACL第一作者(含共同第一)论文
个人简介
蔡镇阳是自由动脉 CTO,负责多模态医疗模型研发,同时在香港中文大学(深圳)攻读博士学位。
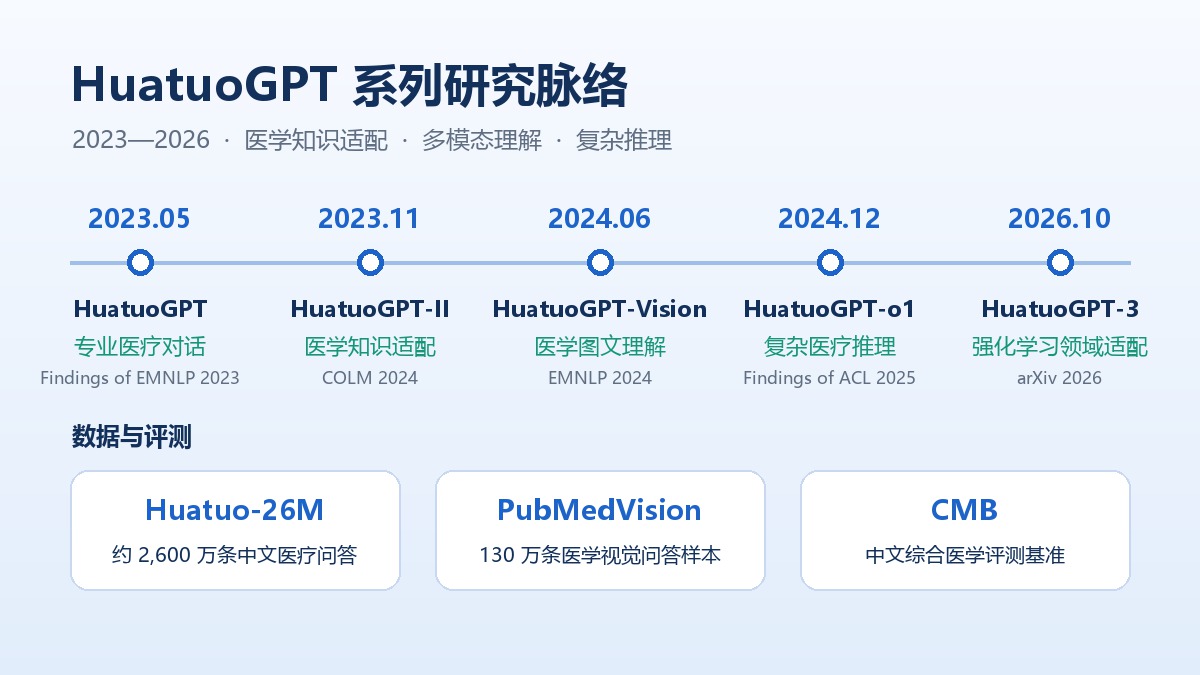
他参与了 HuatuoGPT-Vision、HuatuoGPT-o1(第二作者)等医疗大模型的研发,并以第一作者或共同第一作者完成口腔多模态大模型 DentalGPT(Findings of ACL 2026)、跨国牙科评测基准 GlobalDentBench、医学影像的组合泛化研究(ACL 2025)、阿拉伯语大模型预训练阶段的原生对齐(NeurIPS 2024)和中医多模态大模型 ShizhenGPT(Findings of EMNLP 2026)等工作。
2026 年,他参与的 HuatuoGPT-Vision-2 论文入选 NeurIPS 2026 Oral,病理基础模型 CMD 与微观世界模拟 MicroVerse 分别发表于 NeurIPS 2026 和 ICLR 2026。截至 2026 年 11 月,他的论文在 Google Scholar 上被引用 1,168 次,h 指数 9。
代表性论文 21
以下为部分代表性论文,完整列表见 Google Scholar。
2026
- Incentivizing Medical Vision Capabilities from Large-Scale Multimodal Pre-training
- MedIGen: Reliable Medical Illustration Generation via Interleaved Introspective Reasoning
- Beyond ViT Tokens: Masked-Diffusion Pretrained Convolutional Pathology Foundation Model for Cell-Level Dense Prediction
- MicroVerse: A Preliminary Exploration Toward a Micro-World Simulation
- DentalGPT: Incentivizing Multimodal Reasoning in Dentistry
- GlobalDentBench: A Multinational Benchmark for Evaluating LLM Clinical Reasoning in Dentistry with Expert Calibration
- Agentifying Patient Dynamics within LLMs through Interacting with Clinical World Model
- ShizhenGPT: Towards Multimodal LLMs for Traditional Chinese Medicine
- Towards a Radiologist Imitation Framework for 3D CT Diagnosis with Multimodal LLMs
- To What Extent Do Token-Level Representations from Pathology Foundation Models Improve Dense Prediction?
- DeCo-MIL: Debiased Counterfactual Reasoning for Long-Tailed Whole Slide Image Analysis
2025
- Exploring Compositional Generalization of Multimodal LLMs for Medical Imaging
- Towards Medical Complex Reasoning with LLMs through Medical Verifiable Problems
- LongLLaVA: Scaling Multi-modal LLMs to 1000 Images Efficiently via a Hybrid Architecture
- ShareGPT-4o-Image: Aligning Multimodal Models with GPT-4o-Level Image Generation
- WaveMind: Towards a Conversational EEG Foundation Model Aligned to Textual and Visual Modalities
- MedGen: Unlocking Medical Video Generation by Scaling Granularly-annotated Medical Videos
- Can Multimodal LLMs See Materials Clearly? A Multimodal Benchmark on Materials Characterization
相关 News
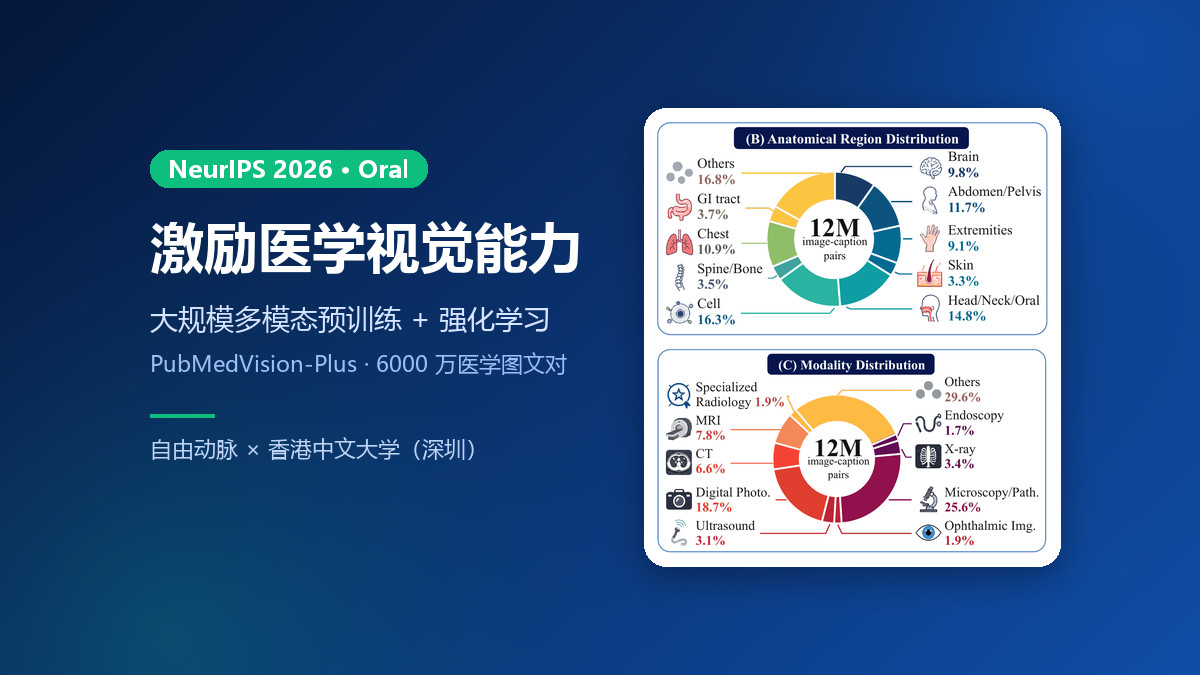
论文 · 2026.11.16
NeurIPS 2026 Oral|自由动脉携手香港中文大学(深圳)推出医疗多模态大模型,用强化学习激发医学视觉能力
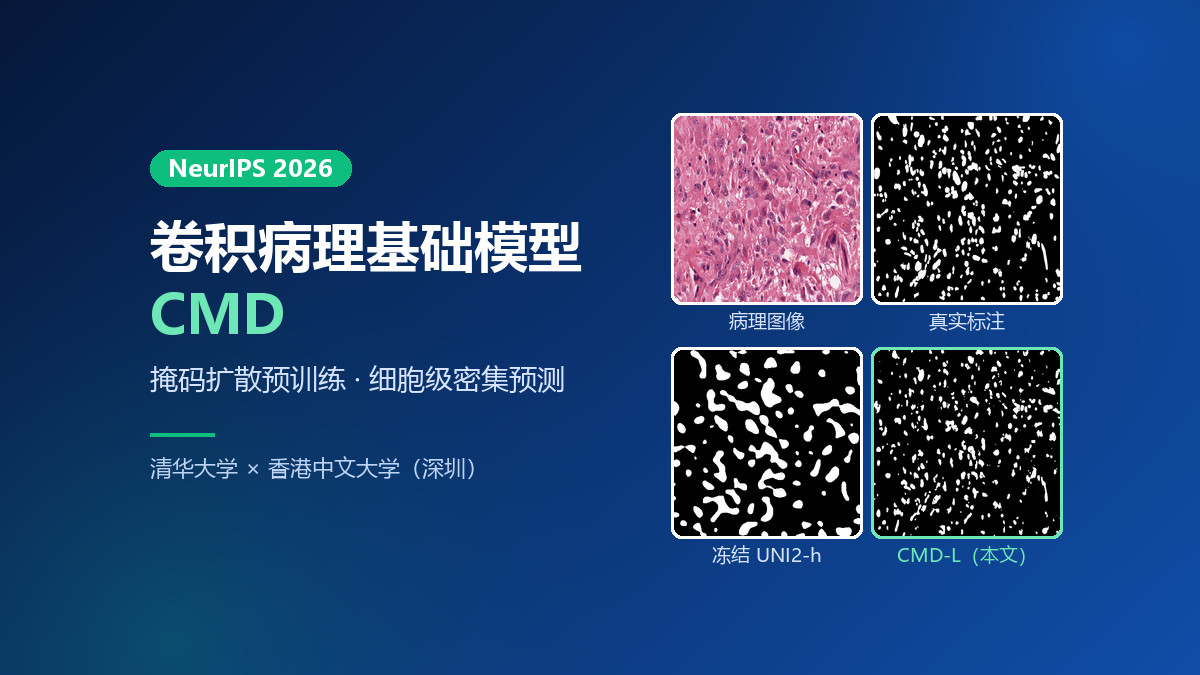
论文 · 2026.11.16
NeurIPS 2026|自由动脉 CTO 蔡镇阳合著:卷积病理基础模型只训 700 万参数,细胞分割超越 ViT 病理大模型
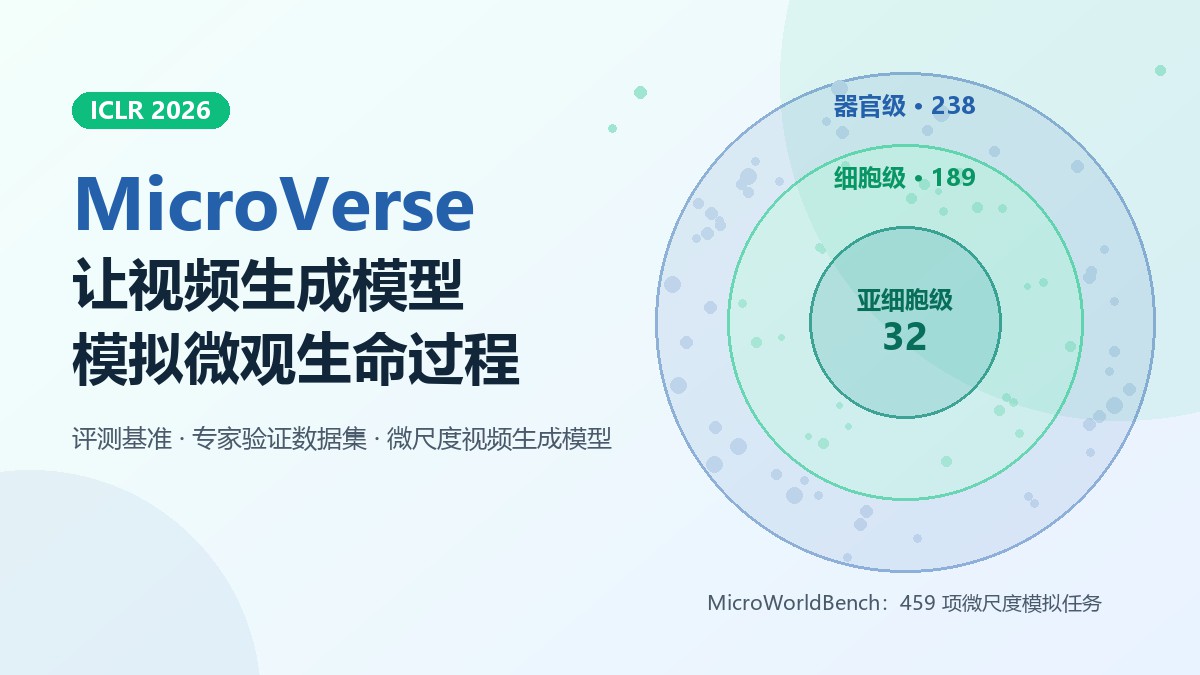
论文 · 2026.11.16
ICLR 2026|自由动脉 CTO 蔡镇阳合著 MicroVerse:用 459 项任务考出视频模型的“微观短板”
技术 · 2026.11.16
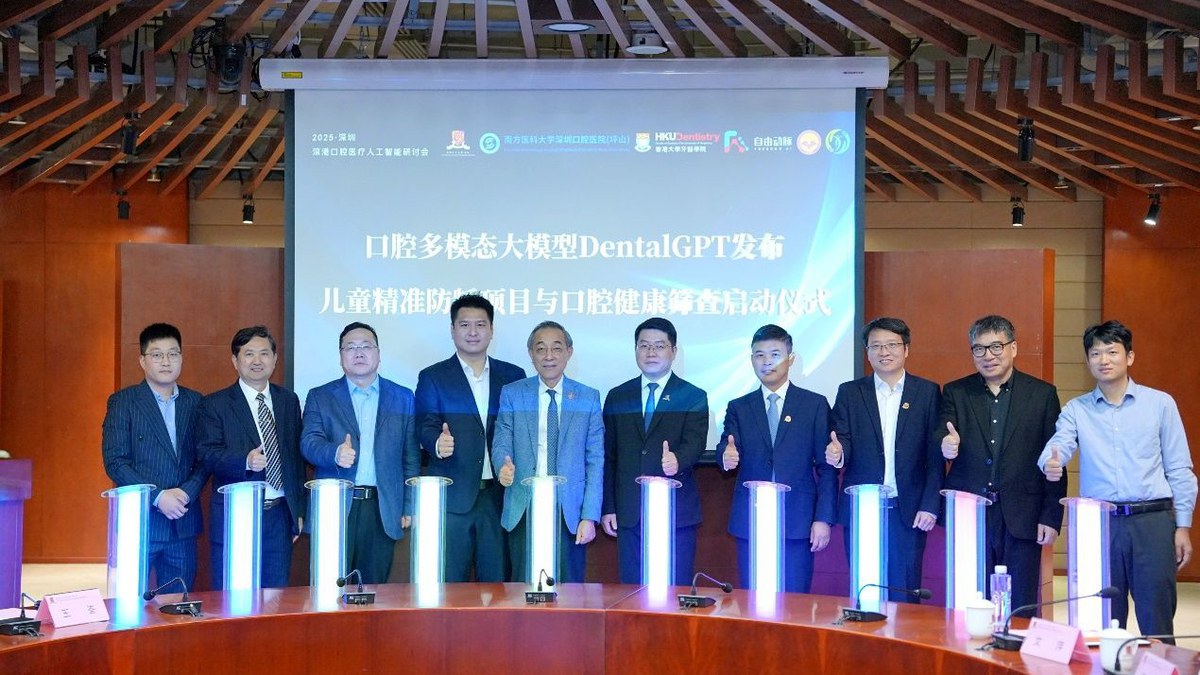
ACL 2026 Findings|自由动脉携手港中深等推出口腔多模态大模型 DentalGPT:7B 参数,五项口腔基准平均准确率超 GPT-5
技术 · 2026.11.16
 李健铨
 赵俊杰
 冯相义
 张志一
 王俊文
 王本友