ICLR 2026|自由动脉 CTO 蔡镇阳合著 MicroVerse:用 459 项任务考出视频模型的“微观短板”
视频生成模型这两年进步飞快:街景、人物、物体运动都能生成得以假乱真,研究者也开始把它们当作“世界模拟器”,用来帮助机器人学习技能、帮助智能体探索环境。
但这些进展几乎都发生在肉眼可见的宏观尺度。把镜头推进到肺泡、细胞乃至分子,情况就变了:生成的画面“看起来像那么回事”,过程却经不起推敲。论文展示的案例中,Sora 和 Veo3 在模拟肺泡、细胞分裂和 DNA 相关过程时,都出现了违反物理或生物规律的情况。
针对这一空白,来自香港中文大学(深圳)、北京协和医院和深圳河套学院的研究者提出“微观世界模拟”(Micro-World Simulation)的概念,并给出一套完整的概念验证:评测基准 MicroWorldBench、专家验证数据集 MicroSim-10K,以及在此基础上训练的微尺度视频生成模型 MicroVerse。论文已被 ICLR 2026 接收(Poster)。自由动脉 CTO 蔡镇阳是论文作者之一,自由动脉首席 AI 科学家王本友是论文通讯作者。
论文标题:MicroVerse: A Preliminary Exploration Toward a Micro-World Simulation
论文链接:https://arxiv.org/abs/2603.00585
代码:https://github.com/FreedomIntelligence/MicroVerse
数据集:https://huggingface.co/datasets/wangrongsheng/MicroVerse
作者:Rongsheng Wang*、Minghao Wu*、Hongru Zhou、Zhihan Yu、Zhenyang Cai(蔡镇阳)、Junying Chen、Benyou Wang(王本友)†(* 共同第一作者,† 通讯作者)
作者单位:香港中文大学(深圳)、北京协和医院、深圳河套学院
背景:世界模型的盲区在微观尺度
微观模拟追踪原子、分子和细胞之间的相互作用,是理解生命过程背后机制的重要手段。论文指出,它在药物发现、器官芯片、疾病机制研究等生物医学场景中前景广阔,在教育和交互式可视化上也有潜力。
问题在于,现有视频模型主要用人类尺度的视频训练,缺少微观物理原理和生物医学知识的支撑。作者把这项工作定位为对“生物机制教育性微观模拟”的探索,而非复现湿实验的结果。
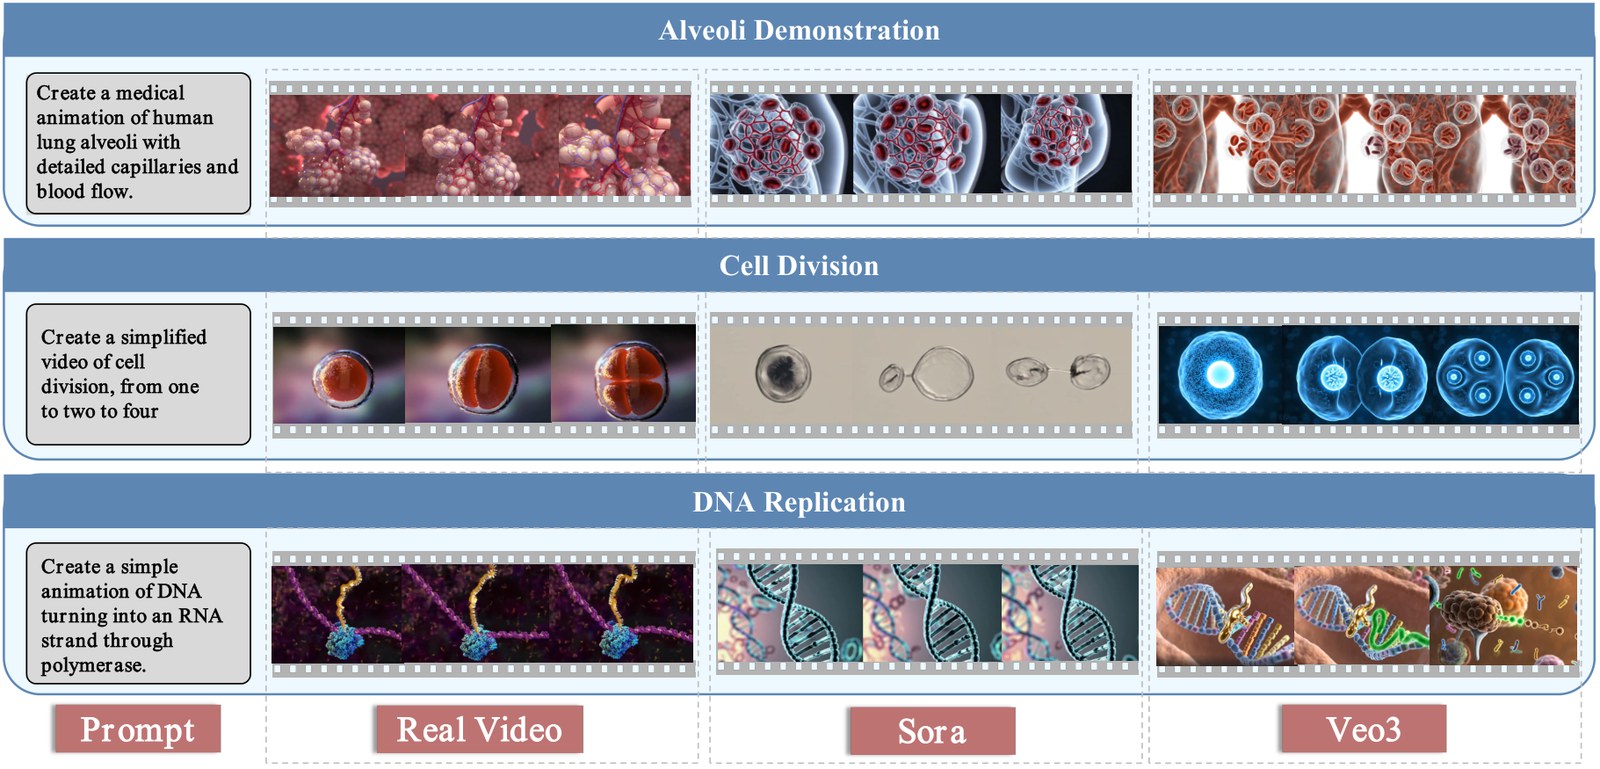 图 1:Sora 与 Veo3 在微观模拟上的失败案例,三行分别为肺泡、细胞分裂和 DNA 相关过程,左起依次为提示词、真实视频、Sora 和 Veo3 的结果(图源:论文)
方法一:MicroWorldBench,为微观视频制定评分细则
已有的视频评测多用通用评分规则,难以发现“画面好看、机制错误”的问题。MicroWorldBench 为每个任务单独制定带权重的评分细则(rubric),把专家认为最关键的科学要点放在首位。
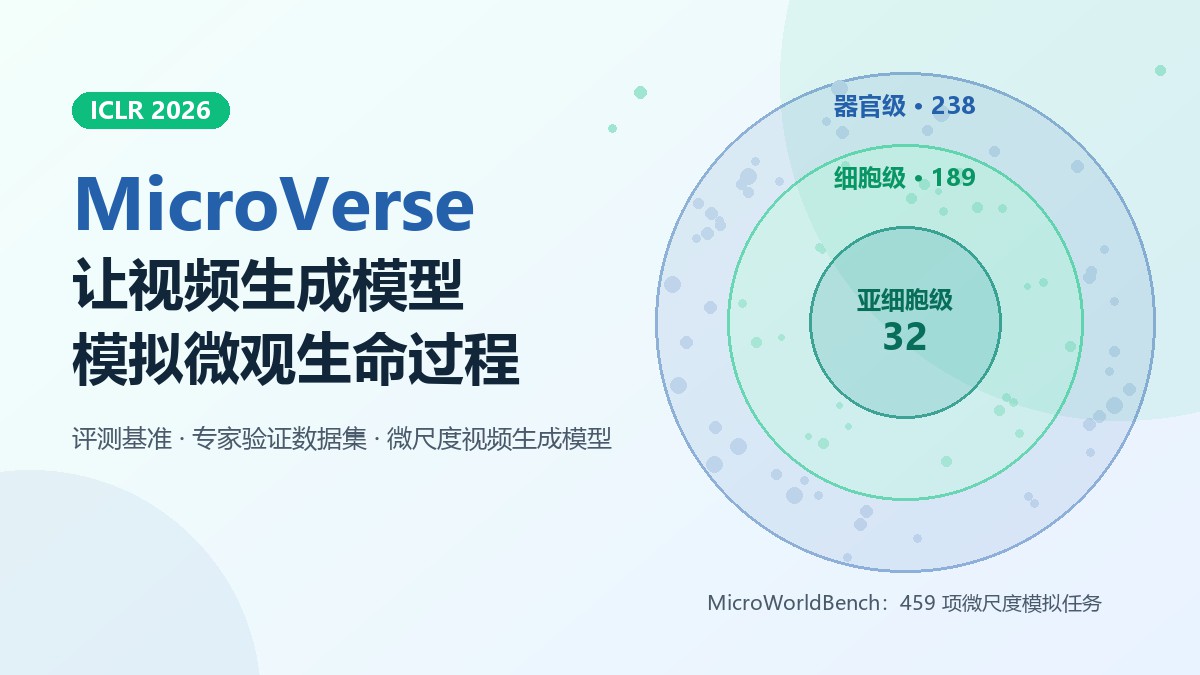
任务从哪来。 研究者按器官级、细胞级、亚细胞级三个层级的主题检索了 8,000 多个 YouTube 视频,由 GPT-4o 根据标题和简介生成 8,162 个候选任务,再经三位生物学专家筛选(每个任务至少获两位专家认可),最终保留 459 个任务:器官级 238 个、细胞级 189 个、亚细胞级 32 个。
细则怎么定。 对每个任务,GPT-5 先起草一组评分条目,每条包括评价维度(科学保真度、视觉质量或指令遵循)、具体描述、加分或扣分方向,以及权重(核心科学要求 1.0、重要但次要的要求 0.5、辅助或呈现层面的要求 0.2)。随后三位拥有博士学位、在细胞与分子生物学领域有 8 至 12 年经验的专家独立审改:删除冗余条目、调整权重、补充遗漏的科学约束,再经讨论和多数表决合并。最终得分按全部加分项的满分归一化到 100 分,避免次要加分项抵消严重的科学错误。
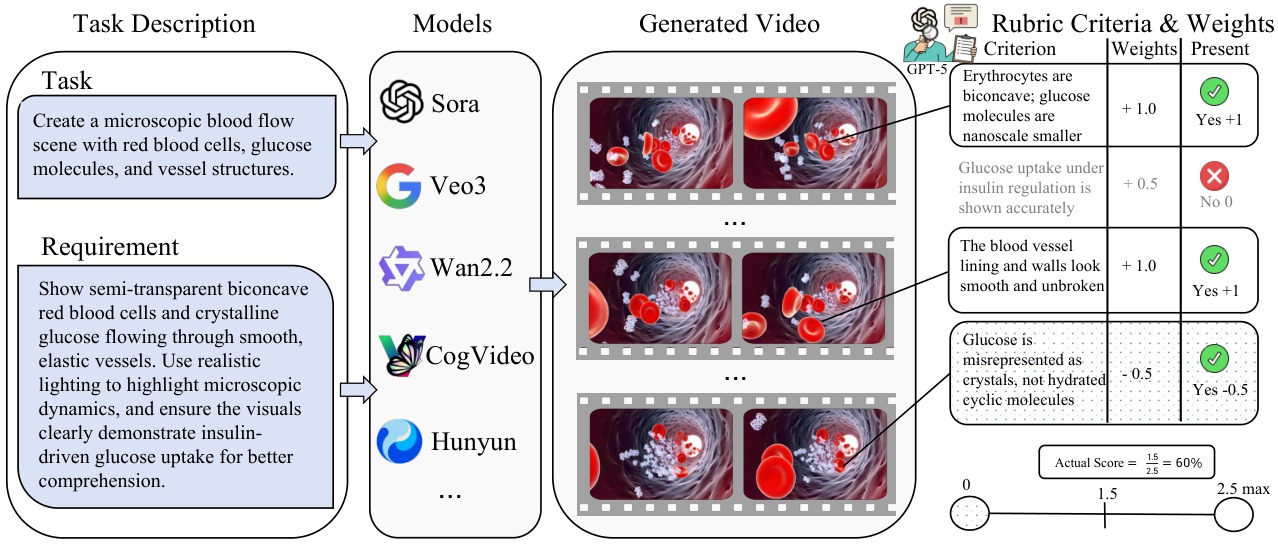 图 2:MicroWorldBench 评测流程示例:任务要求生成含红细胞、葡萄糖分子和血管的微观血流场景,评分系统按专家修订的条目逐项判断,示例视频得 1.5/2.5,即 60%(图源:论文)
专家的修改留有记录:只有约 7.6% 的任务需要专家补充遗漏的科学条目;尺度越小,专家介入越多,器官级任务平均每题修改 1.52 次,细胞级 3.00 次,亚细胞级 5.50 次。评分由 GPT-5 担任裁判。抽样核验显示,仅人类专家之间的一致性系数(Fleiss' κ)为 0.733,加入 GPT-5 后为 0.771;GPT-5 与 Gemini-2.5-pro 打分的 Spearman 相关系数为 0.835。
评测发现:画面逼真,机制失真
研究者在 MicroWorldBench 上评测了 HunyuanVideo、CogVideoX、Wan2.1 / Wan2.2 系列等开源模型,以及 Sora、Veo3 两个商业模型,每个模型按默认设置只推理一次。
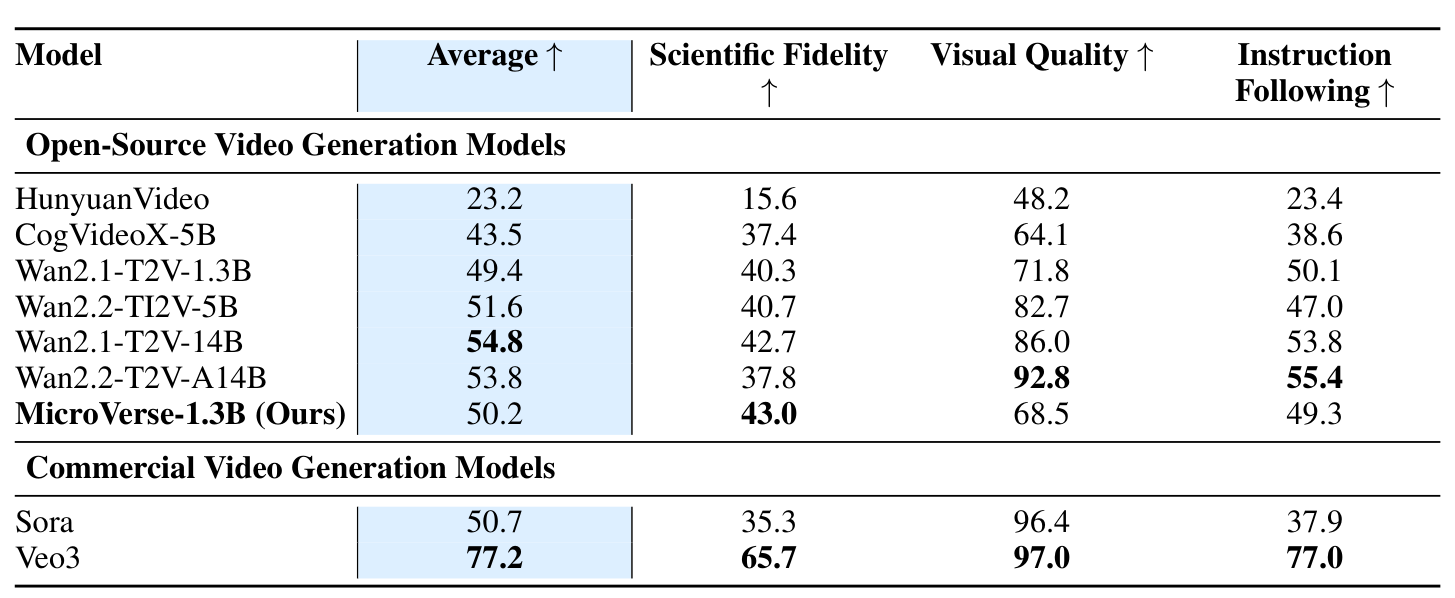 图 3:各视频生成模型在 MicroWorldBench 上的分维度得分(图源:论文表 2)
结果揭示了三个现象:
- 视觉质量高,科学保真度低。 Wan2.2-T2V-A14B、Sora、Veo3 的视觉质量都在 92 分以上,但科学保真度明显落后:除 Veo3(65.7)外,参评模型都在 15.6 至 43.0 之间。Sora 的视觉质量为 96.4,科学保真度只有 35.3。
- 尺度越小越难。 例如 Wan2.2-T2V-A14B 器官级得分 56.3,细胞级和亚细胞级分别为 52.0 和 53.3;Sora 的细胞级得分(46.1)也明显低于器官级(55.9)。作者认为,这与微观任务对物理、生物一致性要求更高、训练数据更稀缺有关。
- 只堆参数不够。 在 Wan2.1 系列中,模型从 1.3B 扩大到 14B,视觉质量从 71.8 升至 86.0,科学保真度只从 40.3 升至 42.7。
方法二:MicroSim-10K 与 MicroVerse
要补上“微观常识”,先要有对的数据。研究者通过 YouTube 官方 API 检索微观模拟视频,只保留分辨率不低于 720p、采用知识共享(Creative Commons)许可的视频,共 12,848 个;再用 OpenCLIP 按相邻帧相似度切出 67,853 个语义连贯的片段,并层层过滤:
- 基于 VideoMAE 训练的分类器(准确率超过 92%)剔除与微观模拟无关的片段 34,318 个;
- 用 OpenCV 检测黑边、用 EasyOCR 检测字幕,分别剔除 6,694 个和 14,647 个片段;
- 专家审核后,再剔除 2,593 个无意义或物理上不一致的片段。
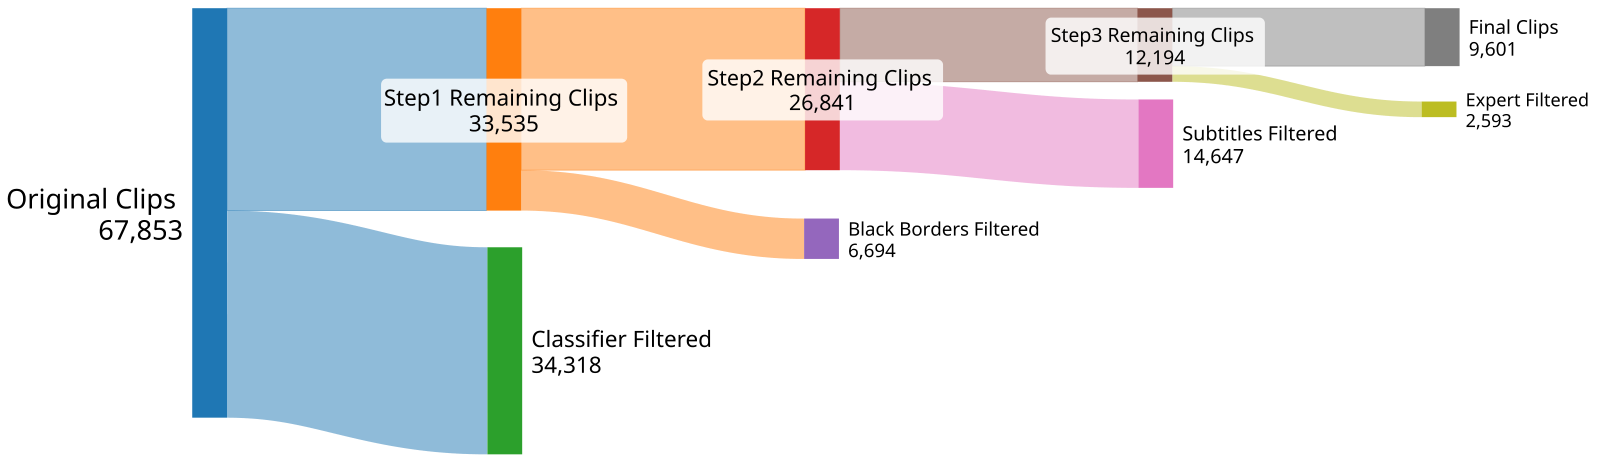 图 4:MicroSim-10K 的数据过滤流程,从 67,853 个原始片段中筛出 9,601 个(图源:论文)
最终的 MicroSim-10K 包含 9,601 段专家验证的视频片段,每段 5 至 60 秒。每段视频由 GPT-4o 结合均匀采样的 8 帧画面和原视频的标题、简介生成平均约 150 词的描述,并经专家核验。为排除数据泄漏,研究者在视频 ID、文本和画面三个层面做了去重;进一步剔除 14 个可能相近的评测任务后,MicroVerse 的平均分从 50.2 变为 50.0,基本不受影响。
模型方面,MicroVerse 以 Wan2.1-T2V-1.3B 为基座,在 8 张 NVIDIA H200 GPU 上用 MicroSim-10K 全参数微调 5,000 步,生成 480×832 分辨率、81 帧的视频;训练时以 10% 的概率丢弃文本条件,以支持无分类器引导(CFG)。
实验结果:科学保真度领先所有参评开源模型
在 MicroWorldBench 上,MicroVerse-1.3B 的科学保真度为 43.0,比基座 Wan2.1-T2V-1.3B(40.3)高 2.7 分,也高于参数更多的 Wan2.1-T2V-14B(42.7),在所有参评开源模型中最高;在极具挑战的亚细胞级任务上得到 53.3 分,与 Wan2.2-T2V-A14B 并列开源模型第一。代价是视觉质量(71.8 降至 68.5)和指令遵循(50.1 降至 49.3)略有下降,论文认为这不影响提升科学保真度这一核心目标。与商业模型相比仍有明显差距:Veo3 的科学保真度为 65.7。
针对小模型提升有限、视觉质量略降的问题,研究者进一步扩大模型规模,并混入等量的通用高质量视频(从 OpenVid 随机采样)一起训练:
| 基座模型 | 训练数据 | 科学保真度 | 视觉质量 | 指令遵循 |
|---|---|---|---|---|
| Wan2.1-1.3B | 不微调 | 40.3 | 71.8 | 50.1 |
| Wan2.1-1.3B | MicroSim-10K | 43.0 | 68.5 | 49.3 |
| Wan2.1-1.3B | 通用数据 + MicroSim-10K | 44.1 | 74.4 | 53.8 |
| Wan2.1-14B | 不微调 | 42.7 | 86.0 | 53.8 |
| Wan2.1-14B | MicroSim-10K | 45.4 | 82.7 | 51.4 |
| Wan2.1-14B | 通用数据 + MicroSim-10K | 48.3 | 87.7 | 56.9 |
表中数据来自论文表 4。可以看到,“扩大模型 + 混合数据”让 14B 模型的科学保真度提升到 48.3(较基座提高 5.6),视觉质量和指令遵循也同步提高,论文称其在开源模型中达到最优水平。
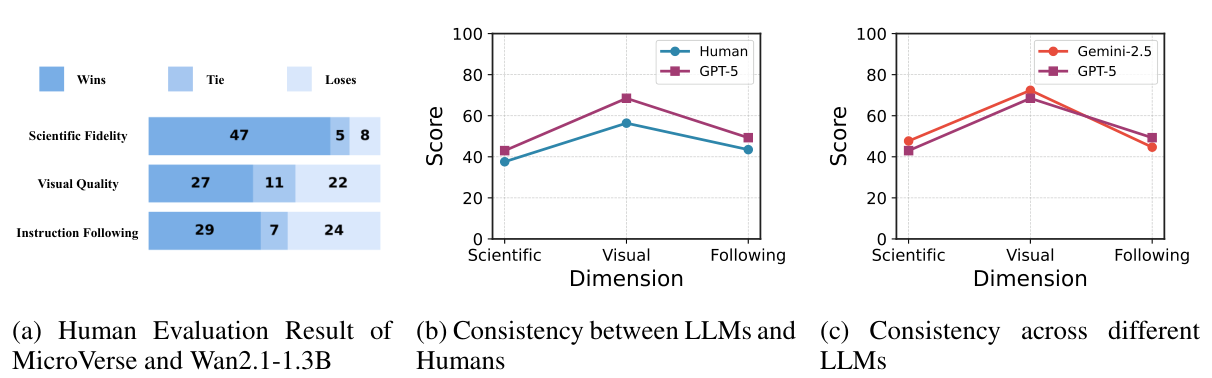 图 5:(a)MicroVerse 与基座 Wan2.1-1.3B 的人类评测胜负结果;(b)(c)LLM 裁判与人类、不同 LLM 裁判之间的打分一致性(图源:论文)
人类评测也印证了这一点。研究者构建了覆盖三个层级的 60 组样本(每个层级 20 组),将模型输出随机打乱后,由三位评测者在 MicroVerse 与基座 Wan2.1-1.3B 之间选择更好的一方或判为平局。在科学保真度上,MicroVerse 胜出 47 组、持平 5 组、落后 8 组;三位评测者两两之间的一致性系数 Cohen's κ 为 0.81 至 0.87。
消融实验也说明了数据质量的作用:用未经清洗的原始数据(34,318 个片段)微调,科学保真度为 42.1、指令遵循为 44.5;改用清洗后的 9,601 个片段,两项分别为 43.0 和 49.3,数据更少,效果更均衡。
意义与展望
论文称,这是首次提出“微观世界模拟”的概念,并以明确的目标、专门的评测基准、训练数据和定制模型构成完整的概念验证,有望用于生物学研究、教育和科学可视化。
作者也明确了边界:当前方法还没有显式引入支配微观动力学的物理规律,如血流中的流体力学、分子输运中的扩散—反应方程、细胞过程中的生物力学约束,因此尚不适用于需要高精度科学模拟和预测的场景;评测任务目前取材于 YouTube,后续计划引入专业显微成像数据库扩展评测范围。
目前,MicroWorldBench 评测代码与 MicroVerse 训练代码已在 GitHub 开源,约 9.6k 条样本的数据集已在 Hugging Face 发布。
团队介绍
- 蔡镇阳(Zhenyang Cai):论文第五作者,署名单位为香港中文大学(深圳)。他是香港中文大学(深圳)博士研究生、自由动脉 CTO,负责多模态医疗模型研发,参与过 HuatuoGPT-o1、DentalGPT 等模型的研发,并以第一作者身份在 NeurIPS、ACL 发表论文。
- 王本友:论文通讯作者,香港中文大学(深圳)数据科学学院助理教授、博士生导师,自由动脉首席 AI 科学家。
- 论文共同第一作者为 Rongsheng Wang 与 Minghao Wu,其他作者包括 Hongru Zhou(北京协和医院)、Zhihan Yu 和 Junying Chen。论文署名单位为香港中文大学(深圳)、北京协和医院和深圳河套学院。